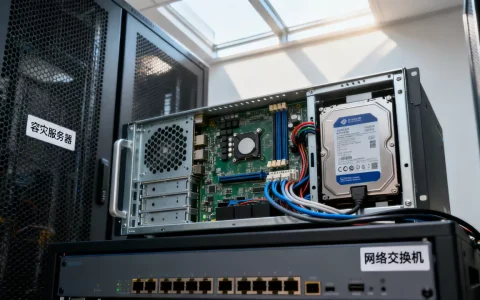
分布式数据分析是将海量数据分散到多个节点并行处理,以此突破单机性能瓶颈,实现秒级响应的分析架构,它并非一个具体工具,而是一套解决大数据难题的体系,关键在于选对框架、算清成本、匹配业务场景。参考2
分布式数据分析与集中式分析哪个更值得选
并行处理能力是关键差异
集中式分析把所有数据拉到一台服务器上计算,数据量一过TB级别,磁盘I/O和内存就成了死穴。分布式数据分析则把数据切成小块,分发到几十甚至上百台廉价机器上同时算,最后汇总结果,行业共识认为,数据量超过5TB后再用单机跑聚合查询,响应时间会成倍增长,而分布式架构通过横向扩展节点,可以线性降低延迟。
举个例子,电商大促期间需要计算全站实时销售额,集中式分析可能卡死在Join操作上,分布式方案用MapReduce或Spark在分钟内就能出报表。并行粒度决定了你能扛住多少并发查询,集中式方案哪怕配上SSD和高端CPU,也无法在成本可控的前提下应对实时流数据。
成本与扩展性权衡
集中式方案前期硬件投入低,但后期扩展昂贵;分布式方案初期需要搭建集群,但后续加节点成本远低于换大型机。分布式数据分析与集中式分析哪个更划算,关键看数据增长曲线,如果月增量稳定在10%以内,集中式还能撑一两年;若年增长率超过50%,分布式架构才是长期省钱的解。
- 集中式:适合数据量<5TB、查询频率低、预算有限的团队。
- 分布式:适合数据量>10TB、需要实时分析、业务增长快的企业。
业内专家指出,混合部署是当前主流核心业务走分布式,边缘场景用集中式兜底,可以平衡成本与性能。
搭建分布式数据分析平台到底要花多少钱
开源方案与商业授权的成本拼图
分布式数据分析平台价格没有统一标价,它取决于你选择开源生态还是商业授权,开源方案如Hadoop、Spark、Flink,软件本身免费,但人力配置和运维成本不低,一个3节点集群,用云服务器大概每月3000元
 参考2
起步,但如果自己买物理机,加上机房、电费、带宽,首年投入可能超过10万元。
商业授权方案如Cloudera、Databricks、简米云EMR,按节点或按运算量收费,以Databricks为例,单节点每小时约5元,但表自动优化、安全审计等功能可节省2-3个运维人力。大多数企业会选择混合模式:基础存储用HDFS,调度层用商业版,这样既控制了前期的分布式数据分析平台价格,又保证了稳定性。
影响价格的三大因素
- 节点数量:3节点起步,10节点才能跑通复杂ETL,每增加一个节点,成本按比例上升。
- 存储介质:全SSD集群比HDD贵50%以上,但如果做实时分析,机械硬盘的延迟无法接受。
- 数据规模:上PB后,多副本和跨机房备份会吃掉大量资源,相当一部分预算花在冗余上。
实操建议:先做数据量预估,用TCO计算器(如AWS TCO Calculator)跑一遍,再把运维成本按人头折算进去,很多团队踩过的坑是:只看软件授权费,忽略了运维工程师的工资一个熟练的Hadoop运维月薪普遍在2万元以上。
分布式数据分析工具有哪些值得选
主流工具横向对比
| 工具 | 适用场景 | 学习曲线 | 典型成本 |
|---|---|---|---|
| Apache Spark | 批处理、流处理、机器学习 | 中等 | 开源免费,集群运维成本高 |
| Apache Flink | 实时流计算、毫秒级延迟 | 中高 | 开源免费,专业支持需付费 |
| Presto / Trino | 交互式查询、SQL on Hadoop | 较低 | 开源免费,需对接Hive或HDFS |
| Databricks | 全托管Spark+ML | 低 | 按节点/时间收费,存算分离 |
| ClickHouse | 列式存储、实时分析 | 低 | 开源免费,商业版有技术支持 |
分布式数据分析工具对比时,优先看自己的数据源类型和查询模式,如果业务以SQL为主,Presto或ClickHouse上手最快;如果涉及复杂图计算,Spark GraphX是唯一选择。
行业共识是:流处理场景直接上Flink,批处理用Spark,不想管运维就选Databricks。参考2
选型实操步骤
- 明确业务需求:写清楚每天的实时数据量、查询并发数、最大可接受延迟。
- 技术摸底:团队里有没有人懂Java/Scala,懂分布式原理?没有的话,优先选Spark DS或Flink Table API,因为SQL接口更友好。
- 小规模POC:用3节点集群跑一个月的真实业务数据,测试读写性能、稳定性、运维复杂度。
- 评估扩展性:模拟未来半年数据量翻倍,看工具能否线性扩展,是否存在瓶颈节点。
多数情况下,选社区活跃、文档齐全的工具能少踩坑,比如Spark的Stack Overflow问题量超过10万,配套生态成熟,找人容易。
分布式数据分析怎么应用到具体业务
电商大促的实时分析
一家头部电商平台在双11期间,需要实时追踪每秒成交额、热门品类、库存预警,他们用Flink消费Kafka交易日志,写入ClickHouse,再通过Grafana展示,整个过程从数据产生到刷新看板,延迟控制在10秒以内,如果改用传统SQL压单库,高并发会把数据库直接打崩。
实操路径:数据源(Kafka/日志)→ Flink清洗+聚合 → ClickHouse/Doris存储 → BI看板触发告警,关键步骤是数据分桶,按用户ID或品类拆分成不同分区,避免热点冲突。
金融风控的毫秒级响应
银行的反欺诈系统需要在交易发生时,几毫秒内判断是否拦截。分布式数据分析在这里表现为流式规则引擎,每笔交易的特征向量在毫秒级完成与历史数据的相似度计算,Spark Streaming或Flink CEP可以处理每秒数万条数据,同时维持亚秒级延迟。相当一部分银行在风控层使用分布式架构,因为单机无法在超时前完成复杂模型推理。
注意点:金融场景必须保证Exactly-Once语义,所以消息队列推荐Kafka,结合Flink的Checkpoint机制,确保数据不丢不重。
分布式数据分析适合哪些企业
不是所有公司都需要分布式。分布式数据分析场景有哪些?通常满足以下条件之一:
- 单日新增数据量超过10GB,且未来会持续增长。
- 查询响应时间超过30秒,且经常超时。
- 多部门需要跑不同的分析任务,存在资源争抢。
- 业务要求实时或近实时分析,比如大屏监控、风控拦截。
对于数据量在100GB以下、查询频率低、团队没有专职运维的小公司,集中式方案依然更划算,分布式是解决大问题的工具,不是噱头。
分布式数据分析的核心是”用廉价的并行替代昂贵的串行”,选对工具、算清成本、匹配场景,才能让这套架构真正产生价值,它不是万能药,但面对数据洪流,它是目前唯一被验证可行的路径。
分布式数据分析常见问题解答
分布式数据分析一定要用Hadoop吗?
Hadoop是分布式生态的基石,但不是唯一选择,如果业务偏实时流处理,Flink+消息队列也能搭建分布式分析链路;如果只想做SQL查询,Presto或ClickHouse可以不依赖HDFS。多数情况下,HDFS被用作底层存储,但云厂商的对象存储(S3、OSS)可以替代HDFS,减少运维成本。
分布式数据分析平台怎么选才划算?
先判断数据量级和增长趋势,再计算TCO,如果数据量<10TB且增速慢,商业版全托管方案(如Databricks、简米云EMR)更省心;如果数据量大且团队有技术能力,开源方案(Spark+HDFS+ClickHouse)长期成本更低。关键是算上运维人力成本,很多企业花了三年才发现集群维护费比预期高出一倍。
分布式数据分析对程序员要求高吗?
入门门槛在降低,主流工具都支持SQL和Python接口,但理解分区、Shuffle、容错等概念仍然需要一定基础,如果有团队带,基础SQL就能跑通离线分析;如果要自己运维集群,需要掌握Linux调优、JVM参数、网络配置。最快的学习路径是先在云上开一个Spark集群,跟着官方例子跑一遍TPC-H测试,再结合实际业务改代码。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/525921.html