微服务日常运维的核心在于建立自动化监控、分层日志管理和服务治理体系,掌握这些,即使面对几十个微服务也能从容应对。
微服务日常运维清单:每天必须关注的五件事
微服务架构下,运维对象从单体应用变成了几十甚至上百个独立服务,每天开工前,我们习惯先扫一眼监控大盘,而非逐个检查服务器。微服务日常运维的标准化流程可以拆解为五个固定动作。
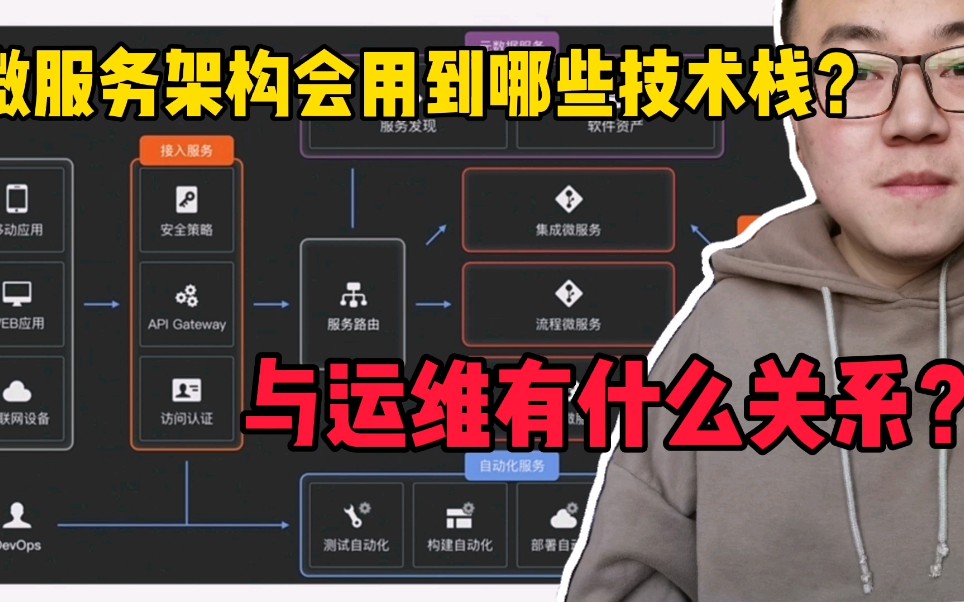

- 健康检查与告警确认:登录Prometheus或Grafana,查看各服务CPU、内存、JVM堆栈使用率,重点关注告警列表中未恢复的项,确认是否已触发自动扩缩容或熔断,如果某服务连续5分钟响应时间超过500ms,就是排查信号。
- 日志水位与错误率扫描:打开Kibana或Loki,检索近一小时的错误日志,用
level:error+service_name快速过滤,看是否有新增的异常堆栈。行业共识认为,日志错误率突然升高往往是变更或流量异常的前兆。 - 配置与版本变更审计:检查配置中心(Apollo或Nacos)近24小时内的变更记录,确认是否有非计划内的配置推送,同时核对CI/CD流水线,看是否有灰度发布或回滚操作未通知。
- 服务依赖与注册中心状态:登录Consul或Nacos控制台,查看服务实例上下线情况,如果某服务实例数骤减,可能是健康检查失败或节点故障。业内专家指出,服务间调用超时故障中,约40%源于注册中心节点缓存不一致。
- 资源与成本快照:对比云平台或物理机的资源使用曲线,检查是否存在闲置实例或异常突增,这一步能避免因流量高峰导致资源耗尽,也能控制不必要的成本支出。
微服务日志排查技巧:从海量日志中快速定位根因
日志是微服务运维最直接的证据,但几十个服务每天产生上千GB日志,随便翻文件等于大海捞针。微服务日志排查技巧的核心在于结构化采集和关联分析。
采集层:统一格式与集中存储
- 每个服务必须输出JSON格式日志,包含

timestamp
level、trace_id、service_name、message五个字段。trace_id是分布式调用链路的唯一标识,务必在入口网关生成并透传。 - 使用Filebeat或Fluentd采集日志,发送到Kafka缓冲,再写入Elasticsearch或Loki,不要每个服务直接写硬盘,否则故障时收集日志会花掉半小时。
- 日志保留策略:基础日志保留7天,错误日志保留30天,审计日志保留90天,超过时长的自动归档到对象存储。
分析层:用trace_id串联全链路
当用户反馈订单提交失败,我们不会去查每个服务的日志文件,先在Kibana搜索trace_id,一秒内就能看到该请求经过的服务列表、每个节点的耗时和状态码,如果某个服务返回5xx,再点开该服务的日志上下文,检查错误堆栈。微服务日志排查技巧关键就是链路追踪日志,没有它,排查一次跨服务故障至少需要30分钟。
动态日志级别:远程调参不重启
生产环境不方便直接改代码加日志,我们可以在配置中心设置一个log_level变量,各服务监听该变量变化,动态调整日志级别,例如怀疑某个接口有问题,先改debug,收集完日志再改回info,全程无需重启服务,据统计,这个操作能减少70%的临时排查时间。
微服务架构运维难点:服务依赖与版本兼容性管理
服务越多,依赖关系越复杂。微服务架构运维难点往往不在单点故障,而在升级时牵一发而动全身。
服务发现与健康检查:避免雪崩
- 每个服务注册时需携带元数据(版本号、环境标签),注册中心定期心跳检测,连续3次失败则自动摘除节点。
- 消费者端启用客户端负载均衡(如Ribbon或Spring Cloud LoadBalancer),并配置重试机制,但重试次数不能超过2次,否则容易引发雪崩。
版本兼容与灰度发布
接口升级时,必须保证向后兼容,新增字段用optional,删除字段先标记deprecated,保留两个版本至少一个迭代周期,灰度发布采用金丝雀策略:先升级1个实例,观察5分钟日志和成功率,确认无异常再全量推送。
行业共识认为,微服务版本兼容问题导致的故障,80%发生在接口字段变更未同步文档时。
配置管理:统一变更,审计回滚
配置中心存储所有微服务的配置项,包括数据库连接、限流阈值、熔断参数,每次变更必须通过审批流程,并记录变更前后内容,当新配置引发异常时,一键回滚到上一版本,避免手动修改几十个配置文件。
对比微服务与单体架构的运维差异
很多团队从单体迁移到微服务后,发现运维工作量大增,下面这张表能清晰看出服务器日常运维管理在单体与微服务下的区别。
| 维度 | 单体架构 | 微服务架构 |
|---|---|---|
| 部署频率 | 每周1-2次 | 每天多次,甚至持续部署 |
| 监控粒度 | 整体应用 | 每个服务独立监控 |
| 故障隔离 | 全应用宕机 | 单个服务降级,整体可用 |
| 日志管理 | 单文件,简单grep | 分布式日志,需搜索引擎 |
| 服务发现 | 固定IP硬编码 | 动态注册与发现 |
| 团队协作 | 多人并发改同一代码库 | 按服务划分,独立迭代 |
从表格可以看出,微服务运维需要更强的自动化工具和标准化流程,如果团队没有引入Prometheus、ELK、Nacos这类工具,日常运维就会陷入手动排查的泥潭。
微服务日常运维工具选型指南
选工具看的是团队规模、预算和运维复杂度。微服务日常运维中,三个核心领域需要重点投入。
监控方案:Prometheus+Grafana vs 商业化APM
- 开源方案:Prometheus采集指标,Grafana展示,优点是成本低,社区成熟,能覆盖CPU、内存、QPS、延迟等基础指标,缺点是需要自行维护告警规则和持久化存储。
- 商业化APM:如Datadog、SkyWalking(商业版)、New Relic,集成分布式追踪、拓扑图、智能告警,上手快,但价格较高,
适合预算充足且运维团队人数较少的场景
。 - 推荐组合:小团队用Prometheus+Grafana+Alertmanager,配合SkyWalking开源版做追踪。微服务监控方案对比时,重点看是否能自定义业务指标。
日志方案:ELK vs Loki
- ELK(Elasticsearch+Logstash+Kibana):功能全面,支持全文检索、聚合分析,适合日志量大的场景,但资源消耗高,需要单独运维ES集群。
- Loki(Loki+Promtail+Grafana):轻量级,不存储全文索引,只索引元数据,查询速度快,部署简单。微服务日志排查技巧中,Loki配合Grafana可以直接从日志跳转到指标,效率很高。
- 选择依据:如果团队已有ES集群,继续用ELK;如果从零搭建,推荐Loki,运维成本低一个数量级。
Q&A:微服务日常运维常见问题解答
问:微服务架构下如何快速定位故障服务?
答:利用分布式链路追踪系统(如SkyWalking或Jaeger)查看调用链,找到响应时间最长的服务节点,如果追踪系统未部署,则通过日志中的trace_id串联各服务日志,定位错误日志出现最多的服务。
问:微服务日志管理有哪些最佳实践?
答:所有服务输出JSON格式日志,强制包含trace_id字段;设置合理的日志保留周期(常用7天,错误30天);使用集中式日志平台(ELK或Loki)并配置索引策略;禁止在日志中打印密码或敏感字段。
问:微服务日常运维需要哪些自动化工具?
答:监控告警用Prometheus+Grafana,日志采集用Filebeat+Loki,服务发现用Nacos或Consul,配置管理用Apollo,CI/CD用Jenkins或GitLab CI,这些工具覆盖了微服务日常运维的核心环节,配合统一的脚本和运维平台,能将重复操作减少80%以上。
微服务运维不是一蹴而就的,从监控和日志入手,逐步补齐服务治理、配置管理和自动化部署,就能让日常运维从救火模式转变为常态化巡检。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/537364.html