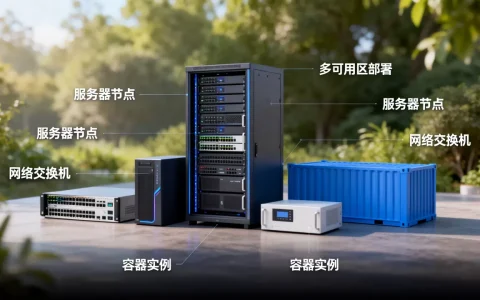
分布式数据库集成原理,本质是通过数据分片、复制、事务协调等机制,将多台独立服务器组合成一个逻辑统一的数据库系统,同时无缝对接现有应用与中间件,实现高可用、高扩展和强一致的数据服务。
分布式数据库核心原理:分片、复制与一致性
分布式数据库并非简单地把数据分散存储,而是一套精密协作的系统,理解其核心原理,是做好集成的前提。


分布式数据库CAP理论详解:一致性与可用性的权衡
CAP理论是分布式系统的基石,它指出一个分布式数据库无法同时满足强一致性(Consistency)、可用性(Availability)和分区容错性(Partition tolerance),在实际集成中,我们必须在一致性和可用性之间做出取舍。
- CP系统:优先保证一致性和分区容错,牺牲部分可用性,例如HBase、ZooKeeper,当网络分区发生时,系统会拒绝部分请求以保证数据不脏读,适合金融账务、库存扣减等场景。
- AP系统:优先保证可用性和分区容错,牺牲强一致性,例如Cassandra、DynamoDB,网络分区时,所有节点仍可读写,但可能读到旧数据,后续通过反熵修复,适合社交动态、日志分析等容忍最终一致性的场景。
- BASE理论:对CAP的工程化妥协,追求基本可用(Basically Available)、软状态(Soft state)和最终一致性(Eventual consistency),多数分布式数据库集成时,会采用BASE模型,结合业务柔性事务,实现数据最终一致。
集成时,我们需要明确业务对各数据操作的一致性要求,然后选择或配置对应的数据库策略,用Spring Cloud Alibaba集成Seata,通过AT模式或TCC模式实现分布式事务,就是一种典型的CP与AP折中实现。
数据分片与复制:让数据分布有章可循
分布式数据库的核心工作就是分片(Sharding)和复制(Replication),分片决定数据如何切分到不同节点,复制决定每个分片的数据冗余度。
分片策略通常有三类:
- 范围分片:按某个字段的值范围划分,如用户ID 1-1000在节点A,1001-2000在节点B,优点是扩容简单,但容易出现热点。
- 哈希分片:对分片键做哈希计算后取模分配,数据分布均匀,但扩容时需要大量数据迁移,主流方案如一致性哈希能缓解该问题。
- 列表分片:按业务维度明确划分,如按地区、业务线,灵活但不够通用。
复制模式常见两种:
- 主从复制:一个主节点处理写请求,从节点同步数据并分担读请求,优点是读写分离,缺点是有复制延迟,且主节点故障时需要切换,MySQL Group Replication、Redis Sentinel都是此模式。
- 多主复制:多个节点均可写,并相互同步,优点是去中心化、高可用,但需要处理写冲突,如Cassandra的多主模型。
实际集成时,分片键的选择直接决定性能上限,例如电商系统选用户ID哈希分片,订单查询可路由到指定节点,但按商品ID查询则需要跨节点聚合,所以通常需要建立二级索引或使用全局索引组件。

分布式事务与一致性协议:跨节点操作的保障
当一笔业务操作涉及多个分片或多个服务时,分布式事务就成为必须解决的问题,经典的协议有两阶段提交(2PC)、三阶段提交(3PC)以及TCC(Try-Confirm-Cancel)。
- 2PC:协调者先询问所有参与者是否准备好,收集到“就绪”后,再发出提交指令,缺点:同步阻塞、协调者单点故障后可能造成悬挂事务,MySQL XA事务就是2PC实现。
- TCC:将业务操作拆分为Try、Confirm、Cancel三个接口,由业务代码实现,Try阶段预留资源,Confirm阶段确认执行业务,Cancel阶段释放资源,灵活但侵入性强。
- Saga模式:将长事务拆分为多个本地事务,每个本地事务有对应的补偿操作,按顺序执行,失败则逆序补偿,适合微服务集成,Apache Seata支持Saga模式。
在分布式数据库集成中,我们往往借助中间件(如Seata、DTX)来透明化事务管理,避免业务代码直接调用XA接口,许多NewSQL数据库(如TiDB、CockroachDB)通过Percolator模型或Raft协议在内部实现了ACID事务,对应用层屏蔽了分布式事务的复杂性。
分布式数据库集成原理:从中间件到原生分布式
理解了核心原理,我们来看集成原理,集成方案总体分为两类:基于中间件的分库分表模式和原生分布式数据库模式,两者原理不同,落地路径也大相径庭。
中间件集成模式:ShardingSphere与MyCat的实践
在传统单机数据库(如MySQL)遭遇性能瓶颈时,引入中间件进行分库分表是最常见的集成方案,这类中间件代理了所有SQL请求,根据分片规则路由到后端多个数据库实例,并对结果进行归并。
以ShardingSphere为例,它提供JDBC驱动模式,应用直接引入jar包,配置分片规则即可,无需额外部署代理,性能损耗低,但对应用有语言绑定,配置示例(YAML):
rules:
- !SHARDING
  tables:
    t_order:
      actualDataNodes: ds_${0..1}.t_order_${0..1}
      tableStrategy:
        standard:
          shardingColumn: order_id
          shardingAlgorithmName: order_inline
      keyGenerateStrategy:
        column: order_id
        keyGeneratorName: snowflake
  shardingAlgorithms:
    order_inline:
      type: INLINE
      props:
        algorithm-expression: t_order_${order_id % 2}
该配置定义了t_order表按order_id哈希分片,分布在两个数据源各两个表中,集成时,应用只需替换数据源,DAO层代码无需修改。
MyCat则是代理模式,作为独立中间件部署,应用把MyCat当作MySQL连接即可,它支持读写分离、分库分表、全局序列等,但代理层会引入额外网络延迟,且需要维护高可用。
中间件集成模式的优势在于对现有系统侵入小,开发成本低,很多企业就是从单库升级到分库分表起步,但问题是,后期运维复杂度高,扩容缩容操作繁琐,且跨分片SQL性能受限,行业共识认为,对于新系统或大型重构项目,原生分布式数据库是更优选择。
企业级分布式数据库集成方案:从评估到落地

对于企业级项目,集成方案不能仅停留在技术选型,还需考虑组织架构、流程规范、容灾级别等,一个完整的集成方案通常包含以下步骤:
- 需求评估:明确业务QPS、数据量、增长趋势、一致性要求、AP/TP混合负载等,可以用sysbench或tpcc-mysql工具进行基准测试,模拟真实负载。
- 技术选型:根据CAP偏好、团队技术栈、运维能力,在中间件方案(ShardingSphere+MySQL)、原生分布式方案(TiDB、OceanBase、GaussDB)、云原生方案(Amazon Aurora、Google Spanner)之间决策,如果团队MySQL经验丰富,且能接受分片规则,中间件方案成本最低;如果追求长期弹性,原生方案更合适。
- 架构设计:定义分片键、复制因子、数据分区策略、二级索引方案;设计全局唯一ID生成器(如Snowflake、Leaf);规划数据迁移与回滚预案。
- 开发集成:改造应用层,使用Seata等分布式事务框架,替换数据源,配置读写分离,处理跨分片排序、聚合等特殊逻辑,对于复杂的跨分片查询,可引入Elasticsearch或ClickHouse作为查询引擎。
- 测试与演练:进行全链路压测,验证数据一致性、故障恢复时间(RTO)、数据丢失量(RPO),并模拟机房断电、网络分区等极端场景。
- 上线与监控:使用Prometheus+Grafana监控集群状态,设置慢查询告警,建立数据巡检机制,定期检查数据一致性。
分布式数据库与传统数据库的区别及选型对比
很多开发者经常问“分布式数据库和传统数据库的区别是什么”,这里从架构、性能、运维三个维度来对比,帮助选型。
架构对比:从单机到集群的思维转变
传统关系型数据库(如Oracle、MySQL单机)架构为垂直扩展,依靠提升单机CPU、内存、磁盘来支撑更大负载,而分布式数据库为水平扩展,通过增加机器节点线性提升性能。
- 单机数据库:共享存储或本地磁盘,依赖主备切换实现高可用,瓶颈在于单机资源上限,且扩展停机时间长。
- 分布式数据库:计算与存储分离,无共享架构(Shared-Nothing),数据分片分布,可随时在线扩容,高可用通过多副本自动切换实现。
性能与扩展性对比
在OLTP场景下,单机数据库在数据量小于500GB时,经过优化后性能可能优于分布式数据库,因为避免了分布式事务和网络开销,但当数据量增长到TB级别,单机数据库查询性能断崖式下跌,而分布式数据库通过分片并行处理,吞吐量随节点数近似线性增长。
在OLAP场景,传统数据库通常需要借助ETL到数据仓库,而分布式数据库如TiDB的TiFlash列存引擎,可直接在集群内实现HTAP,避免了数据搬运。
运维复杂度对比
分布式数据库的运维复杂度明显高于单机数据库,单机数据库备份恢复简单,分布式数据库需要全局一致性备份,涉及多节点协调,故障排查时,分布式数据库的追踪链路更长,需要掌握分布式追踪工具(如Jaeger),这也是为什么很多中小规模业务仍坚持单机数据库加上缓存、读写分离的原因。

分布式数据库集成实践:命令与操作清单
为了让集成过程更直观,下面给出一些可执行的命令示例,这些命令基于Linux环境、TiDB和ShardingSphere的常见操作。
环境准备(TiDB):
# 安装tiup
curl --proto '=https' --tlsv1.2 -sSf https://tiup-mirrors.pingcap.com/install.sh | sh
# 启动本地测试集群
tiup playground --host 0.0.0.0
数据迁移(从MySQL到TiDB):
# 导出数据
dumpling -h 127.0.0.1 -P 3306 -u root -p'password' -o /tmp/backup
# 导入数据
tidb-lightning -config tidb-lightning.toml
ShardingSphere-Proxy部署:
# 下载并解压
wget https://archive.apache.org/dist/shardingsphere/5.3.1/apache-shardingsphere-5.3.1-shardingsphere-proxy-bin.tar.gz
tar -zxvf apache-shardingsphere-5.3.1-shardingsphere-proxy-bin.tar.gz
# 修改配置conf/server.yaml,设置分片规则
# 启动
bin/start.sh
应用集成配置示例(Spring Boot + ShardingSphere JDBC):
spring.shardingsphere.datasource.names=ds0,ds1
spring.shardingsphere.datasource.ds0.url=jdbc:mysql://host1:3306/db
spring.shardingsphere.datasource.ds1.url=jdbc:mysql://host2:3306/db
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=ds$->{0..1}.t_order_$->{0..1}
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_id
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=order-hash-mod
这些命令和配置可以直接用于验证环境,帮助读者快速上手。
分布式数据库集成并非简单套用模板,而是需要根据业务特征、数据规模、团队能力综合权衡。抓住CAP理论、分片策略、事务模型这三条主线,在任何集成方案中都能找到清晰的路径。
Q&A相关问题
分布式数据库和传统数据库的区别是什么?
主要区别在于架构和扩展性,传统数据库是单机或主备模式,垂直扩展,当数据量过大时性能骤降;分布式数据库采用分片和多副本,支持水平扩展,理论性能近乎线性增长,同时具备原生高可用和弹性伸缩能力,但运维复杂度也相应提高,需要额外处理分布式事务、数据一致性、跨节点查询等。
分布式数据库集成原理包括哪些步骤?
集成原理核心包括数据分片规则定义、复制策略选择、分布式事务协调、与现有应用中间件对接,具体步骤一般分为:需求评估、技术选型、架构设计、开发集成、测试演练、上线监控,对于基于中间件的集成,重点是配置分片规则和读写分离;对于原生分布式数据库,重点是数据迁移和应用连接切换。
分布式数据库怎样保证数据一致性?
分布式数据库通过多种一致性协议保证数据一致性,强一致性场景下,使用Raft或Paxos共识算法,确保多数派写入成功后才返回成功,如TiDB的Raft协议,弱一致性场景下,采用最终一致性模型,通过版本向量、读修复、反熵机制等,在后台异步修复不一致数据,业务层也可结合分布式事务框架(如Seata)实现跨服务的事务一致性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/563517.html