构建Spring Cloud微服务工程时,选择iBatis(MyBatis)作为持久层框架并配置MySQL数据库,核心在于通过Spring Boot的自动配置机制,结合连接池优化与映射管理,实现高效的数据访问层集成。 接下来我将从项目初始化、数据源配置、持久层映射到事务管理,梳理一套可复用的配置方法。
Spring Cloud整合MyBatis:MySQL数据库配置完整指南
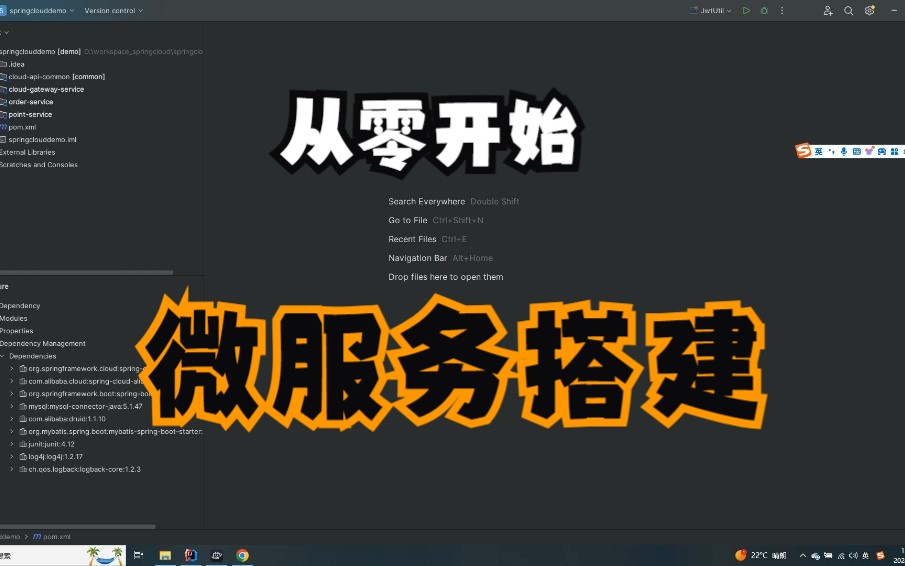
初始化Spring Cloud项目骨架
使用Spring Initializr或IDE内置工具生成项目,选择Spring Cloud版本(如2026.0.x),在依赖选择界面添加Web、MySQL Driver,并准备后续手动引入MyBatis,生成后,在pom.xml中替换或添加MyBatis和连接池依赖。
添加核心依赖包
在pom.xml中,确保包含以下依赖(以Maven为例):
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jdbc</artifactId>
</dependency>
<dependency>
    <groupId>org.mybatis.spring.boot</groupId>
    <artifactId>mybatis-spring-boot-starter</artifactId>
    <version>3.0.3</version>
</dependency>
<dependency>
    <groupId>com.mysql</groupId>
    <artifactId>mysql-connector-j</artifactId>
    <scope>runtime</scope>
</dependency>
Spring Boot 3.x默认使用HikariCP作为连接池,无需额外引入,如果希望使用Druid,可以添加druid-spring-boot-starter,并替换默认连接池。
项目模块划分建议
在Spring Cloud工程搭建时,数据库配置通常位于每个微服务模块内部,推荐将mapper接口和XML映射文件放在同一包结构下,便于维护。
com.example.userservice
├── controller
├── service
├── mapper
│   ├── UserMapper.java
│   └── UserMapper.xml
└── entity
Spring Cloud工程中iBatis数据源配置与连接池优化
在application.yml中配置数据源
在微服务模块的src/main/resources/application.yml中,添加以下配置:
spring:
datasource:
url: jdbc:mysql://localhost:3306/user_db?useUnicode=true&characterEncoding=utf-8&serverTimezone=Asia/Shanghai&useSSL=false&allowPublicKeyR
etrieval=true
username: dev_user
password: dev_pass
driver-class-name: com.mysql.cj.jdbc.Driver
hikari:
pool-name: UserServicePool
maximum-pool-size: 20
minimum-idle: 5
idle-timeout: 300000
connection-timeout: 20000
max-lifetime: 1200000
data-source-properties:
cachePrepStmts: true
prepStmtCacheSize: 250
prepStmtCacheSqlLimit: 2048

url中需要设置serverTimezone避免时区错误,useSSL在生产环境建议开启,但开发可关闭,HikariCP参数中,maximum-pool-size根据并发量调整,一般不超过20;minimum-idle保持一定空闲连接快速响应;max-lifetime防止连接被数据库关闭后仍使用。
连接池选型对比与场景
| 连接池 | 优势 | 适用场景 |
|---|---|---|
| HikariCP | 轻量、性能极致、Spring Boot默认 | 高并发、低延迟的微服务 |
| Druid | 内置监控、SQL防火墙、扩展性强 | 需要细粒度监控和审计的金融系统 |
| Tomcat JDBC | 与Tomcat深度集成 | 已有Tomcat容器的传统架构 |
行业共识认为,对于大多数微服务场景,HikariCP是首选,因为它的性能损耗极小,且与Spring Boot无缝集成,如果你需要监控数据库连接状态和慢SQL,可以选择Druid。
连接池参数调优实践
根据业务压力测试调整。一个常见的经验是:maximum-pool-size = (核心线程数 (1 + 等待时间/处理时间)) ,但实际需要结合数据库配置。 用户服务平均查询耗时50ms,目标并发2000,则连接池大小可设为2000 (50/1000) = 100,但受数据库连接数限制,通常建议不超过数据库最大连接数的80%。
MyBatis持久层映射配置与事务管理
配置SqlSessionFactory与Mapper扫描
在Spring Boot启动类上添加@MapperScan:
@SpringBootApplication
@MapperScan("com.example.userservice.mapper")
public class UserServiceApplication {
    public static void main(String[] args) {
        SpringApplication.run(UserServiceApplication.class, args);
    }
}
然后在application.yml中指定映射文件位置:
mybatis:
  mapper-locations: classpath:mapper/.xml
  type-aliases-package: com.example.userservice.entity
  configuration:
    map-underscore-to-camel-case: true
    log-impl: org.apache.ibatis.logging.stdout.StdOutImpl

编写XML映射文件
在resources/mapper/目录下创建UserMapper.xml:
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.example.userservice.mapper.UserMapper">
    <resultMap id="BaseResultMap" type="com.example.userservice.entity.User">
        <id column="id" property="id" jdbcType="INTEGER"/>
        <result column="username" property="username" jdbcType="VARCHAR"/>
        <result column="age" property="age" jdbcType="INTEGER"/>
    </resultMap>
    <select id="selectById" resultMap="BaseResultMap">
        SELECT id, username, age FROM user WHERE id = #{id}
    </select>
</mapper>
注意命名空间必须与接口全限定名一致。
声明式事务管理
在Spring Boot主类上添加@EnableTransactionManagement(通常自动配置已启用),然后在Service层需要事务的方法上添加@Transactional:
@Service
public class UserService {
    @Autowired
    private UserMapper userMapper;
    @Transactional(rollbackFor = Exception.class)
    public void updateUser(User user) {
        userMapper.updateUser(user);
        // 其他操作
    }
}
多数据源配置方案
在一些微服务场景中,需要读写分离或连接多个数据库,推荐使用dynamic-datasource-spring-boot-starter,配置如下:
spring:
  datasource:
    dynamic:
      primary: master
      strict: false
      datasource:
        master:
          url: jdbc:mysql://...
          username: ...
          password: ...
        slave:
          url: jdbc:mysql://...
          username: ...
          password: ...
然后在Service方法上使用@DS(“slave”)切换到从库。
常见问题与性能优化
数据库连接超时与拒绝连接
问题现象:应用启动时抛出Cannot create PoolException,或者运行中获取连接超时。排查步骤:检查网络连通性:telnet 数据库IP 3306,检查数据库用户权限,检查连接池参数是否合理,如connection-timeout设置过短。

慢SQL排查
方法:开启MyBatis日志(log-impl: StdOutImpl),在MySQL中开启慢查询日志(set global slow_query_log=1; long_query_time=2;),分析慢查询日志,使用EXPLAIN分析SQL执行计划,添加索引或改写SQL。
连接池泄漏检测
配置:在HikariCP中设置leakDetectionThreshold: 60000(单位毫秒),当连接持有超过该时间未归还,日志会输出警告。最佳实践:结合代码审查,确保每个数据库操作都在finally中关闭连接(使用try-with-resources或确保事务管理正确)。
MyBatis二级缓存配置
在映射文件中添加
通过以上步骤,你可以在Spring Cloud工程中快速配置iBatis/MyBatis与MySQL数据库,实现稳定高效的微服务数据层。核心在于根据业务场景合理设置连接池参数、规范映射文件编写,并做好事务管理。
Q&A:Spring Cloud MyBatis配置常见问题
问题1:Spring Cloud工程中如何配置MyBatis连接MySQL?
在pom.xml中添加mybatis-spring-boot-starter和mysql-connector-java依赖,在application.yml中配置spring.datasource和mybatis相关属性,使用@MapperScan扫描mapper接口,将XML映射文件放在classpath:mapper/目录下。
问题2:iBatis与MyBatis在Spring Cloud中配置有何区别?
iBatis是MyBatis的前身,配置方式类似,但MyBatis支持更多特性如注解、插件等,在Spring Cloud中,使用mybatis-spring-boot-starter可以无缝集成MyBatis,而旧版iBatis需要手动配置SqlMapClient,现代工程建议直接使用MyBatis,因为它更活跃且社区支持好。
问题3:数据库连接池大小如何设置?
连接池大小需要根据并发请求数和数据库处理能力进行压测。一个基准公式:连接数 = (核心线程数 (1 + 等待时间/处理时间))。 但实际建议从较小值(如10-20)开始,逐步增加,同时监控数据库连接数和响应时间,HikariCP官方推荐maximum-pool-size小于等于CPU核数2,但高并发场景可能需适当调高,监控指标中活跃连接数稳定在minIdle和maxPoolSize之间为佳。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/584243.html