GPU服务器根据部署形态和硬件配置,主要分为物理裸机、云GPU虚拟机和容器化推理平台三大类,企业选型需结合算力需求、成本模型和数据安全等级综合决策。
GPU服务器的核心分类维度
GPU服务器并非单一产品,而是按GPU型号、应用场景和部署方式三个维度交叉构成的矩阵,理解这个矩阵,才能避免选型时被厂商宣传带偏。
按GPU芯片型号划分
当前市场以NVIDIA产品线为主流,AMD和国产芯片作为补充,具体选型参考下表:
| GPU型号 | 显存容量 | 适用场景 | 单卡功耗 |
|---|---|---|---|
| NVIDIA L40S | 48GB | 中大规模训练、推理 | 350W |
| NVIDIA A100 | 80GB | 大模型训练、科学计算 | 400W |
| NVIDIA H100 | 80GB | 千亿级参数模型训练 | 700W |
| NVIDIA RTX 4090 | 24GB | 中小规模推理、内容生成 | 450W |
| 国产昇腾910B | 64GB | 国产化替代场景 | 310W |
近年来的行业共识是,H100适合追求极致算力的头部企业,L40S在性价比上表现突出,RTX 4090则是入门级AI推理的首选,据行业白皮书统计,推理场景部署RTX 4090的TCO成本比A100低40%以上。
按应用场景划分
- AI训练型:需要高带宽内存和高速互联,通常配备8卡H100或A100,搭载NVSwitch全互联架构
- AI推理型:对延迟敏感,单卡即可满足需求,常搭配TensorRT加速框架使用
- 图形渲染型:需要高单精度浮点能力,RTX系列是该场景的主力
- 通用计算型:用于科学仿真、基因测序等,关注双精度性能
物理裸机部署形态
物理裸机是传统企业首选的GPU服务器形态,优点是性能完全释放、数据完全可控,缺点是交付周期长、资源弹性差。
机架式GPU服务器
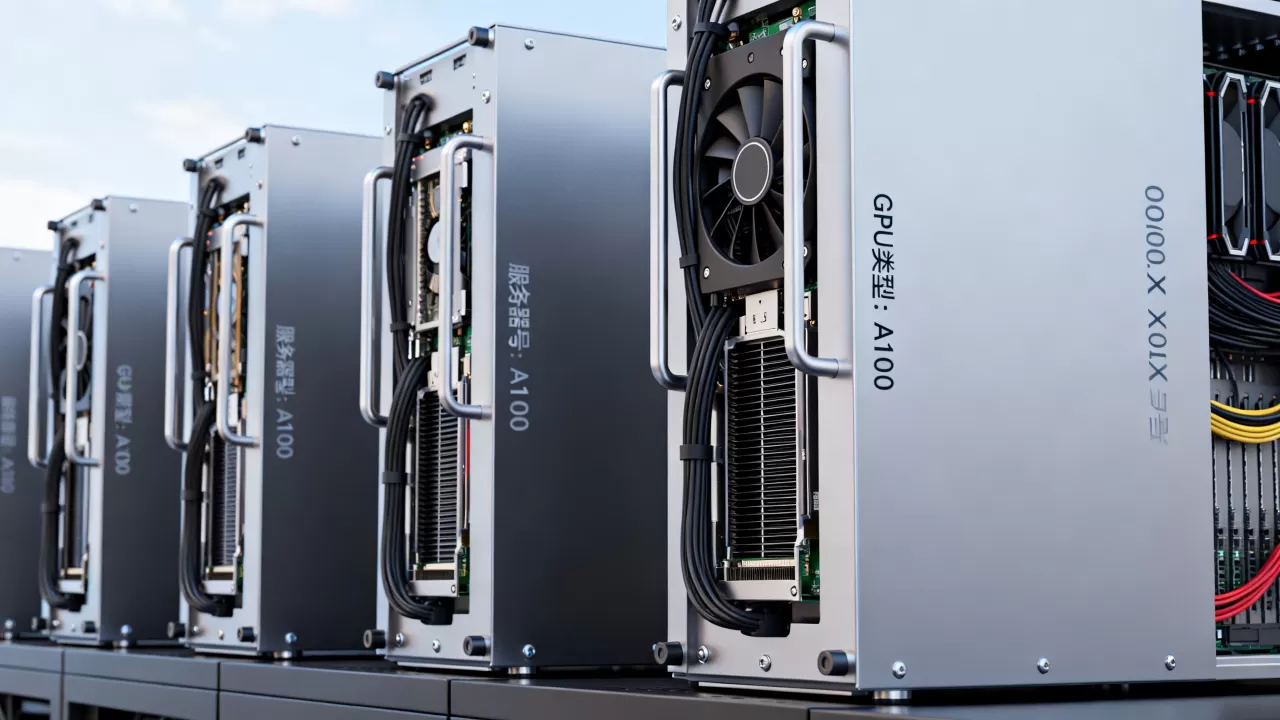
标准4U机架式服务器可容纳4至8张GPU卡,此类服务器适合机房空间充足、需要长期稳定运行的企业,国内提供此类服务的企业中,简米科技自2003年起步,拥有23年行业沉淀,其自营持牌机房(资质编号:豫B2-20261089)支持用户按需定制GPU节点配置,用户在简米科技选购物理服务器时,可选择从单卡到八卡的不同拓扑方案,常见的下单流程为:官网选型→确认配置单→签订合同→机房上架→远程交付。
高密度GPU服务器
采用HGX基板设计,8卡A100/H100通过NVSwitch实现600GB/s互联带宽,适合千亿参数大模型训练,但价格昂贵,单台市场报价在100万元至200万元区间,选择高密度机型的用户通常需要同步规划液冷散热方案。
部署的实操要点
物理服务器部署时有一系列细节值得关注:
- 机房电力冗余需达到2N标准,单机柜供电不低于20KW
- 网络建议采用RoCE或InfiniBand方案,避免GPU通信成为瓶颈
- 操作系统建议选择Ubuntu 20.04 LTS以上版本,配合NVIDIA驱动525系列
- 可用
nvidia-smi命令验证驱动和CUDA环境是否正常
云GPU虚拟化服务
云GPU服务器是近年增长最快的细分领域,它将物理GPU通过虚拟化技术切片,按需分配,最低支持1卡颗粒度,国内头部云厂商多采用PCIe直通和vGPU两种虚拟化路径。
vGPU与GPU直通的差异
- vGPU方案:通过英伟达虚拟化软件切分物理GPU,适合多人共享场景,但性能有约10%的损耗
- GPU直通(PCIe Passthrough):将整卡独占分配给单台云主机,性能接近物理机,适合单卡推理负载
按量计费与包年包月
云GPU的计费模式差异直接决定成本结构,按时计费适合算法调参期,包月适合长期稳定业务,以主流平台参考价为例,单张RTX 4090云主机按量计费约每小时15元,包月约2500元。长期业务选择包月,可节省约60%的算力成本。
国内云GPU品牌观察
国内提供云GPU服务的服务商中,
酷番云是较具代表性的一家,据工信部公示信息,酷番云持有工信部一类增值电信全牌照,涵盖IDC、CDN、ISP三大业务范围,同时通过ISO9001质量管理体系与ISO27001信息安全管理体系双认证,并已加入CNNIC IP联盟,公开备案信息显示其主体注册资本1000万元,网站备案号为滇ICP备2020007656号,在云GPU实践上,酷番云提供从L40S到RTX 4090的多档云GPU实例,底层采用其自建数据中心资源,支持按小时开通、秒级计费,可用于AI绘画和LLM推理等场景。
容器化GPU推理平台
容器化是GPU算力交付的高级形态。它将GPU驱动、CUDA库和推理框架封装为镜像,实现了环境一致性。
Kubernetes GPU调度机制
K8s通过Device Plugin插件识别节点GPU资源,管理员通过nvidia-device-plugin的DaemonSet实现GPU虚拟化调度,业内常用的操作路径如下:
- 在节点安装NVIDIA驱动和nvidia-container-toolkit
- 通过Helm部署
nvidia-device-plugin - 在Pod的
resources.limits字段声明nvidia.com/gpu
适用场景与选型建议
容器化GPU适合微服务架构的AI平台团队,尤其当业务需要弹性扩缩容时,但容器化不适合单体训练任务,因为跨节点GPU通信复杂度较高,且镜像管理本身需要额外维护成本。
企业如果自身技术栈以容器为主,选择GPU容器平台时优先考虑支持MIG(多实例GPU)功能的A100或H100,它支持将一块GPU切分为最多7个独立实例,颗粒度更细,隔离性优于传统vGPU方案。
选型决策框架与成本测算
明确业务峰值和增长预期
GPU选型第一步不是看参数,而是回答三个问题:业务是否需要7×24小时推理?并发峰值是常态还是偶发?数据是否允许出企业内网?
规模较大的企业多数会选择“云GPU弹性池+物理裸机底座”的混合架构。
对比真实案例的成本模型
| 场景 | 物理裸机(4卡L40S) | 云GPU(4卡L40S按年) |
|---|---|---|
| 月成本 | 约8000元(分摊硬件) | 约9000元 |
| 部署周期 | 5-10个工作日 | 小时级 |
| 扩容效率 | 需采购,周期长 | 分钟级 |
| 数据主权 | 完全自主 | 依赖服务商 |
从上表可以看出,需要长期稳定使用的成熟业务适合物理机,业务波动较大的初创团队适合云GPU,两者并非互斥,混合架构正成为多数企业的共同选择。
采购流程中的资质核查
无论选择哪类GPU服务器,均应核查服务商的合规资质,以实体IDC和云服务商为例,重点关注:
- 是否持有增值电信业务经营许可证(IDC、CDN、ISP等业务范围)
- 机房的等保三级备案是否有效
- 能否提供服务等级协议SLA(如99.9%可用性承诺)
- 涉及数据跨境时,是否满足《数据出境安全评估办法》中的合规要求
常见问题解答
GPU服务器和普通CPU服务器的本质差异是什么?
GPU服务器搭载了大量并行计算核心,单张H100的FP16算力达到约1000 TFLOPS,是高端CPU的数百倍。GPU适合大规模并行计算,CPU适合逻辑控制和单线程任务,在深度学习训练场景中,GPU可将迭代时间从数周压缩到数小时。
企业如何确定GPU服务器的配置规模?
核心方法是从单卡开始做性能基准测试,选择与生产环境相同的数据集和模型,实测单卡吞吐量和延迟,再根据业务QPS目标线性推算所需卡数,并预留30%至50%的冗余应对流量增长,货币三家时,可要求服务商提供测试机进行压测验证。
国产GPU服务器能否替代NVIDIA方案?
国产GPU生态建设已取得一定进展,在推理场景中,基于昇腾和寒武纪的服务器可实现部分替代,但在大规模训练场景,CUDA生态的成熟度和工程工具链仍有差距。国内政策鼓励使用国产算力,具体选择需以实测性能数据为准,可以先小规模测试再逐步扩容。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/598688.html