大模型词表扩展会增加显存占用,增量主要体现在Embedding层,且推理阶段KV Cache的隐性涨幅往往被低估。
词表扩展的显存增量从哪来
Embedding矩阵:最直接的显存黑洞
大模型的词表扩展第一步就是改Embedding层,假设原始词表规模为V,隐藏层维度为H,Embedding参数量就是V乘以H,以LLaMA架构为例,32000词表扩展到50000词表,新增的18000个词向量,每个向量的维度通常是4096或5120。
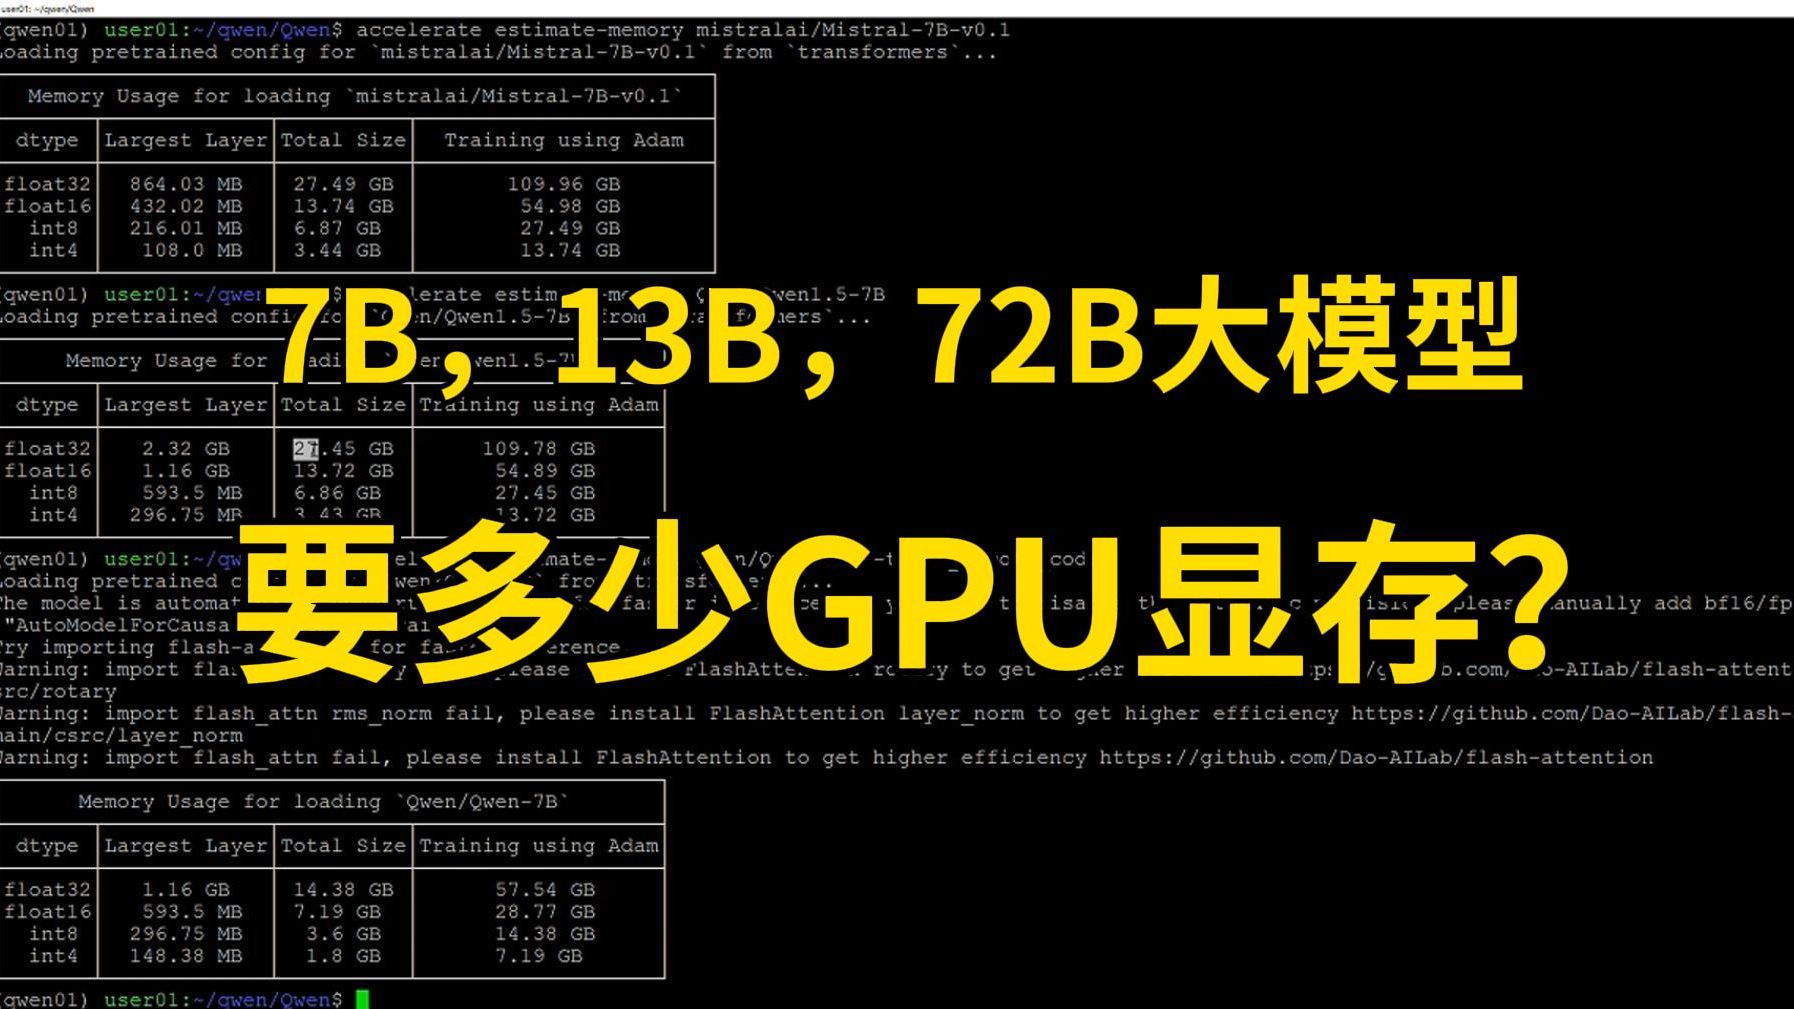

显存占用按半精度(FP16)计算,每个参数占2字节,公式很简单:新增显存约等于(新词表-原词表)×隐藏层维度×2字节。
举个例子,一个7B模型,隐藏层维度4096,词表从32000扩到50000,新增参数量是18000×4096,约7370万参数,半精度下占用约147MB显存,听起来不多,但考虑到整个7B模型权重约14GB,这个增量只占1%左右。
但事情没这么简单。业界现在普遍用更大的词表,比如Qwen系列已经到15万级别,从15万扩到20万,新增5万词,同样4096维度,新增参数2.05亿,显存增量约410MB,这时候占比就接近3%了。
输出层LM Head:经常被忽略的双倍开销
很多模型架构里,Embedding层和输出层是共享权重的(Tied Embedding),这时候显存增量只算一份,但不少新模型选择不共享,比如一些MoE模型和lstm模型,输出层单独一套参数。
不共享的情况下,显存增量要翻倍计算,还是上面那个例子,原本147MB的增量变成294MB,这点在估算显存时最容易算漏。
推理阶段:KV Cache的隐性膨胀
为什么说词表扩展影响KV Cache
词表变大后,同一个句子的Tokenization结果会发生变化,新词表中加入了更多中文词组、领域术语后,原来需要切成5个Token的短语,现在可能1个Token搞定。
Token数减少,KV Cache占用反而下降,这是词表扩展带来的正向收益,但多数场景下,用户输入的专业词汇变多,模型生成的Token中,新词表覆盖的词汇比例越来越高,整体序列长度未必缩短多少。
实际推理中最优显存估算方法
跑推理时,显存占用由三部分构成:模型权重、KV Cache、中间激活值,词表扩展对权重的影响前面算过了,对KV Cache的影响则需要结合具体场景。
行业共识认为,长上下文场景下KV Cache才是显存大头,比如一个7B模型跑32K上下文,batch size为8时,KV Cache可能需要几十个GB,此时词表扩展带来的几百MB增量,反而可以忽略。
多少显存才能跑扩展后的模型
综合下来,一张24GB显存的显卡,跑扩展后的13B模型,权重约26GB,已经超显存了,需要量化或者CPU offloading,扩展到50B词表后,权重增加约0.5GB,加剧了显存压力。
如果你的显卡刚好卡在临界点,比如23.5GB能跑、24GB跑不了的情况,词表扩展就是压垮骆驼的最后一根稻草。
训练阶段:优化器状态才是大头
训练时显存占用结构完全不同
训练大模型时,显存占用包括权重、梯度、优化器状态(Adam需要保存一阶和二阶动量),对于Adam优化器,每个参数的显存开销相当可观。
FP16训练时,一个参数在混合精度训练中需要:权重2字节+梯度2字节+Adam一阶动量4字节+Adam二阶动量4字节,总共12字节以上,这还是没算中间激活值的情况。
照这个算,词表从32000扩到50000,新增7370万参数,训练时额外显存为7370万×12字节,约884MB,这就不是小数字了。训练场景下,词表扩展的显存影响比推理高出一个数量级。
如何评估自己的词表扩展方案
关键词覆盖度评估
先别急着决定扩多少词。用真实语料跑一遍分词的覆盖率是首要步骤,准备几万条领域语料,分别用原词表和候选新词表做分词,看新词表能否把OOV(Out-of-Vocabulary)比例从5%降到1%以内,如果覆盖率提升不明显,说明投入产出比太低。
新增词数量怎么定
行业共识认为,增量词控制在原词表的20%-50%是性价比较高的区间,低于10%没效果,高于50%则容易出现新词频次低、训练不充分的问题。
具体操作上有个实用技巧:先统计词频,做Pareto分析,通常20%的高频新词能覆盖80%的OOV场景,优先加这部分词。
显存性价比对比:扩展词表还是用LoRA
不少团队问,词表扩展和LoRA微调哪个更省显存,这两个不是替代关系,但确实可以对比一下。
| 方案 | 显存增量 | 效果特点 |
|---|---|---|
| 全量词表扩展 | 较大,约0.1-1GB不等 | 彻底解决OOV问题,泛化性更好 |
| Adapter加在Embedding后 | 适中,约0.2GB | 新词独立编码,效果稳定 |
| 纯粹LoRA微调 | 很低,约几十MB | 无法引入新词,OOV问题依旧 |
全参数微调时的显存预算表
按12字节/参数的经验值,不同规模模型扩展不同词表后的训练显存增量如下(隐藏层维度按适配范围估算):
- 7B模型(4096维)扩5000词:约250MB
- 7B模型(4096维)扩10000词:约500MB
- 13B模型(5120维)扩10000词:约620MB
- 70B模型(8192维)扩20000词:约2GB
这些数值在业界常见配置中属于中等水平,训练时如果总显存占用超过80%,建议考虑减少batch size或用梯度累积来周旋。
实践中的显存优化技巧
分阶段加载参数到显存
全量训练时不要一次性把所有参数塞进显存,用DeepSpeed ZeRO Stage 2或3,把Embedding和输出层参数分布到多卡上,单卡显存压力能下降30%-50%。
复用Pad Token做词表扩展
这是个非常实用的技巧,扩展词表时新增的Token数量不一定是完整的几千个,可以先占用现有的非特殊Token位,很多中文词表里本身就有大量保留位,先利用这些空位,可以让实际显存增量再小一些。
按需分配Embedding显存
如果使用vLLM推理,可以开启Embedding的CPU offload选项,词表扩展后新增的这部分参数并不在每个请求中都会被访问,把它放在CPU内存里,只在访问时传输到GPU,显存占用几乎不增加。
设置合理的KV Cache策略
词表扩展能够缩短序列长度,但需要主动设置才能享受到这个红利,在推理框架中调整max-model-len和gpu-memory-utilization参数,让Token缩减带来的显存结余自动反馈给更长的上下文。
词表扩展的代价与收益平衡
做词表扩展之前,问自己三个问题:
- 你的应用场景是否真的需要OOV词,如果语料以通用中文为主,原词表覆盖可能已经足够好。
- 扩展倍数是否过高,词表翻倍,Embedding层占用也翻倍,这个趋势在超大规模模型上极为明显,据行业数据,一部分百亿模型在词表翻倍后,单卡推理的吞吐量下降了5%-10%。
- 是否有比扩展词表更轻的方案,比如直接用新词替换旧词,用BPE的merge操作添加规则,或者干脆用Character-level的模型。
即便不考虑显存,词表扩展还有很多隐藏成本,包括训练时间增加,新词需要足够的训练步数才能被充分学习,据统计,同等数据量下,词表扩展后模型收敛步数普遍增加20%-30%,这些时间成本和显存成本加在一起,恰好是衡量一个团队的技术预算是否够用的核心指标。
常见问题速答
大模型微调词表扩展显存增加多少?
训练场景下,7B模型扩5000词,显存增量约250MB;推理场景下增量仅几十到一百多MB,具体数值取决于隐藏层维度、是否共享输入输出层,以及训练时的优化器类型,用前面给的公式乘以对应系数就能估算。
词表扩展后推理变慢怎么办?
启动前检查Tokenize的耗时是否明显拉长,模型层面,通过减少序列长度来弥补新词带来的嵌入查找开销;框架层面,调低KV Cache预留的显存比例,把更多GPU显存留给计算,如果仍然慢,说明增量词本身没有被语料充分覆盖,建议回退到较小词表。
词表扩展和domain-adaptive pre-training的显存影响有何不同?
两者都改模型权重,但词表扩展额外改变模型的结构尺寸,显存增长更有确定性;预训练继续训练可以设置冻结Embedding层,显存需求更可控,如果需求是领域适配,推荐先用领域数据做继续预训练,效果不足时再考虑词表扩展。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623465.html