多租户训练平台的配额与隔离设计,核心答案就一句话:用Kubernetes的ResourceQuota管配额、用Namespace加RBAC做隔离,配合GPU显存调度和优先级分层,才能让多个团队在共享集群上既不打架也不浪费。
很多平台团队跟我吐槽,说训练集群一到下午就卡成PPT,某个团队把GPU全占跑了,另一个团队的任务排队排到天亮,这不是硬件不够,是配额和隔离没设计好,今天咱们就把这事儿掰开揉碎聊清楚。
多租户训练平台的配额怎么设置才不踩坑
配额设置的第一步,是搞清楚你要管哪些资源,训练任务跟普通Web服务不一样,它不仅要CPU和内存,还要GPU卡、显存、甚至高速存储的IOPS,很多平台只配了CPU和内存的配额,GPU完全放养,结果就是谁手快谁抢卡,毫无公平性可言。
资源维度的粒度划分
- 计算资源:CPU核数、内存大小是基础盘,必须跟Kubernetes的requests和limits对齐,我建议CPU按核数配额,内存按GiB配额,别用百分比,不然团队算不清楚自己还剩多少。
- GPU资源:这是训练平台的命根子,你至少要把GPU卡数纳入配额,按卡为单位发放,如果集群里有A100、H800这种异构卡,还要按卡型分别设置配额,不然有人专挑贵的卡跑。
- 显存资源:单卡显存不够用的时候,用户会去抢别的卡,这就需要限制每张卡的显存上限,防止一个任务把8张卡的全部显存都吃光。
- 存储与带宽:数据集读取和checkpoint写入是隐形杀手,建议给每个Namespace设置PV总容量上限,同时限制每秒I/O次数,避免某个团队疯狂读写拖垮整个存储后端。
配额策略的三种模式对比
| 模式 | 实现方式 | 适用场景 | 缺点 |
|---|---|---|---|
| 静态配额 | 管理员后台手工分配 | 团队边界清晰、用量稳定的企业 | 灵活性差,资源闲置率高 |
| 动态配额 | 基于历史用量自动调整 | 研究型团队、业务波动大的场景 | 需要大量历史数据支撑 |
| 超卖配额 | 配额总和大于物理总量 | 多数训练任务占不满GPU显存 | 有OOM风险,需配合抢占机制 |
据我观察,多数情况下静态配额+少量超卖的组合最实用,你可以设置一个超额系数,比如物理100张卡,配额放出去120张卡,但设置弹性上限,触发资源争抢时按任务优先级回收。
训练平台GPU隔离方案到底怎么选
隔离设计是配额管理的孪生兄弟,配额说你能用多少,隔离保障你用的时候不被别人干扰,咱们分几个层面来看。
Kubernetes层面的隔离机制
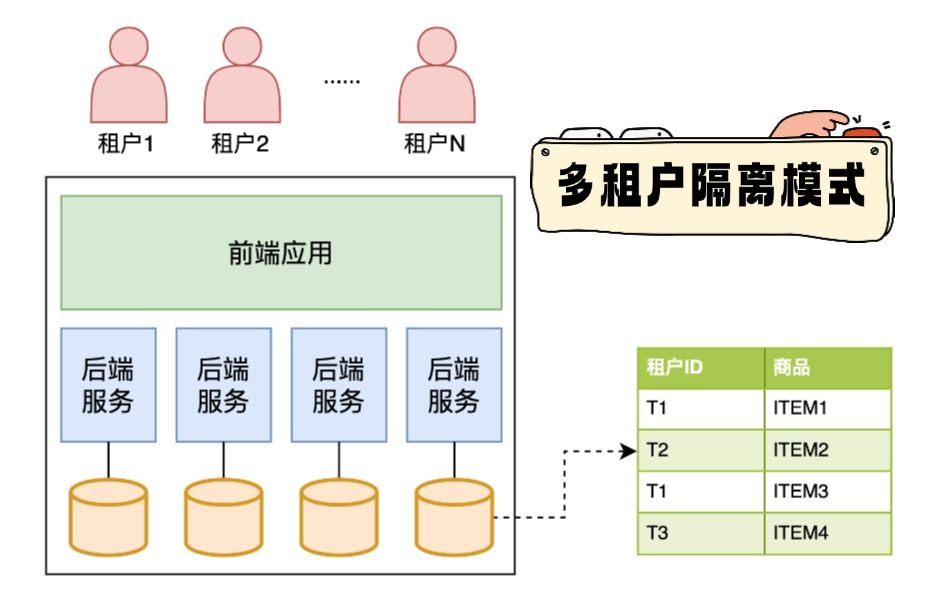
Namespace是第一道防线,每个租户对应一个Namespace,配额挂在Namespace上,天然分隔,但你要注意,Namespace只能隔离Kubernetes对象,隔离不了底层Linux内核资源,所以还需要配套RBAC(基于角色的访问控制),给每个租户单独的ServiceAccount,限制他们能看什么、能改什么。
- 网络隔离:用NetworkPolicy控制Namespace之间的流量,禁止租户A直接访问租户B的Pod IP,训练任务经常要跨节点通信,建议保留同Namespace内部全通,跨Namespace默认拒绝。
- 存储隔离:用PVC的StorageClass绑定,每个Namespace只能创建指定StorageClass的PVC,防止有人偷偷去挂载别的团队的NFS目录。
- 调度隔离:给每个节点打上GPU类型标签,配合NodeSelector或者节点亲和性,把不同团队的任务调度到不同物理机上,这招在混合部署场景特别有用。
GPU显存隔离的技术路线
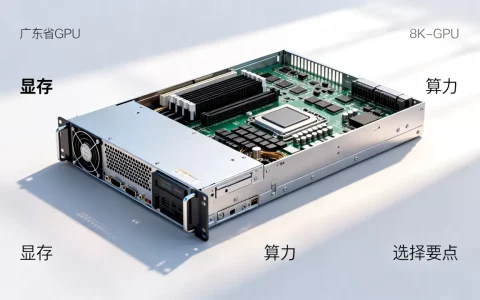
光有卡数配额不够,因为一张A100上的显存是40GB或80GB,你要是只限制卡数不限制显存,用户就能开一个超大的Batch Size把显存干爆,影响同卡上的其他进程。
- 整卡分配,最简单的办法,一个Pod要就要整张卡,通过nvidia-device-plugin的gpu卡数资源上报实现,缺点很明显,显存碎片化严重,一张80GB的卡,模型只要20GB也得整卡给。
- 显存切片,用NVIDIA MPS(多进程服务)或者vGPU方案,把一张卡切成多个小份,MPS对计算密集型任务性能损失较小,但配置复杂,需要提前在节点上装好对应版本的驱动和CUDA。
- MIG切片,A100、H100这些新卡支持MIG技术,能把一张物理卡切出多个实例,硬件级别隔离显存和计算单元。行业共识认为MIG是当前训练隔离方案里性价比最高的选择,但要注意MIG实例不支持跨实例通信,大模型分布式训练没法用。
从实际操作看,多数团队会混合使用:大模型训练整卡分配,小模型微调用MIG切片,这需要平台在调度层做好Capacity的识别和上报,不然用户不知道哪些是整卡、哪些是MIG实例。
多团队训练任务共享集群的资源调度实战
配额和隔离搭好后,真正的考验在调度策略上,多个团队同时提交任务,谁先跑谁排队?抢资源的时候怎么回收?
优先级队列和抢占机制
结合业内专家指导思路,建议平台设置两到三个优先级档位。
- 生产级任务:最高优先,直接命中空闲资源,不可被抢占
- 开发调试任务:中等优先,可被抢占,但被抢占前给5分钟优雅退出时间
- 批处理实验任务:最低优先,只能使用闲置资源,一旦有高优任务随时让路
在实现上,可用Kubernetes的PriorityClass定义优先级,配合自定义调度器实现抢占逻辑,注意被抢占的任务要把checkpoint频率调高,比如每5分钟存一次,这样恢复成本低。
弹性伸缩与资源碎片整理
训练任务的资源需求是波动的,模型在加载数据的时候CPU吃紧、GPU闲等,在反向传播阶段GPU打满,动辄为每个任务预留上限资源不现实,怎么做?
- 把CPU和内存的requests设低一些、limits设高一些,给剩余资源留出弹性水位
- Pod水平自动扩缩容(HPA)对训练任务不太适用,因为训练时长固定、批量任务居多,更推荐用Kueue或Volcano等批处理调度框架,它们原生支持队列、抢占、组调度这些能力,比手写调度器省心多了
- 恶劣情况下,定期做碎片整理:把多个小任务合并到同一批节点上,空出整块的大节点给大型分布式训练任务用,这个操作建议在维护窗口期做,否则迁移Pod会造成训练中断
训练集群租户用量怎么监控和计费分摊
配额设置好了,隔离做完了,还有最终要的一环:让租户看得见自己的用量和剩余额度,不透明配额只会让团队天天找你扯皮。
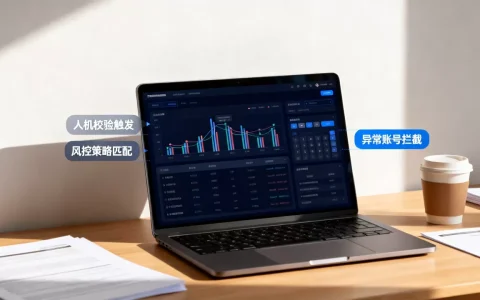
可观测性看板要展示什么
每个租户的看板上至少要展示:
- 当前已使用配额百分比,包含CPU、内存、GPU卡数、显存四个维度
- 近7天或30天的资源使用趋势曲线,让团队自己做用量预测
- 各任务粒度的资源消耗明细,哪个实验最烧钱,一目了然
- 队列等待时长和排队位置,让用户知道自己的任务大概什么时候能跑上
这些数据层面的指标,可以通过Prometheus采集容器资源监控数据和Kubernetes的ResourceQuota状态,然后用Grafana搭建租户隔离的可观测性看板,查询维度的数据要比计量维度的数据更细,因为租户要排障、要做成本归属。
成本分摊的计算口径
据统计,相当一部分平台团队在成本核算上吃过亏,训练任务涉及GPU折旧、电费、存储费用、网络流量费用,建议把平台所有硬件成本加上人工运维成本,算出一个每小时单卡成本基准价,然后按租户的GPU卡占用时长乘以基准价,再加存储占用费用(按GB/月)和网络流量费用(按出站流量,入站免费),就是每月的账单。
记得把“资源闲置率”作为重要考核指标,如果一个租户领了100张卡,但平均利用率只有30%,那在下个季度的配额分配时就得打折扣,这种机制推动大家去合理申请配额,也鼓励团队之间自行协商资源置换,减轻平台管理员的协调负担。
多租户训练平台配额隔离常见问题
开发环境和生产环境需要分两套集群吗?
预算充足的话当然建议分开,但多数团队只有一套集群,那就在同一套集群里用Namespace隔离,开发和生产用不同的配额池,注意给生产Namespace调高优先级,宁可开发任务被抢占,也不能让生产训练中断,还有开发环境的PVC记得配置自动回收策略,不然模型文件堆得比山还高。
DeepSpeed和Megatron这类分布式框架怎么跟配额配合?
分布式训练会以AllReduce方式跨节点通信,任务要申请多卡多节点,此时配额校验必须做到同一任务的Pod共享一个配额桶,不能每个Pod单独计算,另外这类任务对节点间的网络带宽和延迟要求极高,建议配合拓扑感知调度,把所有Pod调度到同一台交换机下的节点上,否则通信瓶颈会拖慢整个训练速度,调度器可以通过节点标签和拓扑域来约束Pod分布,在yaml里声明Pod组调度策略即可。
配额超卖后系统会不会崩溃?
超卖不等于无限超卖,在超卖池里,你要设置一个硬性的驱逐水位线:当物理资源使用率超过85%时,开始主动终止最低优先级的任务,这里面有个细节,被终止的任务要能自动恢复,否则用户跑了两天的任务因为别人抢资源就前功尽弃了,办法是把任务的启动脚本做成幂等加载最新checkpoint,平台侧负责重启Pod,这样即使被抢占,任务也能从上次保存的checkpoint继续跑,最多损失几分钟的训练进度,前端界面要显示当前集群的繁忙程度,让用户自己评估合适的上车时机。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625259.html