大模型微调阶段选显卡,核心不是看算力跑分多高,而是看显存容量和有效带宽能不能装下你的模型和优化器状态,预算有限时,租卡往往比买卡更划算。
微调和预训练是两码事,预训练像开荒,什么都要硬扛;微调更像在熟地上精耕细作,目标明确、数据量小、训练轮次少,这个区别直接决定了你在显卡上的钱该怎么花,很多团队在预训练阶段咬咬牙买了顶级卡,到了微调阶段才发现性能冗余严重,钱花在了刀刃背面,本文不聊纸上参数,只从成本视角拆解微调阶段选卡的真实逻辑。

微调场景下显卡的真实需求,显存容量和工作负载怎么匹配
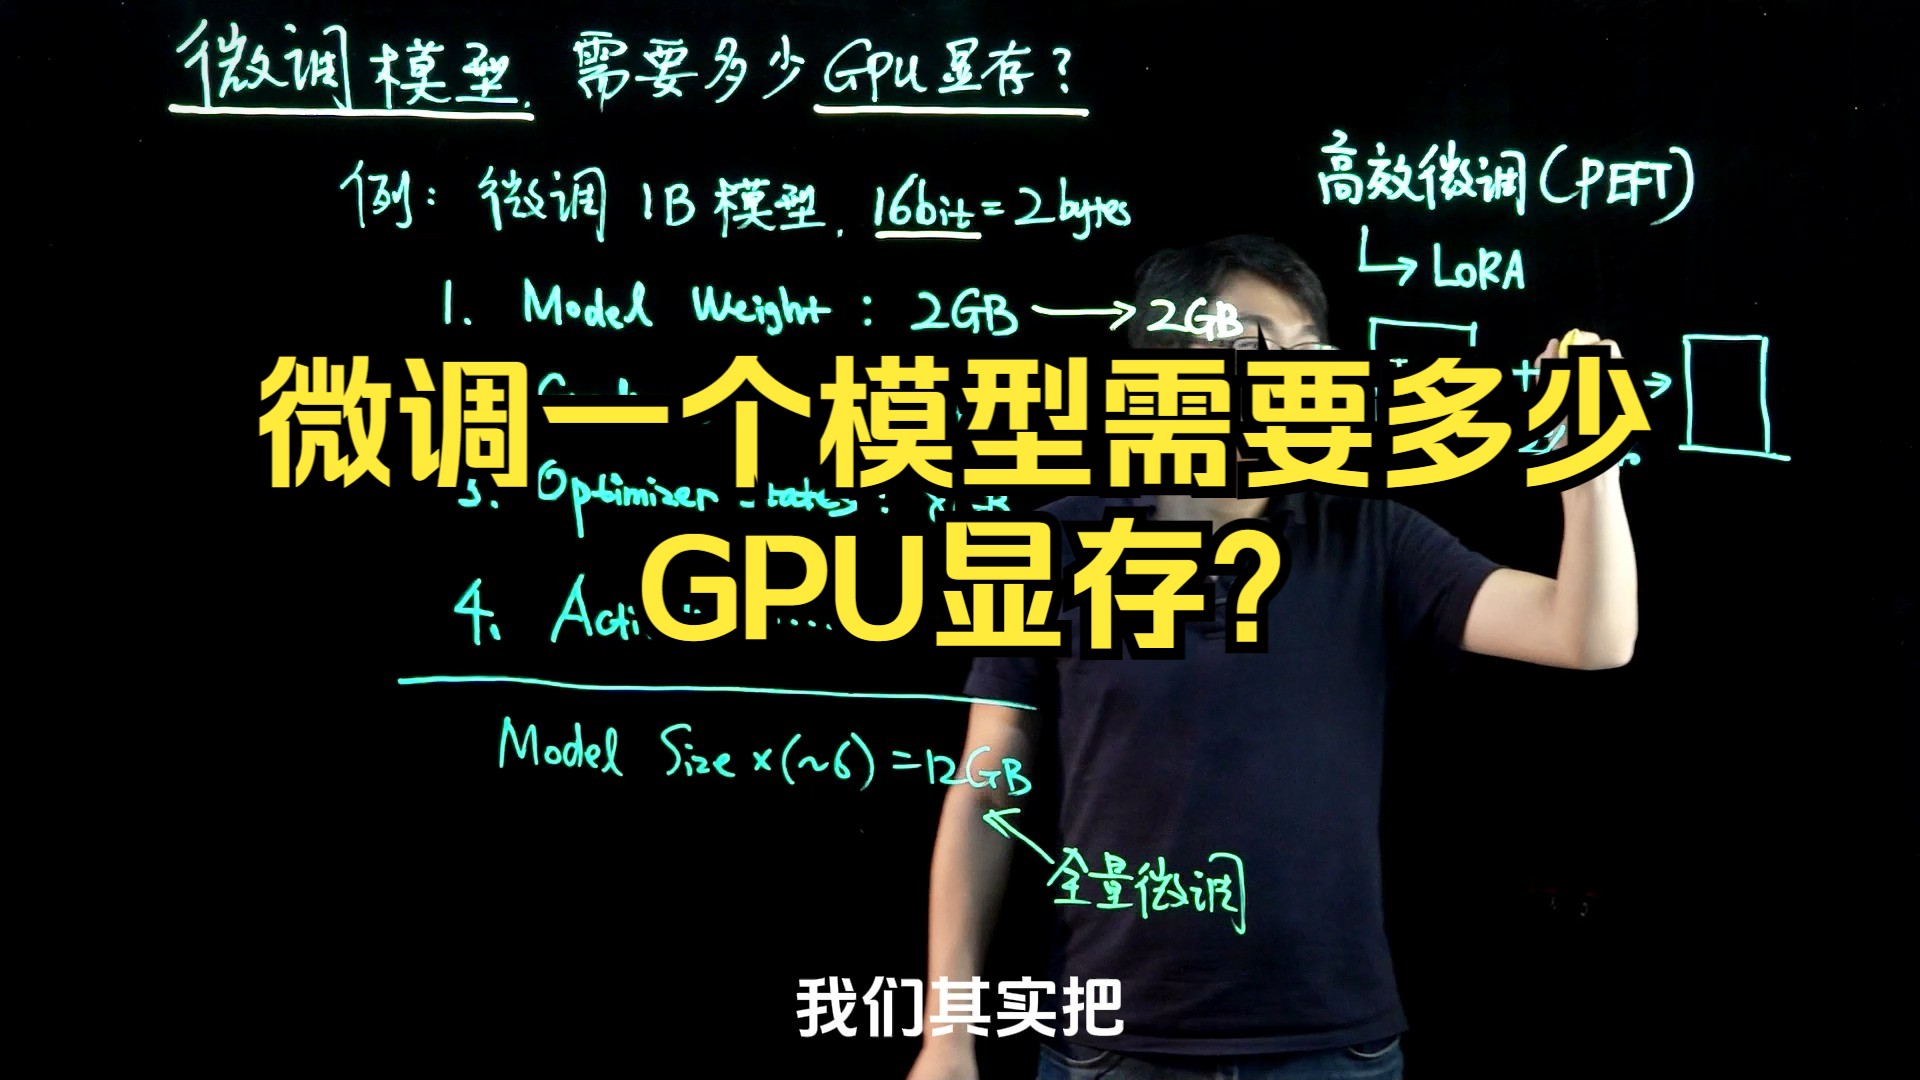
微调显存压力主要来自四个部分:模型权重、梯度、优化器状态(AdamW的动量和方差)、激活值,业内专家指出,一个7B参数的模型在混合精度(bf16)微调时,仅权重就需要约14GB显存,加上梯度和优化器状态,基础显存需求轻松突破40GB,这还没算上序列长度带来的激活值开销,行业共识认为,序列长度从512提升到2048,激活值显存可能翻倍,所以微调选卡的第一条铁律是:先算显存账,再看算力账。
显存容量决定你能不能跑起来
显存不够,再快的卡也白搭,一张24GB显存的RTX 4090,理论算力很强,但想全量微调7B模型,直接爆显存,这不是技术优化能完全解决的,是物理容量的天花板,你需要明确一个概念:全量微调(Full Fine-tuning)和参数高效微调(PEFT,比如LoRA)的显存需求差了数倍。
- 全量微调7B模型:推荐80GB以上显存,例如A100 80G或H100 80G。
- LoRA微调7B模型:因为只训练低秩矩阵,显存需求可以压缩到16GB至24GB区间,RTX 4090或RTX 4000 Ada系列即可胜任。
- 量化微调(QLoRA) :4bit量化后,7B模型的基础显存占用可以低至6GB到8GB,但训练速度和稳定性会打折扣。
算力与显存带宽的性价比权衡
微调是短跑,不是马拉松,它不像预训练那样需要几十天的连续满负荷计算,微调通常只需要几个小时到几天,所以单卡算力的绝对峰值不是唯一指标。显存带宽和数据吞吐的稳定性反而更重要,H100的算力确实碾压4090,但对于一个几小时就能跑完的LoRA任务,用H100省下的时间可能只值几百块电费,而两者的时租价格差了近五倍,这个账算下来,很多中小团队选择租用4090或A800来完成大部分微调实验,只把最后的精调任务留给更高端的卡。
微调显卡显存不够怎么办,替代方案在实际操作中怎么选
显存不够的情况在实际工作中太常见了,尤其是用老款显卡(比如V100 16G或2080Ti)跑新模型,与其硬着头皮买新卡,不如先看看手头的资源能不能榨出更多价值。显存不够,通常有几条路可以走,按优先级排序如下:
- 降低精度:从fp32切到bf16,显存直接减半,如果还不行,就上8bit或4bit的QLoRA,代价是训练时间变长,大约增长20%到40%。
- 减小批次大小:batch size从8降到2或1,并开启梯度累积(gradient accumulation),虽然显存占用率下来了,但GPU利用率会降低,需要平衡。
- 序列长度裁剪:如果你的任务不是长文档理解,把最大序列长度从4096降到1024,激活值显存会大幅下降。
- 卸载(Offload)策略:使用DeepSpeed ZeRO-3或模型卸载,将优化器状态或参数临时挪到CPU内存,但频繁的PCIe传输会让训练速度明显下降。
本地部署微调显卡预算怎么框算
买卡要算五年总拥有成本,而不是只看首发价,一张RTX 4090(24GB)目前在实际交易中价格在6万至2万元人民币区间(据公开渠道2026年行情波动),如果用它做主力微调卡,电费按1000W满载功耗、每天8小时训练计算,一年电费约1500元上下,五年下来,设备折旧加电费约2.5万元。
而租用一张云端的RTX 4090,按2026年下半年主流云厂商的价格,约2元到4元/小时,如果你每年只有60个有效训练小时,租卡成本不足240元,这就是为什么很多个人开发者租卡更划算,如果是三五人的小团队,每周固定训练20小时,一年52周,租卡成本约2万元,这时候买卡的性价比才开始显现。
高端算力不是必需品,效率工具更关键
微调阶段卡在显存瓶颈,不代表一定要上A100,一张24GB显存的显卡配合现代框架的优化,能解决70%以上的微调场景,比如Hugging Face PEFT库加bitsandbytes量化,就能让16GB显存的机器跑起7B模型的LoRA微调,实操步骤非常简单:
pip install peft bitsandbytes transformers
加载模型时直接指定量化:
model = AutoModelForCausalLM.from_pretrained("model_path", load_in_4bit=True, device_map="auto")
然后正常用PEFT准备LoRA配置做训练,这个流程完全可以跑在消费级显卡上,显存占用实测在10GB左右。不要在工具链上省时间,多花一小时了解PEFT和DeepSpeed的文档,可能比多花几万块买显卡更有效。
买卡还是租卡,微调显卡预算分配在不同场景下怎么定
这个问题没有标准答案,但成本视角下有个清晰的决策树,核心不是“哪种方案好”,而是你的利用率有多高,利用率是稀缺资源的天敌。
高频持续训练场景:买卡更合算
如果团队每天都在跑实验,微调是日常流水线的一部分,显卡的利用率能维持在每周40小时以上,那自购显卡的折旧成本会被摊薄。A800 80G或RTX 4090是首选,A800在80GB显存里有绝对优势,可以覆盖全量微调需求,但价格更高,RTX 4090做不到全量7B微调,但配合LoRA基本够用,价格只有前者的三分之一。
低频或弹性需求场景:租卡更机动
个人开发者、高校实验室初期探索、小公司试水项目,这些场景的典型特征是需求脉冲式爆发,某几天疯狂调参,接下来一两周闲置,这时候租卡按小时计费,灵活度高得多,国内比较常见的租卡渠道包括AutoDL、恒源云等平台,RTX 3090(24GB)大约1元/小时,RTX 4090约3元/小时,A100 80G价格在5元到9元/小时不等,按单次7B模型微调30小时算,一次实验的算力成本控制在90元到270元之间。
混合策略是多数团队的最优解
现实中,多数小团队会选择“一张自购卡打底+云上弹性扩容”的策略,自购一张RTX 4090负责日常调试和小规模LoRA实验,当需要跑全量微调或多卡并行时,再去云端租用多台A100,这个策略的优势在于既保住了低延迟的调试体验,又避免了高端显卡闲置的资金占用。
多卡并行微调的省钱要点
如果规模上去了,需要用多卡微调,不要迷信卡越多越好,8张消费级显卡互联的通信效率远低于2张数据中心级显卡,在实际操作中,一张24GB显存卡能跑的模型,两张卡通过DeepSpeed ZeRO-3分片,显存利用率大约只有单卡等效的1.8倍,因为通信开销要吃掉一部分性能,你算力投入的性价比曲线在4卡之后会明显下滑,多卡并行之前,先确认单卡显存是不是真的榨干了。
微调显卡显存需求,怎么量化评估自己的实际用量
别凭感觉估显存,有现成的公式可以算,实际操作中,可以通过transformers库在加载模型时打印显存占用,也可以用torch.cuda.max_memory_allocated()来测,以下是一个粗略的估算方法:
全量微调显存(GB) ≈ 模型参数量(B) × 20,一个7B模型约需要140GB显存,这个系数20来自权重(2字节)、梯度(2字节)、优化器状态(12字节,AdamW的fp32副本)以及激活值预留,如果是LoRA微调,系数可以降到4到6之间,具体取决于LoRA的秩(rank)和序列长度。
Q&A:微调和推理对显卡要求有什么不同?
微调阶段为什么不能用推理显卡代劳?
推理阶段,模型是固定的,不计算梯度,只需要前向传播,所以显存主要就是权重加缓存,推理一张24GB的4090可以服务7B模型,但微调同一模型它就会爆显存,因为反向传播需要保存中间激活值和梯度。简单说,推理是“只读”,微调是“读写并记录”。
显存和算力哪个对微调速度影响更大?
取决于瓶颈,如果你的批量大小和序列长度固定,算力决定每一步的运算速度,显存决定你最多能跑多大的批量和序列,显存不够导致梯度累积次数过多,GPU在等待数据同步,训练速度反而比算力稍弱但显存更大的卡慢,在微调场景,多数情况下显存容量对最终训练时长的影响权重更高。
租卡微调时,怎么选云厂商的实例?
首先看显存和价格,其次看数据存储的读写速度,训练数据集如果放在普通云盘,数据加载会成为瓶颈,导致GPU空转,选择带有SSD本地盘或高性能NAS挂载的实例更稳妥,实际测试中,数据加载慢可以轻松让训练速度下降一半左右,先小批次跑任务,用nvidia-smi监控GPU利用率,如果持续低于80%,优先排查数据管线和CPU预处理。
微调阶段的显卡选型,本质是一场“匹配”游戏,匹配你的模型尺寸、数据规模、训练频率和资金成本,显存是第一道门槛,利用率和成本是第二道门槛,算力跑分其实是第三位的。在做任何购买决策前,用租卡的代价跑通一次真实微调任务,用实测数据说话,这才是最省钱的方式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625491.html