当某个后端节点响应缓慢甚至卡死时,成熟的负载均衡机制会通过健康检查将其自动摘除,并把这些慢请求平滑转移到其余健康实例上,这个过程不需要人工介入,也不会中断现有业务。这并非什么黑科技,而是现代分布式架构里一项基础且必备的容错能力,这篇文章不绕弯子,直接拆解这个机制的工作方式、实际配置以及你可能会踩的坑。
慢节点为什么可怕,以及流量如何被“劝退”
集群里某个节点变慢,往往比节点彻底挂掉更危险,节点宕机,负载均衡器能立刻感知并停止转发;但节点“半死不活”,端口还开着,进程还健在,却要花几秒钟才能响应一个简单请求,这时候负载均衡设备会怎么想?它很纠结如果持续把流量分给这个慢节点,用户端就会积压大量等待中的请求,接口耗时被无限拉长,甚至引发雪崩,更重要的一点是,这些超时请求占用的线程池和连接资源不会自动释放,慢慢拖垮整个服务集群。

核心解决办法是主动健康检查加上被动熔断的组合拳。
从顶层设计看,负载均衡组件会对节点做两类探测:
- 主动探测:定时发起TCP连接、HTTP请求或ICMP Ping,只要节点在规定时间内响应,就认为它活着,也就把流量继续分配给这个节点。
- 被动探测:所谓被动,是指负载均衡在转发真实业务流量时,持续记录节点的错误率、超时次数、响应延迟,当这些指标超过设定阈值,即使主动探测是通的,也默认它已是“不健康状态”,随即把流量调度到其它健康实例上。
大多数成熟的网关或负载均衡软件,会同时开启这两个机制,但侧重点各有不同。
从“发现”到“漂移”完整路径拆解
为了让你对流量自动漂移的链路有具体感知,这里以最常见的Nginx和Spring Cloud Gateway为例,整理出一条完整路径。
第一步:节点开始变慢,某个后端实例由于磁盘I/O瓶颈,导致响应时间从平时的30毫秒飙涨到3秒,此时系统状态还没完全卡死,TCP三次握手依然正常。
第二步:主动健康检查失守,Nginx的max_fails机制在默认配置下,会在fail_timeout周期内累计失败次数,一旦请求转发失败或超时超过阈值,Nginx会将该节点标记为“不可用”,并停止转发新流量,需要说明的是,Nginx传统上做的是被动式检查,即基于真实请求结果判断,无真实业务流量时它无法主动探测,如果希望实现主动探测,一般需要借助nginx_upstream_check_module模块或使用OpenResty。
第三步:流量调度切换,在标记节点不健康的瞬间,负载均衡器会将新连接和新请求平滑路由到其它存活的实例上,这里有一个容易被忽视的细节:已经停留在该慢节点上的长连接或正在处理中的半成品请求不会被强制掐断,而是等待其自然超时,这种软切换能最大限度减少业务侧的可感知异常。
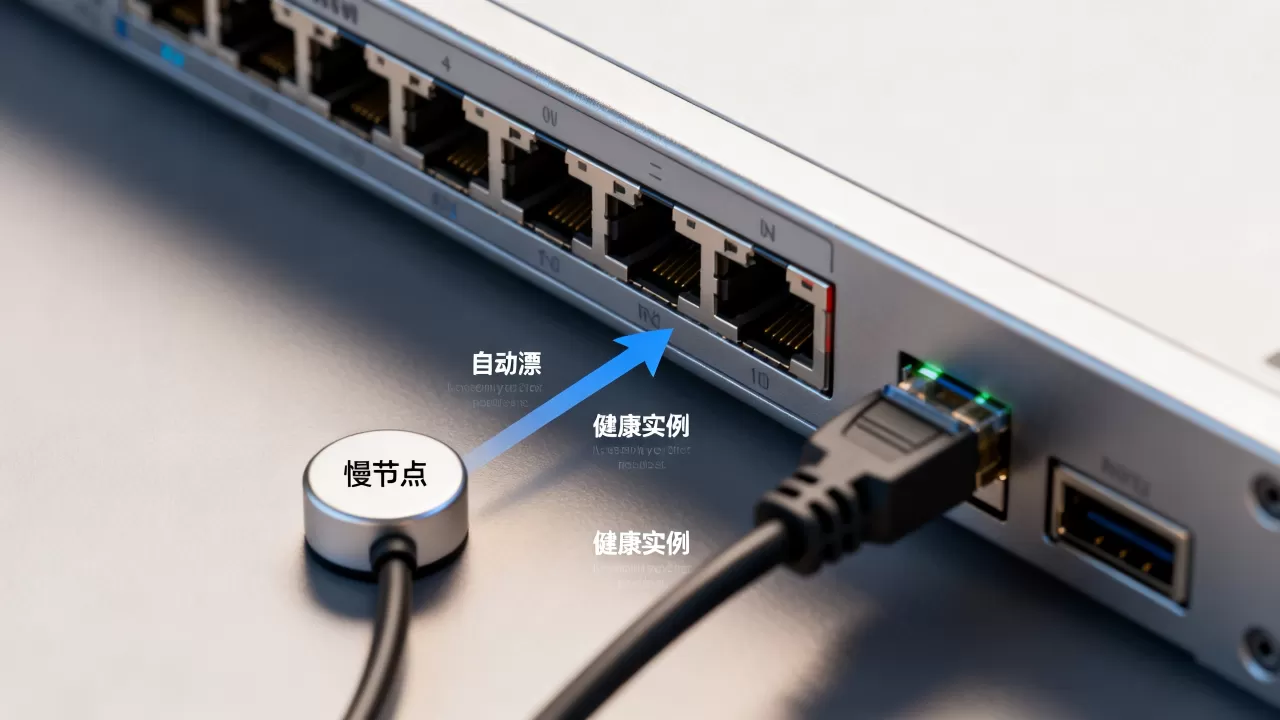
第四步:恢复周期再探测,节点被摘除后,负载均衡器并不会永久放弃它,每隔一段时间,它仍会尝试向这个节点发送探测请求,如果节点恢复正常且连续返回成功,它会被重新加回流量池。
为了更直观显示不同组件在公共卫生事件中的行为差异,下表汇总了几类常见组件的关键参数与处理方式:
| 组件类型 | 健康检查方式 | 节点摘除依据 | 恢复机制 |
|---|---|---|---|
| Nginx(标准版) | 被动(基于转发请求成功/失败) | max_fails / fail_timeout 组合 | 周期滑动窗口,自动重新计数 |
| OpenResty / lua-resty-healthcheck | 主动HTTP/TCP探测 | 连续失败次数 | 连续成功,达到阈值后自动拉回 |
| Spring Cloud Gateway + Nacos | 心跳上报与主动探测结合 | 实例心跳超时 | 心跳恢复即重新注册与发现 |
| Keepalived + LVS | 主动探活(TCP检查) | 探测失败 | 固定间隔重试,成功后重新加入VIP调度 |
更精准的调度:从“靠感觉”到“看数据”
单纯靠“能连通”来判断节点是否健康,在微服务治理中是不够的,一个节点TCP能通,但接口平均响应时间已经飙到5秒,这算健康吗?
行业的普遍做法是在负载均衡之上增加一层延迟感知调度或自适应过载保护,这类能力通常体现在服务网格(如Istio、Linkerd)或微服务框架中,它的逻辑不复杂:框架会持续采集每个实例的P50、P95延迟、错误率以及流量吞吐量,把这些指标喂给治理策略引擎,当节点延迟超过基线值的合理倍数时,即使该节点从未报错,流量也会被自动地“冷落”掉,慢慢减少分配给它的请求比例,直至降到某一安全水位。
这就是所谓的“平滑降级”,也可以理解为慢节点治理的进阶形态之一,与粗暴摘除不同,它不会瞬间把某个节点的连接数降为零,而是像调节水龙头一样,让流量逐渐撤离,给了实例喘息恢复的空间。
在具体方案选型上,不同的负载均衡方案有不同的权衡取舍:
- 负载均衡层调度:代价最低,系统对流量控制力较弱,无法感知服务内部健康。
- 服务注册中心感知:由服务框架定期发送心跳到注册中心,注册中心将不健康的实例移除,负载均衡器发现后自动停止向该地址转发。
- 客户端智能负载均衡:消费者侧自行维护可用节点列表,记录每个提供者的延迟、错误率、并发窗口,在调用时优先选择健康且“低延迟”的节点,例如gRPC的xDS协议配合Envoy,就是这类实践的典型代表。
动手实操三步让流量自动漂移落地
选定技术栈不同,实操路径不可能是通用的,但核心步骤可以归纳为三条主线。
第一步:为后端服务配置统一的健康检查端点,理想的健康检查不应该只是返回200,而是让服务自行检测其下游依赖的连通性,比如数据库连接池是否还有空闲连接、缓存是否可用、消息队列是否积压,如果这些依赖已经发生故障,健康检查端点应返回5xx状态码,这比单纯检查进程存活更有实际意义。
第二步:修改负载均衡器或网关配置,以常见的Nginx反向代理为例,可以这样配置主动健康检查(以OpenResty或打了补丁的Nginx为例):
upstream backend_cluster {
    zone upstream_backend 64k;
    server 10.0.0.1:8080;
    server 10.0.0.2:8080;
    # 主动健康检查
    check interval=3000 rise=2 fall=5 timeout=1000 type=http;
    check_http_send "HEAD /healthz HTTP/1.1rnHost: localhostrnrn";
    check_http_expect_alive http_2xx http_3xx;
}
interval是探测间隔,fall表示连续失败几次后判定节点失效,rise表示连续成功几次后恢复,把这组参数调成适合业务的数值,而不是沿用默认值。
第三步:验证并监控流量分布,配置完成后,在测试环境手动停掉某个实例,或者人为阻塞某个实例的CPU资源,观察负载均衡日志或监控面板,确认流量是否平滑转移到其它实例,重点看三个指标:节点的请求成功率、节点的平均响应时间以及负载均衡侧的超时错误率。
常见陷阱与实战排错
慢节点的探测和漂移机制,在日常运行中会遇到不少挑战,下面梳理几个高频问题点。
健康检查与业务流量共用一条连接,导致探测结果失真,有些服务在健康检查接口里做了缓存或本地处理,即使数据库连接池已满,健康检查返回的依然是200,结果就是节点明明不行了,负载均衡器还在往里灌流量。
恢复阈值设置太苛刻,节点永远回不来,你把rise参数设得很高,比如要求连续成功50次才算恢复,在业务低峰期,健康检查频率低,节点可能要好几分钟才能回到流量池里,而高峰期一旦涌入大量请求,这个“半恢复”的节点又会迅速被打挂,陷入死循环。
只关注了节点层,忽略了连接池层,在Java微服务架构中,即使上游已停止向慢节点发新请求,该节点自身发往数据库的HttpClient或Dubbo连接池中,可能仍积压着大量旧请求的线程等待,这些线程会继续占用CPU和内存资源,让节点的“慢”延长一小段时间。
实战排错建议从下面几个维度着手:
- 在负载均衡日志中过滤非200状态码,对比时间线,确认节点摘除动作是否发生
- 查看慢节点自身的GC日志、磁盘等待队列和网络重传率,定位根因
- 确认连接池组件是否开启了超时中断,避免调用方无限等待
- 在网关层区分“业务超时”和“连接超时”,这两种错误对应着不同的节点故障类型
关于逐出后的“震荡”与“甩尾”
一个常见且容易被误解的现象是节点被摘除后,为什么流量还在往它上面打?
原因大多在于连接级调度与请求级调度之间的差异,如果负载均衡器基于连接做哈希(例如IP哈希或Cookie会话保持),已经建立的TCP连接在没有断开之前,后续的HTTP请求依然会顺着连接到达原节点,此时健康检查虽然标记了节点故障,但现有连接并未被强制回收。
处理此种场景的常见手段是,在负载均衡层设置合理的keepalive_timeout,让空闲连接定期回收;同时建议服务端设置server 的max_conns,从源头限制并发连接数,防止某一节点瞬间涌入过量连接。
核心要点小结
慢节点自动摘除和流量漂移,本质上是负载均衡系统围绕“确定性”做的一个复杂博弈,它从“能连通”到“响应快”,再到“下游健康”,逐层递进地定义了一个节点到底算不算健康。
判断一个负载均衡系统是否合格,不在于它在节点挂掉时处理得有多快,而在于它对“将挂未挂”的慢节点的感知上限和处置速度。
在生产环境中,建议将主动探测的端口独立绑定在Ping端口上,并确保探测接口不被业务线程池占用,这样探测结果才能真正反映节点的存活质量,熟读你所用组件的健康检查参数interval、fall、rise、timeout这四个值往往决定了你的服务在节点故障时的健壮性边界。
Q&A慢节点流量自动漂移常见问题
问:慢节点被自动摘除后,如果它一直处于“半死”状态,如何避免负载均衡器反复向其发送探测请求?
答:把主动健康检查的fall阈值调高一些,同时将timeout设置得尽量短,大多数负载均衡器在探测超时或失败后会立即停止分发,但在下一个探测周期又会再次尝试,这个周期的长短将直接决定故障节点的“被遗忘时间”,如果需要更彻底地隔离,可以结合服务注册中心,让节点在连续多轮探测失败后主动上报注销状态。
问:健康检查频率设置多久比较合理?
答:行业共识认为,低频次检查(比如每10秒一次)可以适应大量静态资源集群场景,但无法应对快速变化的流量波动,对于涉及实时交易或核心接口的系统,建议将间隔设在2至3秒之间,检查过于频繁会无端增加服务端压力;检查次数过少,则会导致故障影响面扩大。
问:被动健康检查能否完全替代主动健康检查?
答:不能完全替代,被动检查的缺陷在于它依赖“流量”来发现故障,若上游流量很小或请求模式固定,某些非关键路径节点可能长期无法被扫描到,主动检查则具备兜底能力,能主动确认节点的真实运行状态,生产环境中的标准做法是将两者结合起来,各自覆盖对方无法触及的场景,同时避免重复设置相同指标。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/633453.html