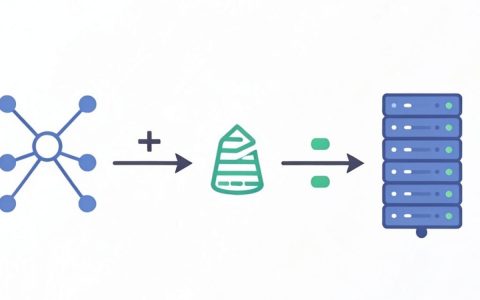
内网服务要不要过负载均衡入口,答案不是非黑即白:所有来自公网的请求必须经过负载均衡,纯内网的服务间调用则可以直连,不必绕一圈。你把负载均衡想象成小区门卫,访客进门必须登记,但楼里邻居串门直接敲门就行,没必要在门口排队,这个判断基于一个核心事实:负载均衡解决的是流量分发和边界安全,而内网直连解决的是延迟和吞吐,下面拆开讲清楚,什么场景下该走门卫,什么场景下该直接敲门。
内网服务暴露公网,负载均衡入口为什么是必需品
先把最硬核的场景摆出来:你的服务要被外网访问,比如小程序后端、App接口、官网API,这时候负载均衡不是可选项,是刚需,行业共识认为,暴露在公网上的服务,没有负载均衡层等于把家门钥匙挂在门口。

安全层不能裸奔
内网服务直接暴露公网,意味着你服务器的真实IP直接面对全网扫描,攻击者拿Nmap扫一遍,端口开放情况、操作系统指纹、中间件版本全暴露,有了负载均衡入口,公网流量先打在负载均衡上,后端服务器IP被隐藏,攻击者看到的是一个“虚拟门牌”。
具体落地上,负载均衡能干的脏活很多:
- SSL证书卸载:证书统一放在负载均衡上,后端服务器不用处理加解密,节省CPU开销
- DDoS基础过滤:四层和七层负载均衡都能扛住一定规模的SYN Flood和CC攻击
- 访问黑白名单:直接在入口层封IP,不用登录每台后端服务器
- 协议校验:七层负载均衡能过滤恶意HTTP头、SQL注入特征
多活和容灾必须有入口
假设你的内网服务部署了两台服务器,一台在香港,一台在上海,用户访问时,流量需要智能分流到就近节点,如果没有负载均衡入口,DNS轮询只能做到“半死不活”的随机分发,某台机器挂了,DNS缓存还没刷新,用户一直报错。
负载均衡的健康检查机制能自动摘掉宕机节点,把流量切到健康节点,这个过程对用户无感知,运维也不用半夜爬起来手动改DNS。
弹性伸缩不靠手
业务大促时流量翻倍,你扩容了五台后端服务器,如果流量直连服务器IP,新扩容的机器怎么接入?改上游调用方的配置?不现实,负载均衡入口天然支持后端节点动态增删,新机器加进去,负载均衡自动把流量分过去,旧机器下线也只需要踢出节点池。
核心结论写在这里:凡是涉及外网流量进入内网服务,负载均衡入口就是“单点中的非单点”,它必须存在,而且应该做成双活或三活的架构。
纯内网调用,直连还是走负载均衡
这是另一个高频场景:服务A调用服务B,两边都部署在同一个内网环境,比如Kubernetes集群内,这种情况要不要经过负载均衡入口?答案是:能直连就直连,别绕路。
延迟和资源开销的账要算
每次请求经过负载均衡,就多一次网络跳转,即使内网延迟只有0.1毫秒,大量请求叠加起来,负载均衡的CPU和连接数也会成为瓶颈,尤其是现在微服务拆得细,一个用户请求背后可能有十几次服务间调用,全都挤在负载均衡上,负载均衡成了“堵车路口”。
业内专家指出,在同等硬件条件下,内网直连的延迟普遍比过负载均衡低20%到40%,吞吐量高出30%以上,你可以做个简单压测验证:用wrk打内网接口,直连IP和走负载均衡Virtual IP各跑一轮,数据说话。
Kubernetes环境里的“伪直连”
在K8s环境里有个微妙的情况:Pod间的访问如果走ClusterIP,其实已经过了kube-proxy的转发,但这不算真正的负载均衡入口,因为流量转发发生在内核态,不像Nginx那么消耗资源。
实践中更推荐用Headless Service配合DNS直连:
- 避免kube-proxy的iptables规则损耗
- Pod IP直连,延迟最低
- 缺点是调用方需要自己实现容错和重试
什么情况内网调用也该走负载均衡
- 后端是多实例部署,且调用方不关心具体实例是谁(典型的是无状态API)
- 需要统一做金丝雀发布或蓝绿发布,通过负载均衡控制流量权重
- 内网服务间需要mTLS双向认证,用负载均衡集中管理证书比每个服务都配一遍省事
这里给一条判断标准:如果你调用服务时不需要知道对方有几台机器,那就让负载均衡告诉你;如果你需要精确控制每个实例的流量,就直连。
内网服务负载均衡部署方案:Nginx和Kubernetes怎么选
很多团队卡在“用什么实现负载均衡入口”这个问题上,这里给出从实际需求倒推的方案选择,不搞“技术信仰”。
自建Nginx方案
适合规模不大、没有专业运维团队的场景,Nginx做七层负载均衡,配置直观,排错简单,你可能需要这样的配置结构:
upstream backend_pay {
    server 10.0.1.10:8080 max_fails=3 fail_timeout=30s;
    server 10.0.1.11:8080 max_fails=3 fail_timeout=30s;
    keepalive 64;
}
server {
    listen 443 ssl;
    server_name api.example.com;
    ssl_certificate /etc/nginx/ssl/server.crt;
    ssl_certificate_key /etc/nginx/ssl/server.key;
    location /pay/ {
        proxy_pass http://backend_pay;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
}要点是max_fails和fail_timeout的配合,确保后端节点宕机后自动剔除,health_check模块也可以启用,但注意它需要商业版Nginx Plus才支持,开源版得装第三方模块。
云负载均衡方案
如果你用的是云厂商的服务器,比如简米云、酷番云、华为云,直接用云上的SLB(Server Load Balancer)或者CLB(Cloud Load Balancer)更省心,云负载均衡扛得住大流量攻击,SLA能到99.95%以上,不用自己维护设备,价格上,按实例规格和带宽计费,小规模业务一个月几百块就能搞定,比自建Nginx加公网带宽的成本低。
Kubernetes Ingress方案
容器化部署的团队不用纠结Ingress Controller选型,生产环境不要用Nginx Ingress,直接上云厂商的ALB Ingress或者自建Ingress NGINX+MetalLB,为什么?NGINX Ingress的社区版稳定性和性能上限都存在不确定性,尤其在高并发场景下,它会自己变成“胖节点”。
操作路径参考:
- 部署Ingress NGINX Controller(用Helm安装最省事)
- 创建Ingress资源,绑定域名和后端Service
- 配置TLS证书到Secret
- 设置
nginx.ingress.kubernetes.io/proxy-connect-timeout和proxy-read-timeout两个关键注解
内网这个维度考虑下沉,负载均衡跟网关先上哪个
有对比才有决策依据,很多团队在搭内部微服务架构时,分不清负载均衡和API网关的职责边界,常常导致重复建设,或者关键短板漏掉。
负载均衡与网关差异对比
| 维度 | 负载均衡入口 | API网关 |
|---|---|---|
| 核心职责 | 流量分发 | 协议转换与策略控制 |
| 部署层级 | L4/L7 | L7 |
| 典型设备 | Nginx/云SLB/F5 | Kong/APISIX/ShenYu |
| 主要功能 | 健康检查、SSL卸载、IP白名单 | 鉴权、限流、动态路由、灰度发布 |
| 性能损耗 | 较低 | 较高(需要解析应用层内容) |
| 适用场景 | 大量真实业务流量入口 | 需要精细管控的API调用 |
判断标准很简单:给前端App或浏览器用的入口,用负载均衡;给业务方(可能是别的团队)提供的API能力,用API网关,前者扛流量,后者管规则,两者不是二选一的关系,经常是负载均衡在网关前面一层,组成双层入口。
有一种常见误解是“有了k8s Service就不再需要负载均衡”,实际上Service只是集群内部的路由规则,集群外部流量要进来,还是需要Ingress或者LoadBalancer类型的Service。
全国部署、跨地域场景下的负载均衡是不是也会成为瓶颈
如果你服务的用户分布在全国各地,比如北边访客、南边商户、西边运营,只用一个入口的负载均衡,各地跨网延迟很伤人,这时候看LVS挂载多个后端节点,或者直接上云厂商的全球负载均衡(GSLB)方案。
GSLB做的是“入口前面还有入口”,它根据用户的地理位置和运营商线路,把请求调度到最近机房对应的负载均衡入口,这样用户在广东访问,流量就不需要绕道北京再转回来,对降低首屏耗时意义很大,很多APP能做到全国平均首屏启动速度小于5秒,靠的就是GSLB里的地域调度。
如果自己搭建,推荐用Keepalived+LVS+Nginx串联
的方案:LVS挂在最前面,负责四层转发和VIP漂移,Nginx在LVS后面做七层路由,这个方案在业内非常成熟,多机房的流量调度稳定性值得信赖。
关于负载均衡的成本:一年花多少,先别急着关
做了决策后,很多人会问:负载均衡一年多少钱,这一个入口到底值不值?
有两条成本路线:
- 自建路线:一台2核4G云主机(约每年1000-2000元)+ 公网带宽(按流量计费,每GB约5-1元) ,或者用物理机加F5(设备费几万到几十万不等)小团队和初创期选这条,更可控
- 云负载均衡:按实例规格缴费,例如按固定带宽计费,5Mbps带宽的单实例全年成本大概在3000-6000元之间;包年套餐会打折,比按量付费省很多
算一下:如果服务一天有100万次调用,云负载均衡的单价摊到每次调用上,成本微乎其微,加上运维时间的节省,这笔支出很值得,唯一要警惕的是“买大不买小”的惯性,起步阶段选够用规格就行,云负载均衡大多支持在线升配,没必要为了想象中未来的流量提前付费。
内网服务暴露的决策说白了就是一句话:公网进来的流量,让门卫把关,负载均衡必须作为入口;内网服务之间的流量,别过门卫,直连快进快出,把这个边界划清楚,安全性和性能就都能兼顾,也不会为了“架构完整”而平白增加一次网络跳转。
Q&A:内网服务通过负载均衡暴露安全吗
问:我的服务只有办公网能访问,还需要加负载均衡入口吗?
如果只是少数同事访问,且后端就一台服务器,直连IP并配置防火墙白名单就够了,但团队超过5个人,或者服务开始承载核心业务数据,建议还是用负载均衡,原因是:办公网不等于绝对安全,同事的电脑中毒后扫描内网,直连的服务器就是活靶子,负载均衡入口能隐藏后端IP,还能统一做访问审计,一台1核2G的小机跑Nginx就能搞定,投入很低。
问:内网服务走负载均衡会不会影响性能?
要看流量类型,如果是文件传输、大数据同步这类高吞吐场景,走负载均衡会明显受限,因为Nginx单机转发能力有上限,大约几Gbps,但如果是常规的HTTP API,负载均衡带来的延迟增量在微秒级到毫秒级,几乎无感知,建议先压测直连和过负载均衡两种情况,看平均延迟差值是否在你的容忍范围内,多数场景下,业务端的网络IO耗时远大于负载均衡引入的损耗。
问:负载均衡入口挂了怎么办?
这就是你没做高可用的代价,生产环境必须部署至少两台负载均衡节点,用Keepalived做VIP漂移,一台宕机,另一台自动接管,云厂商的负载均衡默认就是多可用区部署,不用自己操心,如果你在自建环境,至少做到一主一备,避免负载均衡本身成为单点故障源。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/634664.html