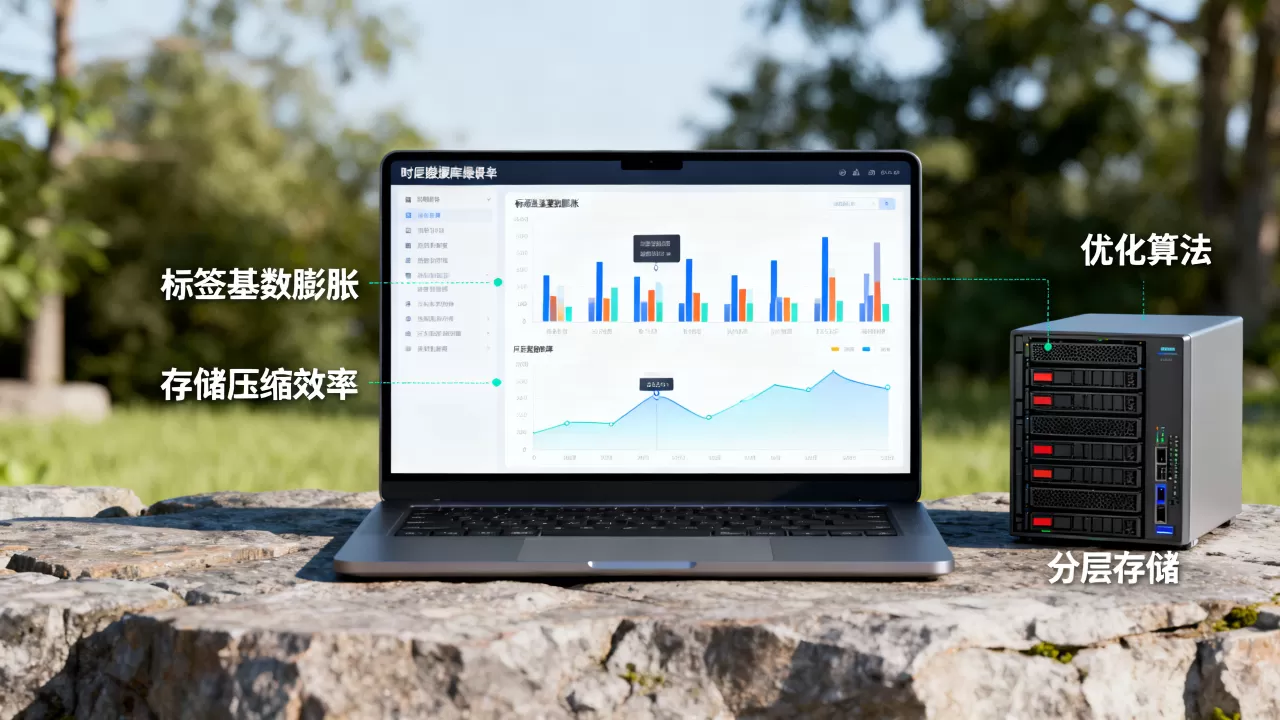
时序数据库标签基数膨胀会直接拖慢存储压缩效率高基数标签破坏字典编码和倒排索引的重复性,让压缩算法失去可压缩的局部模式。
时序数据库标签基数怎么优化:先搞懂它如何拖慢压缩
时序数据库里的标签(tag)和字段(field)分工本该很清晰,标签负责把数据切分成可检索的分组,字段负责存储随时间变化的值,低基数标签像“机房”“城市”“设备型号”,不同值数量有限,每个标签值下面能聚拢大量连续数据点,高基数标签则相反,像“UUID”“会话ID”“工单号”“哈希值”,几乎每条写入都带一个全新值。

标签基数膨胀的本质,是标签值组合数量被高基数标签快速抬高,数据库内部要用倒排索引记录每个series的位置,用字典编码存储标签值,压缩算法最喜欢连续重复、可预测排序的数据块,高基数标签一多,连续写入的数据被拆散到大量series块里,字典项变多,倒排索引变碎,压缩器在同一数据块里能找到的重复前缀和连续相同值大幅减少,结果就是压缩率掉下来,存储和内存同时承压。
标签基数膨胀的典型场景
- 把设备每次重启生成的随机ID写进标签,重启一次就新增一批唯一series。
- 把用户访问令牌(token)作为标签值,令牌本身就是为了不可预测而存在。
- 把MES系统里的工单号当标签,工单号每天新增大量唯一值。
- 北京工业互联网园区里的多租户设备监控项目,把租户ID、设备ID、采集批次号全塞进标签,几个月后series数快速突破百万级。
这些场景里,开发者一开始往往只看到查询方便,忽略了压缩和索引的长期代价。
标签基数膨胀到压缩失效的链路
- 标签基数升高,series数量成倍增加。
- 每个series独立维护字典项和索引元数据。
- 倒排索引膨胀,占用的内存和缓存空间被挤占。
- 数据块内部同列值的重复次数下降,压缩窗口无法命中较长重复片段。
- 压缩率下滑,写入放大和读取放大同步上升。
行业共识认为,时序数据库的标签应保持低基数、高区分度,字段则承担变化频繁的值,把唯一性交给标签,等于把压缩器的作业纸撕成碎片。
时序数据库存储压缩效率低的原因:标签基数只是其中一个推手
标签基数膨胀确实最常见,但它不是唯一原因,实际生产环境里,几个因素叠加起来才会让存储压缩效率掉得特别快。
时间戳乱序与标签膨胀叠加
乱序数据会打散已经压缩好的块,强制数据库重写和重新压缩,如果乱序比例不低,同时标签基数又高,每次乱序写入都会触碰大量小series块,小块的压缩收益本来就很低,反复重写更是雪上加霜。
数据类型选择错误放大压缩缺陷
把状态码、布尔值或者枚举值存成字符串标签,字典编码的美好设想会被破坏,字符串本身占据更多空间,压缩器需要额外处理变长数据,高精度小数虽然不直接涉及标签,但位宽更大的数值类型会减少同块内可压缩的连续零位和重复字节模式。
压缩块大小设置不合理
不同时序数据库提供压缩块或分段参数,块设置过小,字典头和索引头的开销占比升高;块设置过大,写入缓冲和内存压力上升,高基数标签下,小块数量极多,压缩头开销会吃掉相当一部分存储收益。
工业物联网时序数据库选型对比:高基数标签下的产品差异
不是所有时序数据库对高基数标签的容忍度都一样,索引模型、存储组织方式、压缩实现各不同,选型时会直接影响长期存储成本。
| 产品 | 标签索引机制 | 高基数标签表现 | 适用场景 |
|---|---|---|---|
| InfluxDB | 倒排索引,series信息常驻内存 | 内存占用随基数快速上升 | 中小规模监控 |
| TimescaleDB | 基于PostgreSQL索引,支持块级压缩 | segmentby放高基数列会生成大量小块 | 关系型数据分析 |
| TDengine | 子表模型,标签元数据独立存储 | 中等高基数下表现较稳,极端基数仍需控制 | 物联网设备监控 |
| Apache IoTDB | 设备路径加传感器建模 | 路径层级过多会产生大量序列 | 工业设备时序管理 |
这个对比不是简单判断谁更好,不同产品对“高基数”的定义也有差异,一个在监控场景里能扛住十万series的库,放到工业物联网千万级标签组合场景里可能就会吃力。
国产时序数据库价格对比:标签基数膨胀的隐性成本
多数国产时序数据库开源版免费,云托管和企业版按节点、内存、存储规格计费,高基数标签不会直接改变单价,却会通过资源占用推高隐性成本。
- 索引内存占用增加,云实例被迫从标准规格升级到高配规格。
- 压缩率下降,对象存储或云盘使用量上升。
- 写入放大增加CPU计费时长。
- 查询时扫描更多series,计算资源消耗变大。
算一笔隐性账
以常见的云时序数据库为例,某团队最初将高基数UUID放进标签,内存占用从数GB涨到数十GB,实例规格不得不从基础版升到高配版,后来把UUID改成字段存储,内存和磁盘占用明显回落,云账单也同步下降,国产时序数据库价格对比中,标签设计不当带来的额外成本,往往比软件授权费本身更值得关注。
降低标签基数的实操步骤
控制标签基数不是靠运气,而是靠一套可以执行的检查、改造、监控流程。
检查当前标签基数
在InfluxDB 1.x里,直接查看series数量:
SHOW SERIES CARDINALITY
SHOW TAG KEYS FROM "sensor_data"
SHOW TAG VALUES FROM "sensor_data" WITH KEY = "device_id"
TimescaleDB可以统计去重值:
SELECT count(DISTINCT device_id) FROM conditions;
SELECT hypertable_size('conditions');
TDengine可以查子表数量:
SELECT COUNT() FROM information_schema.ins_tables WHERE db_name='your_db';如果series数量接近唯一标签组合数的理论上限,说明标签设计已经失控。
把高基数标签降级为字段
原始写入把trace_id放进标签:
insert sensor_data,device_id=abc123,trace_id=9f8e7d6c value=23.4修改后,trace_id移到字段:
insert sensor_data,device_id=abc123 trace_id="9f8e7d6c",value=23.4设备分组的语义不变,series数量大幅降低,查询时如果需要按trace_id过滤,可以在应用层先查设备,再扫描字段,牺牲一点查询便利,换来存储压缩率提升。
调整压缩策略与块大小
TimescaleDB的压缩段键设置很关键:
ALTER TABLE conditions SET (
  timescaledb.compress,
  timescaledb.compress_segmentby = 'device_id',
  timescaledb.compress_orderby = 'time DESC'
);
SELECT add_compression_policy('conditions', INTERVAL '7 days');
compress_segmentby只放低基数列,比如设备ID、地区,高基数列进入segmentby会让压缩后的块数量激增,压缩效率不升反降。
定期清理过期标签值
在InfluxDB里设置保留策略:
CREATE RETENTION POLICY "rp_30d" ON "sensor_data" DURATION 30d REPLICATION 1 DEFAULTTDengine可以按子表设置保留时间,或定期删除过期的超级表数据,过期数据不及时清理,旧的标签组合会持续留在series文件和索引里,拖慢新的压缩任务。
存储压缩效率的监控信号
数据库运维中要盯住这些信号:
- TSM文件或压缩块大小增长速度明显快于原始数据量。
SHOW STATS里的series cardinality持续上升。- 写入延迟增加,但磁盘IO没有饱和。
- 重启数据库时元数据加载时间明显变长。
- 同样的数据量,压缩前后大小比例远低于同场景低基数配置。
出现这些信号,先检查标签设计,再调整压缩参数,直接扩容通常只能暂时盖住问题。
Q&A
时序数据库标签基数膨胀怎么判断已经影响压缩效率?
观察存储层指标,如果TSM文件或压缩块大小增长速度明显快于原始数据量,SHOW SERIES CARDINALITY接近唯一标签组合数,同时内存占用随写入持续上升,基本可以判断高基数标签已经拖慢压缩。
时序数据库存储压缩效率低怎么办?需要马上更换时序数据库吗?
先优化schema,把高基数标签改成字段,检查压缩段键和保留策略,再做一轮压测对比,多数情况下不需要换库,只有产品索引模型本身无法绕过高基数标签时,才根据工业物联网时序数据库选型对比结果考虑迁移。
工业物联网时序数据库选型对比中,高基数容忍度是决定性指标吗?
不是唯一指标,但对长期存储成本影响很大,同一数据集下,不同产品对高基数标签的索引开销可能相差较大,需要结合写入模型、查询模式和部署环境一起评估,没有一款时序数据库可以完全忽略标签基数,最终都要回到合理的标签设计。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639389.html