当应用需要稳定的网络标识、独立的持久化存储、严格的有序部署与扩缩容时,必须使用有状态副本集;反之,若应用实例完全对等、数据可丢弃或存储于外部中间件,则普通无状态部署更合适。这是Kubernetes选型的铁律,搞混这两者,轻则运维噩梦,重则数据丢失,本文直接拆解判断逻辑与实操场景。
先看本质:有状态与无状态到底差在哪
普通无状态部署(Deployment)管理的Pod像一次性纸杯:随用随扔,名字随机,IP随机,数据不落地,你有三个副本,挂了一个,控制器马上拉一个新的顶上,新Pod名字和IP都变了,但没人关心,因为所有Pod共享一套配置,处理同样的请求。
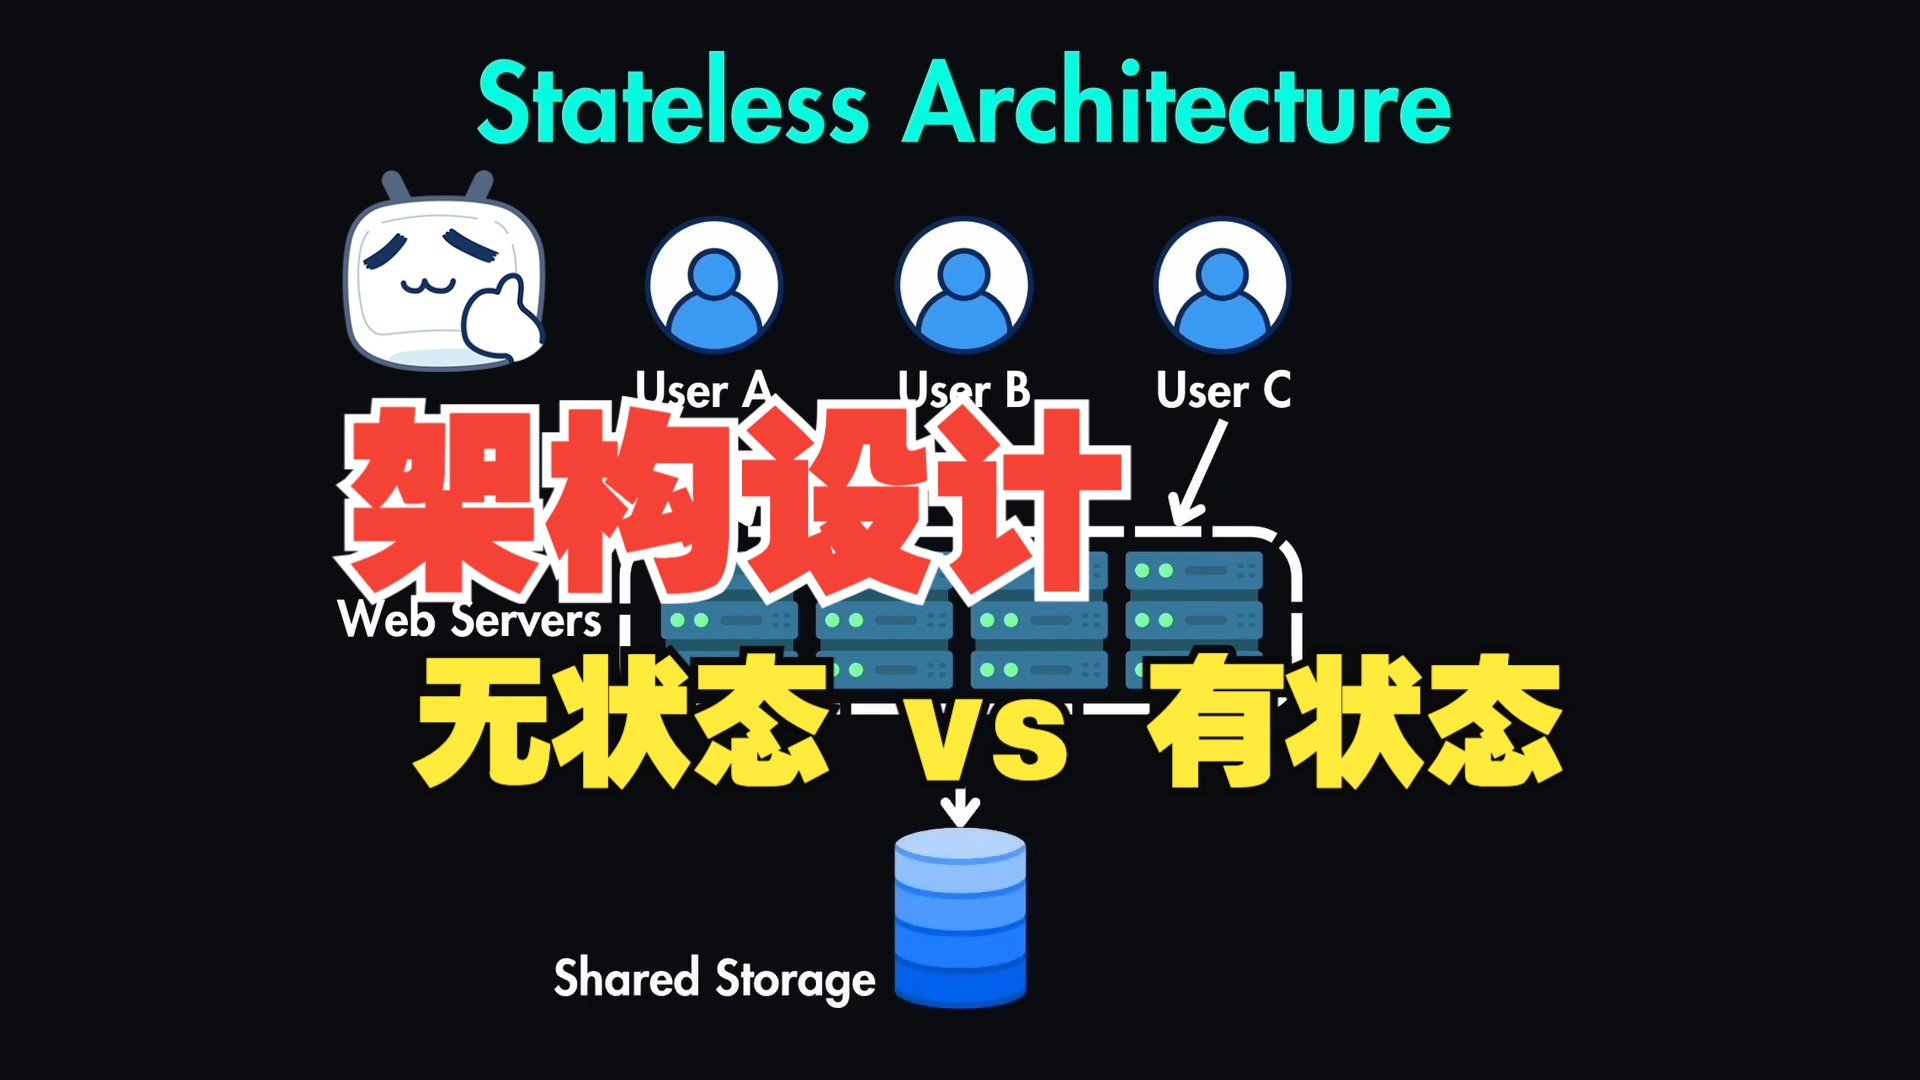
有状态副本集(StatefulSet)管理的Pod则像工牌上的编号:每个Pod都有自己的身份,这个身份由三件套绑定稳定的网络标识(Pod名固定,对应DNS名固定)、独立的持久化存储(每个Pod绑定自己的PVC)、有序的启停策略(扩容从0到N逐个建,缩容从N到0逐个删),用了StatefulSet,哪怕Pod被删除重建,名字和数据卷依然原样恢复。
这里有一个关键认知:并非所有需要存储的应用都适合StatefulSet,不少团队把MySQL直接扔给Deployment并用网络存储,也能跑,但一旦遇到节点故障,Pod漂移后需要手动改配置或依赖外部服务发现,运维成本极高,StatefulSet解决的就是”身份和数据必须绑定”这一核心诉求。
什么业务场景必须用有状态副本集
分布式数据库与键值存储
数据库是StatefulSet的头号适用对象,以常见的MySQL主从集群为例:主库和从库有明确的角色差异,从库需要知道主库的地址来同步日志,如果使用普通无状态部署,Pod的IP在重建后会变化,主从关系会立刻断裂,DBA需要手动修复。
使用StatefulSet组合Headless Service,主库Pod的固定DNS名(例如mysql-0.mysql-svc.namespace.svc.cluster.local)天然成为主从同步的连接点,从库扩容时,按序号从mysql-1、mysql-2逐个拉起,管理员可以在容器启动脚本里根据Pod名后缀判断自己是主还是从,自动执行初始化流程。
同类场景清单:
- Redis Cluster:每个节点需要固定身份和数据持久化
- ZooKeeper / Etcd:集群选举依赖稳定的节点ID,且节点必须记录投票状态
- Cassandra / MongoDB分片集群:分片与副本的身份需要长期存在
消息队列与协调服务
Kafka、RabbitMQ这类消息中间件,分区数据必须持久化到本地磁盘,更为关键的是,Kafka的分区Leader选举依赖Broker在ZK或KRaft元数据中的唯一ID,如果Broker Pod重建后名字和IP都变了,元数据感知会失效,StatefulSet的序号机制保证每个Broker有确定的身份标识,配合PersistentVolumeClaim的保留策略,节点故障后原地拉起,分区数据不丢。
行业共识认为,生产环境部署消息中间件和分布式协调服务,使用StatefulSet是底线操作,用Deployment这些组件会埋下极大的数据一致性隐患。
需要稳定成员关系的应用
举例:ElasticSearch集群(节点名固定,分片分配依赖节点列表),举例:Consul、Nacos等注册中心(需要Raft共识,节点地址必须固定),举例:部分自研的有状态批处理任务(需要按序执行,且任务进度落盘)。
判断口诀:你的应用启动配置里是否写死了同伴的地址?是否依赖本机磁盘上的归档数据?是否有主从/选举角色?命中任意两条,就选StatefulSet。
什么时候坚持普通无状态部署
无状态微服务与API网关
典型的互联网后端服务(订单服务、用户服务、鉴权服务)遵循无状态设计原则,会话数据在Redis里,业务数据在MySQL里,此时应用的所有Pod完全等价,杀掉一个再拉起一个,对业务毫无影响,用Deployment管理,配合HorizontalPodAutoscaler可以随时乱序扩缩容,搞滚动更新时也能先建新再杀旧,非常灵活。
定时任务与一次性批处理
CronJob应用场景通常不需要固定身份,但需要注意:如果你的批处理任务需要恢复断点,且断点信息保存在本地磁盘而未外置存储,那么用StatefulSet也是一条出路,但更多情况下,把断点状态写入对象存储或Redis,能让批处理任务真正的无状态化。
计算密集型的临时负载
比如视频转码Worker、日志清洗任务,这类负载跑完即焚,甚至不需要持久化存储,强行使用StatefulSet反而带来副作用:缩容顺序被强制规定,比如从顺序为3、2、1的Pod往下删,可能导致繁忙的进程先被终止,而Deployment可以自由缩容任意副本,资源调度更加均衡。
这类场景的特征:
- 进程不持有必须恢复的内存态
- 数据通过消息队列或对象存储流转
- 对外暴露接口通过Service负载均衡,无单点登录需求
有状态副本集使用时的三个关键注意事项
存储编排:必须提前规划好StorageClass
这是部署运维中高频踩坑的环节,StatefulSet本身不创建存储,它依赖PVC模板(volumeClaimTemplates)动态创建卷,你需要事先确认集群里存在可用的StorageClass(例如云平台的SSD盘或自建的Ceph RBD),并且有合理的回收策略。
操作步骤:
- 用
kubectl get sc检查已存在的存储类 - 在StatefulSet配置中指定
storageClassName: your-sc-name - 确认PVC模板中的容量上限与性能备注符合预期
服务发现:需要显式创建Headless Service
许多初学者误认为StatefulSet自带服务发现,实际不是,StatefulSet必须搭配无头服务(即 clusterIP: None 的Service),才能给每个Pod分配稳定的DNS名称,无头服务是一个纯粹的”A记录列表”,每条记录格式为 podName.serviceName.namespace.svc.cluster.local,创建顺序是:
先建无头Service,再建StatefulSet。
扩缩容与升级更新策略
扩容和更新时,StatefulSet按序号从低到高逐个Pod操作;缩容时从高序号到低序号逐个删除,默认的更新策略 RollingUpdate 同样按顺序分段进行,这个机制保证只读副本(如从库)优先就绪,最大程度的保障数据副本的安全,如果需要快速调整,可临时改 podManagementPolicy: Parallel 让Pod并行启停(允许乱序时,可以使用Parallel),但务必确保应用本身不依赖严格顺序。
迁移场景下的判断与实操路径
存量Deployment如何迁移为StatefulSet
首先你的应用的数据能否外置?如果业务数据并不存本地,只是因为没有改造而用了Deployment,那么可以先考虑改造应用,让本地磁盘变为无状态缓存,如果无法改造,执行以下迁移流程:
步骤一览:
- 创建对应名字的无头Service
- 将Deployment的Pod模板复制为StatefulSet清单,移除无用的
replicas非必要调速字段 - 根据原Deployment的持久化挂载情况,手动创建PVC(或者使用
volumeClaimTemplates重新创建空卷,但这种情况需要数据迁移工具) - 设置
serviceName字段为无头Service名字 - 逐步调整流量,先扩容StatefulSet副本,后缩容Deployment副本,Golden Release发布策略适用
成本考虑:有状态并不一定更贵
单从云资源计费上看,StatefulSet和Deployment在同等规格下没有本质区别,费用差异主要来自存储,云平台普遍提供多种价格档位的磁盘类型,比如高效云盘和SSD云盘价格差异明显。如果你把StatefulSet用在仅需要固定身份而不需要高性能IO的场景(如协调服务、选举组件),选择低配云盘(如通用型SSD)完全够用,成本可以压得很低。
节点亲和性调度(例如把StatefulSet锁在某一台专用宿主机上)在自建K8s集群中很常见,这时你需要额外预留维护窗口,但总体费用是可控的。
最终决策:不同场景下该用有状态副本集还是普通无状态部署
| 维度 | 普通无状态部署(Deployment) | 有状态副本集(StatefulSet) |
|---|---|---|
| Pod身份 | 随机、可丢弃 | 固定序号、可找回 |
| 存储 | 不推荐挂载,数据易失 | 每Pod独立PVC,数据持久 |
| 扩缩容 | 乱序、快速 | 有序(或并行),可预测 |
| 更新策略 | 任意批量替换 | 按序滚动,从低到高 |
| 网络标识 | 无稳定DNS名 | 有固定成员DNS |
| 适用负载 | 微服务、批处理、网站后端 | 数据库、消息队列、共识服务 |
如果你依然拿捏不准,有一个更直接的测试方法:把Pod杀掉,如果业务在Pod重建后完全不受影响且无需人工干预,用Deployment;如果Pod重建后业务必须恢复原状、且依赖原PVC内的数据,用StatefulSet,关闭这个视频页面,去你的K8s集群里做一次删Pod实验,答案立现。
在实际选型过程中,很多团队会陷入一个误区:把无状态应用强行部署在StatefulSet上,只为了”以后好加存储”,这其实是一种过度设计。正确做法是先让应用不吃本地存储,再去选Deployment,如果应用吃存储,且是多角色集群,StatefulSet则是不二之选,这两种方案的关系,更像同一工具箱里的两把扳手,尺寸不同,用途各异,挑错工具不会让工作归零,但会让效率变得非常糟糕。
常见问题解答(Q&A)
有状态副本集与普通无状态部署在配置上的核心区别是什么?
核心区别在三个字段:serviceName(必须绑定Headless Service)、volumeClaimTemplates(声明创建持久卷的模板)、podManagementPolicy(默认OrderedReady,控制Pod启动顺序),普通无状态部署中没有单独的数据卷模板概念,一般通过共享存储类(如NFS)配合配置来提供临时数据盘,Pod不感知卷的归属权,StatefulSet中的PVC由Pod独立声索,声明周期和Pod解耦,保存在集群的 Namespace 中,Pod被删PVC仍在,这也是数据能在Pod重建后存活的原因。
选用有状态副本集是否必须使用云盘或本地盘?
不必,你完全可以使用NFS、CephFS或者对象存储提供的CSI驱动,是否选择有状态并不是由底层存储协议决定,而是由Pod是否需要独立且稳定的数据卷接入点决定,使用网络存储(如分布式NFS)可以降低单点故障风险,一次性挂载多个副本的卷,但需要注意网络存储的IOPS和延迟短板,生产数据库级别应用,通常建议选择高可用的块存储(云硬盘)来满足性能要求,但块存储的单节点绑定特性需要你维护好节点的调度规则。
有状态副本集的Pod被误删了怎么办?
凭证系统会自动按序号重新创建一个新Pod,并自动重新绑定原有的PVC,数据的完整性不受影响,如果新Pod调度到另一台节点上,K8s的卷管理器会将节点与PV重新驱动绑定,这个过程耗时取决于存储系统的挂载速度,建议你在移除Pod前先确认底层的PV没有被手动删除,因为StatefulSet并不会自动备份PV,在此基础上,重新创建的Pod会以原来的名称回到集群中,状态基本等同于一次快速重启。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640027.html