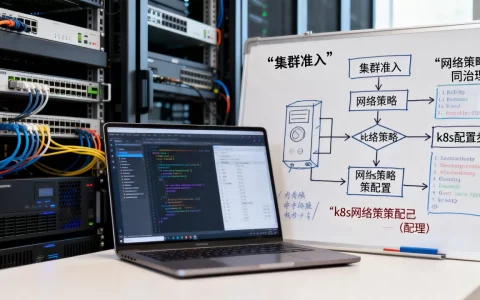
自愈负责发现坏节点并隔离,重调度负责把Pod迁到健康节点,二者衔接点在于节点被标记不可调度后Pod能否快速被驱逐和重建。
节点故障自愈和集群重调度区别在哪儿
节点故障自愈关注的是Node对象,集群重调度关注的是Pod对象,把两者混为一谈,排障时很容易跑偏。

- 节点故障自愈:检测节点心跳丢失、硬件错误、内核死锁等问题,给节点打污点、标记不可调度,必要时替换节点。
- 集群重调度:识别因节点不可用而无法运行的Pod,触发驱逐,调度器把Pod重新绑定到健康节点。
下面这张表可以直接看出差异:
| 维度 | 节点故障自愈 | 集群重调度 |
| 触发源 | kubelet心跳异常、节点状态Condition变化 | Pod长时间处于Pending或Terminating |
| 操作对象 | Node | Pod |
| 核心动作 | 打NoExecute污点、标记SchedulingDisabled | 删除或驱逐Pod、重新调度 |
| 恢复结果 | 节点被隔离或替换 | Pod在新节点上Running |
| 衔接风险 | 隔离太慢,Pod一直等待 | 驱逐太早,业务无意义中断 |
业内专家指出,多数线上故障恢复延迟不是调度器本身太慢,而是节点故障自愈把节点隔离得太晚,节点一直处于半死不活状态,重调度就被卡住。
Kubernetes节点故障自愈怎么实现:从检测到隔离
Kubernetes原生链路依赖三个组件:kubelet、node-lifecycle-controller、kube-scheduler,下面按实际操作顺序拆开讲。
故障检测:心跳丢失与Node Condition
kubelet每隔几秒向API Server报告心跳,node-lifecycle-controller根据node-monitor-grace-period(默认40秒)判断节点失联,超过这个时间后,Node会被标记为NotReady。
在节点上可以手动查看:
kubectl get nodes
kubectl describe node <node-name> | grep -A5 Conditions
如果看到Ready状态为False或Unknown,说明节点已被判定异常,此时Pod还不会立即迁移,真正触发迁移在下一步。
如果集群规模较大,还可以部署Node Problem Detector,它可以检测内核日志、网络异常、只读文件系统等系统级问题,通过Condition上报给控制面,这样故障检测范围比单纯心跳更宽。
隔离节点:NoExecute污点自动添加
节点NotReady达到一定时长后,node-lifecycle-controller会自动添加污点:
node.kubernetes.io/unreachable:NoExecute
node.kubernetes.io/not-ready:NoExecute
Pod如果没有设置自定义容忍度,默认容忍300秒后会被驱逐,这个默认值来自Pod的默认容忍策略。
查看节点污点可以用:
kubectl get node <node-name> -o jsonpath='{.spec.taints}'这一步就是节点故障自愈的核心动作,它不会修复硬件,只是把坏节点从调度池中摘除,摘除之后,重调度才能正常开始。
重调度启动:Pod驱逐与调度器接管
300秒容忍时间一到,kube-controller-manager开始删除该节点上的Pod,Deployment、StatefulSet等控制器会立即创建新的Pod,新的Pod通过调度器筛选,不会再落到有NoExecute污点的节点上。
如果Pod属于裸Pod,也就是没有控制器管理,删除后不会自动重建,这是衔接链路里最容易踩的坑,生产环境应避免直接创建裸Pod。
想让业务恢复更快,可以在Pod模板里显式设置容忍时间:
tolerations:
- key: "node.kubernetes.io/unreachable"
  operator: "Exists"
  effect: "NoExecute"
  tolerationSeconds: 60
这样Pod在节点失联后60秒就会被驱逐,而不是默认300秒,但风险也更大,后面会讲。
节点故障自愈需要多久?生产环境真实时间线
节点故障自愈需要多久,取决于三个参数和一个动作:
- node-monitor-grace-period:默认40秒,决定节点多久被标记NotReady。
- Pod tolerationSeconds:默认300秒,决定Pod多久被驱逐。
- 调度器扫描周期:通常秒级完成新Pod绑定。
- 镜像拉取时间:如果新节点没有镜像,业务恢复会额外延长。
按Kubernetes默认参数,多数情况下从节点宕机到Pod在新节点上重新运行,时间在5到7分钟区间,这不是绝对数字,实际会受网络分区、节点池扩容速度、镜像大小影响。
如果业务要求更快,可以缩短tolerationSeconds,但要注意网络抖动导致节点短暂失联时,Pod可能被过早驱逐,调整参数前必须在测试环境验证,尤其是数据库类有状态服务,频繁驱逐会触发主从切换,反而扩大故障影响。
节点故障自愈方案对比与成本考量
不同方案在节点故障自愈和集群重调度衔接上的表现不一样,从实现方式、恢复速度、维护成本三个角度对比:
| 方案 | 实现方式 | 恢复速度 | 成本特征 |
| Kube原生参数调优 | 修改node-monitor-grace-period、tolerationSeconds | 中 | 几乎无额外费用 |
| Node Problem Detector + Draino | 自定义检测条件并自动排水 | 较快 | 需要部署和维护组件 |
| Kured | 处理需要重启节点的故障 | 较慢 | 开源免费,功能单一 |
| 云厂商托管节点池自愈 | 云平台自动替换坏节点 | 快 | 按节点数付费,北京地区等地域价格有差异 |
在评估节点故障自愈方案成本时,北京地区多家生产集群的运维团队反馈,托管节点池的自动替换比手工脚本稳定,但价格会随着节点规模上升,纯开源方案没有授权费用,但需要投入人力编写故障处理脚本、维护监控告警。
行业共识认为,节点故障自愈方案没有银弹,小集群适合原生参数加脚本,大集群和多地域部署适合托管方案,核心不是选哪个工具,而是把检测到隔离再到重调度的链路压短。
生产环境节点故障自愈演练步骤
只配参数不演练,等于把风险留到半夜,下面是一套可执行的演练流程。
准备测试节点
选择一个非核心业务节点,确认它上面的Pod可以被迁移。
kubectl get pods -o wide --all-namespaces | grep <test-node>
模拟节点故障
停止kubelet或直接关闭测试节点。
systemctl stop kubelet观察节点状态变化
另开终端执行:
kubectl get nodes -w记录节点从Ready到NotReady的时间,确认是否符合预期。
观察Pod驱逐与重调度
kubectl get pods -o wide -n <namespace> -w记录Pod从Terminating到在新节点Running的时间,如果Pod长时间不迁移,检查是否缺少控制器、是否被节点选择器限制、是否资源不足。
恢复节点并清理污点
节点恢复后,先清理污点再恢复调度:
kubectl uncordon <node>
kubectl taint node <node> node.kubernetes.io/unreachable:NoExecute-
这一步很多团队会忘记,节点恢复后如果污点不清理,调度器不会把新Pod放上去,演练可以暴露这类低级错误。
节点故障自愈与集群重调度常见问题
节点故障自愈和集群重调度区别是什么?
节点故障自愈处理的是节点对象,动作是打污点和标记不可调度,集群重调度处理的是Pod对象,动作是驱逐并重新绑定到健康节点,两者必须串成一条链路,业务才能恢复。
Kubernetes节点故障自愈怎么实现更快恢复?
可以适当调低node-monitor-grace-period和Pod tolerationSeconds,但不要把参数调得过小,否则网络抖动会导致误驱逐,更快恢复还可以通过预拉取镜像、提前扩容节点池来实现,而不是只压参数。
节点故障自愈需要多久?
按Kubernetes默认参数,大多数场景下从节点宕机到Pod重新运行需要五到七分钟,具体时长由节点失联判定时间、Pod容忍时间、调度速度和镜像拉取时间共同决定。
节点故障自愈不是终点,集群重调度才是业务恢复的最后一棒,把心跳检测、污点驱逐、调度器反馈这三段链路调顺,才能真正缩短故障中断时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640268.html