无状态服务容器化走的是Deployment水平扩缩容、实例可随意替换的路径,有状态服务容器化必须绑定StatefulSet、持久卷和稳定网络标识,两条路径的本质区别在于是否要求“记住身份”和“保留记忆”。
K8s有状态应用和无状态应用区别先看服务“记不记事”
无状态服务像连锁快餐店的后厨,订单做完就忘,换一个厨师不影响出餐速度,有状态服务像医院病历系统,患者下次复诊必须调出上次记录,系统重启后还得找到原来那张病历表。
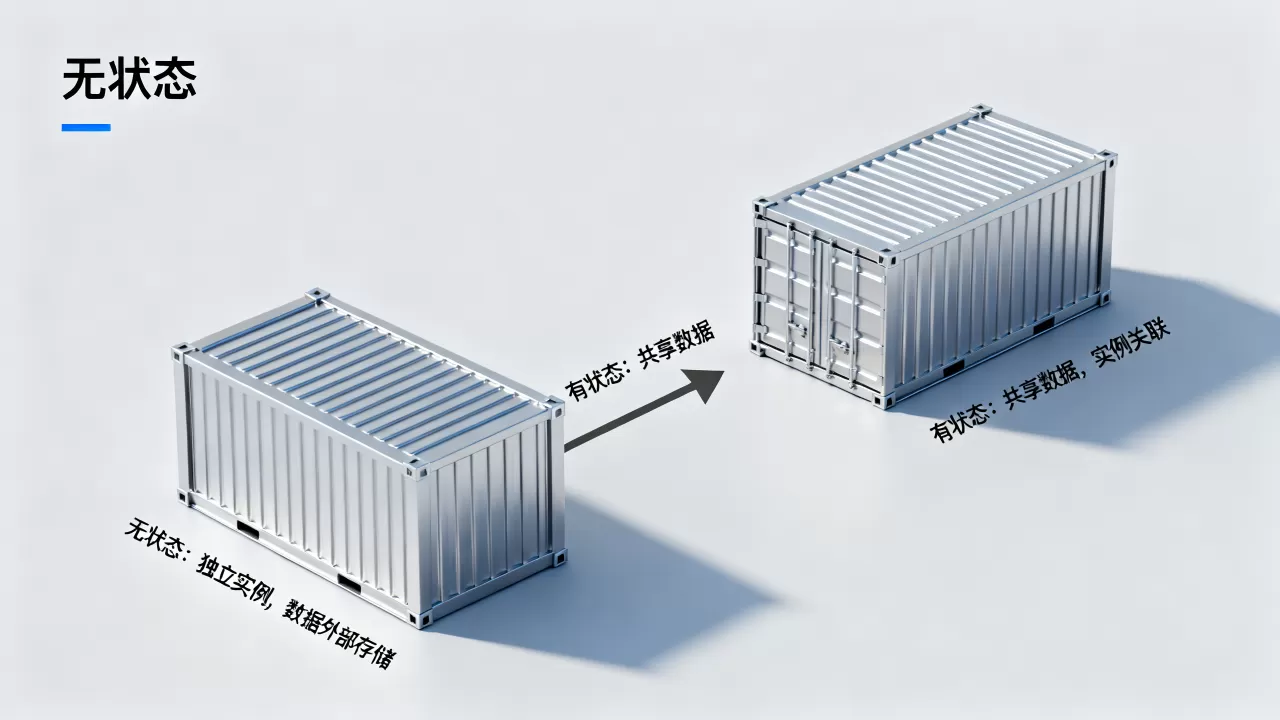
- 无状态服务的请求之间相互独立,实例不保存业务数据,或把会话数据放到Redis这类外部共享存储。
- 有状态服务的每个实例都有唯一身份,数据要么在本地磁盘,要么按分片规则摆放,实例和存储一一对应。
- 常见的无状态应用:Nginx、API网关、前端静态资源服务、无会话的微服务。
- 常见的有状态应用:MySQL、PostgreSQL、Kafka、Elasticsearch、Redis持久化集群。
判断路径之前先问三个问题:
- 重启以后数据能不能丢?
- 客户端是否依赖固定IP或稳定DNS名?
- 水平扩容时数据要不要自动分片或主从切换?
如果三个答案都是“否”,基本走无状态容器化路径;只要有一个“是”,就必须按有状态服务容器化路径设计。
| 对比维度 | 无状态服务 | 有状态服务 |
| 典型工作负载 | Deployment | StatefulSet |
| 扩缩容 | 无序、可同时增减 | 有序、从序号两端操作 |
| 存储 | 不需要持久卷,或共享外部存储 | PVC模板为每副本绑定独立卷 |
| 网络标识 | 随机Pod名、Service统一入口 | 稳定DNS名,如mysql-0.mysql |
| 重启影响 | 可任意替换,无数据损失 | 必须恢复原数据卷和网络身份 |
无状态服务容器化部署步骤为什么更短
用Deployment拉起无状态服务
无状态服务的容器化路径通常从镜像构建到Service暴露,几个操作就能跑起来。
- 编写Dockerfile,把编译产物和运行时依赖打进镜像。
- 执行docker build -t my-app:v1 .,然推送到私有镜像仓库。
- 创建deployment.yaml,核心字段写清replicas、image、resources和readinessProbe。
- 执行kubectl apply -f deployment.yaml。
- 创建Service,类型选ClusterIP或LoadBalancer,把流量转到Pod标签。
- 扩缩容直接执行kubectl scale deployment my-app –replicas=5。
无状态路径不用为每个Pod单独准备持久卷,配置文件通过ConfigMap或Secret注入,实例挂了以后新Pod可以替代,这种路径下,容器化改造费用一般多少也相对好估算,因为大部分工作集中在CI/CD接入和镜像优化上。
有状态服务容器化数据持久化方案怎么设计
存储卷必须是PVC模板而不是普通PVC
有状态服务容器化最容易踩的坑,是给所有副本挂同一个PVC,结果多个实例同时写一份数据,出现锁冲突甚至文件损坏。
正确路径是使用StatefulSet的volumeClaimTemplates字段,让控制器为每个副本生成独立PVC。
下面是一个简化后的StatefulSet关键配置结构:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
spec:
  serviceName: mysql-headless
  replicas: 3
  selector:
    matchLabels:
      app: mysql
  template:
    metadata:
      labels:
        app: mysql
    spec:
      containers:
      - name: mysql
        image: mysql:8.0
        volumeMounts:
        - name: data
          mountPath: /var/lib/mysql
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: ["ReadWriteOnce"]
      storageClassName: standard
      resources:
        requests:
          storage: 100Gi
执行kubectl apply后,每个Pod会自动拿到独立PVC,名称类似data-mysql-0、data-mysql-1、data-mysql-2,删除Pod时PVC不会自动删除,数据卷保留。
有状态服务还要配Headless Service
普通Service会给Pod一个虚拟IP,但客户端连接数据库时往往需要直连某个主节点或从节点,StatefulSet一般配合Headless Service使用,让每个Pod拥有稳定DNS名。
- 创建Service时把clusterIP设为None。
- Pod的DNS格式为:
. . .svc.cluster.local。 - 数据库主从切换时,从库通过固定DNS名找到主库,避免IP漂移导致连接串失效。
北京地区容器化服务商
在交付有状态服务时,通常也会把Headless Service和PVC模板作为标准检查项,防止后续扩容时出现数据链路断裂。
容器化改造费用一般多少受到哪些因素影响
无状态改造费用相对可控
无状态应用改造主要花在Dockerfile编写、CI/CD流水线打通、健康检查配置和Service暴露上,多数情况下,单个无状态应用从代码仓库接入到Kubernetes跑通,工作量集中在镜像构建和配置迁移,费用不会太高。
有状态改造费用明显更高
有状态服务改造不能只关注容器本身,还要额外设计数据持久化、备份恢复、主从切换、存储性能压测和故障演练,行业共识认为,容器化有状态服务必须把存储和网络身份放在同一设计层,否则后续扩容会变成事故现场。
费用差异主要来自以下几个方面:
- 存储选型:本地盘、云盘、分布式存储的性能和成本差异较大。
- 数据迁移:老系统数据导出、清洗、导入,以及增量同步窗口设计。
- 高可用方案:主从、集群、哨兵或操作员手动切换脚本。
- 压测与验收:有状态服务上线前通常要做故障注入测试。
北京地区容器化服务商一般会先做一次存储性能基线和容量评估,再给出改造方案。容器化改造费用一般多少没有统一报价,无状态项目按应用数计算,有状态项目往往按数据规模和可用性等级计算。
实操中怎么判断该走哪条容器化路径
无状态服务优先Deployment
只要服务不自己保存数据,或者数据放在外部对象存储、Redis、数据库中,就按无状态路径处理,Deployment天然适合滚动更新、快速回滚和水平扩展。
典型操作路径:
- 应用代码从环境变量读取外部依赖地址。
- 静态资源使用CDN或对象存储,不写入容器本地。
- 日志输出到标准输出,由采集组件统一收集。
- 配置中心或ConfigMap注入非敏感配置。
有状态服务优先StatefulSet
只要服务依赖本地磁盘、固定主机名或有序扩缩容,就按有状态路径处理,StatefulSet的启动和停止顺序能避免主节点被误删,这是有状态服务容器化的底线。
典型操作路径:
- 先定义StorageClass,确认底层存储支持动态供给。
- 再定义PVC模板,容量按数据增长预留。
- 配置Headless Service,确定Pod稳定DNS名。
- 初始化脚本通过ConfigMap挂载,不用环境变量传递密码。
- 备份策略使用云盘快照或数据库自带工具,不在容器内直接tar数据目录。
据CNCF公开资料显示,Kubernetes原生的StatefulSet已经成为有状态应用部署的标准控制器之一,实际落地时,有状态服务通常还需要配合Operator来管理主从切换和备份恢复。
无状态服务的容器化路径更像标准流水线,镜像构建、Deployment发布、Service暴露,节奏快且风险低,有状态服务的容器化路径必须提前设计存储、网络身份和生命周期顺序,少一步都会给生产环境埋雷,先分清服务类型,再选择工作负载控制器,比盲目追求全量容器化更实际。
Q&A:无状态服务和有状态服务容器化路径有何不同
无状态服务容器化部署步骤中最容易忽略什么?
最容易被忽略的是优雅停机和就绪探针,无状态服务虽然允许随意替换,但滚动更新时如果旧Pod还没处理完请求就被强杀,用户会看到连接中断,正确做法是在Deployment里配置terminationGracePeriodSeconds,并让readinessProbe在停止接收流量前先返回失败,等存量请求处理完再退出。
有状态服务容器化数据持久化方案一定要用StatefulSet吗?
不一定,生产环境强烈建议,有些团队用Deployment挂载单个PVC也能跑数据库,但缺少稳定DNS名和有序扩缩容,一旦Pod漂移到其他节点,数据卷可能无法挂载或出现双写,StatefulSet配合volumeClaimTemplates是更稳妥的默认路径。
K8s有状态应用和无状态应用区别在扩缩容时表现是什么?
无状态应用扩缩容时所有副本可以同时创建或同时删除,新Pod起来后立即加入Service后端接收流量,有状态应用扩容时从序号最小到最大依次创建,缩容时从序号最大到最小依次删除,保证编号较小的实例不会先被删掉,从而保护可能的主节点数据一致性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640336.html