微服务调用链超时传导放大,本质上是下游服务的“慢”在上游被“等”放大的过程,根治之道在于全链路超时预算、快速失败和容量隔离。
一次“正常”的超时,为什么会让整个系统雪崩
你负责的订单服务,平时响应稳定在 80ms 上下,突然有一天,下游的库存服务因为数据库慢查询,响应时间从 100ms 涨到了 5 秒,你这边设置的 Feign 调用超时是 3 秒,所以订单服务线程并没有立刻报错,大家都在等着 3 秒超时到来。
这时候,上游的网关超时是 5 秒,前端页面等待阈值是 8 秒,你想想看,整个链路里,每一个环节的线程都因为等待下游而被活活占住,用户量一大,订单服务自己的 Tomcat 线程池瞬间被打满,新请求根本进不来,只能排队,最终明明只是库存服务出了点小问题,结果订单服务、支付服务,甚至用户服务全都跟着“躺平”。
这就是超时传导放大的典型现场,行业内常说“雪崩没有一片雪花是无辜的”,在微服务架构里,每一层不合理的超时设置,都是那片雪花。
线程池耗尽,是超时传导的第一个连锁反应
大多数微服务框架,Spring Cloud 和 Dubbo,默认情况下同步调用的线程池大小是有限的,Tomcat 默认的 max-threads 在 200 左右,Dubbo 默认的 threads 是 200 或 400。
- 假设你的订单服务 Tomcat 线程池是 200,此时有 150 个线程都在等待库存服务的响应。
- 这 150 个线程既不干活,也不释放,直到 3 秒超时后才返回错误。
- 但 3 秒内,新请求还在不断进来,剩下的 50 个线程很快就用完了。
- 新请求开始排队,队列一满,直接抛 Connection refused 或者超时异常。
关键点在于:线程是微服务最宝贵的资源,它不像 CPU 可以分时复用,线程一旦被等待占用,就相当于从服务容量里永久划走了一块。
业内专家指出,解决超时传导问题,首先要区分“等待”和“计算”,面对下游响应慢,快速失败释放线程,比盲目重试重要得多。
重试机制,往往把故障放大到整个集群
很多团队为了防止偶发超时,会启用重试机制,Ribbon 默认会重试同实例一次,这套逻辑在单实例故障时有效,但在下游整体变慢时,重试就是火上浇油。
- 有 30 个上游服务同时调用库存服务,库存服务已经处理不过来了。
- 每个上游服务都设置重试 2 次,相当于库存服务要承受 3 倍于平时的流量。
- 库存服务本来只是慢,现在直接被打垮,变成了连接拒绝。
- 连接拒绝后,上游服务调用方抛出异常,又开始新的请求,形成恶性循环。
行业共识认为,重试只应该用于“连接型失败”或“网络闪断”,而不是“响应超时”,响应超时往往意味着服务端真的忙不过来,此时相当于在伤口上撒盐。
超时时间应该设置多少,这个难题怎么破
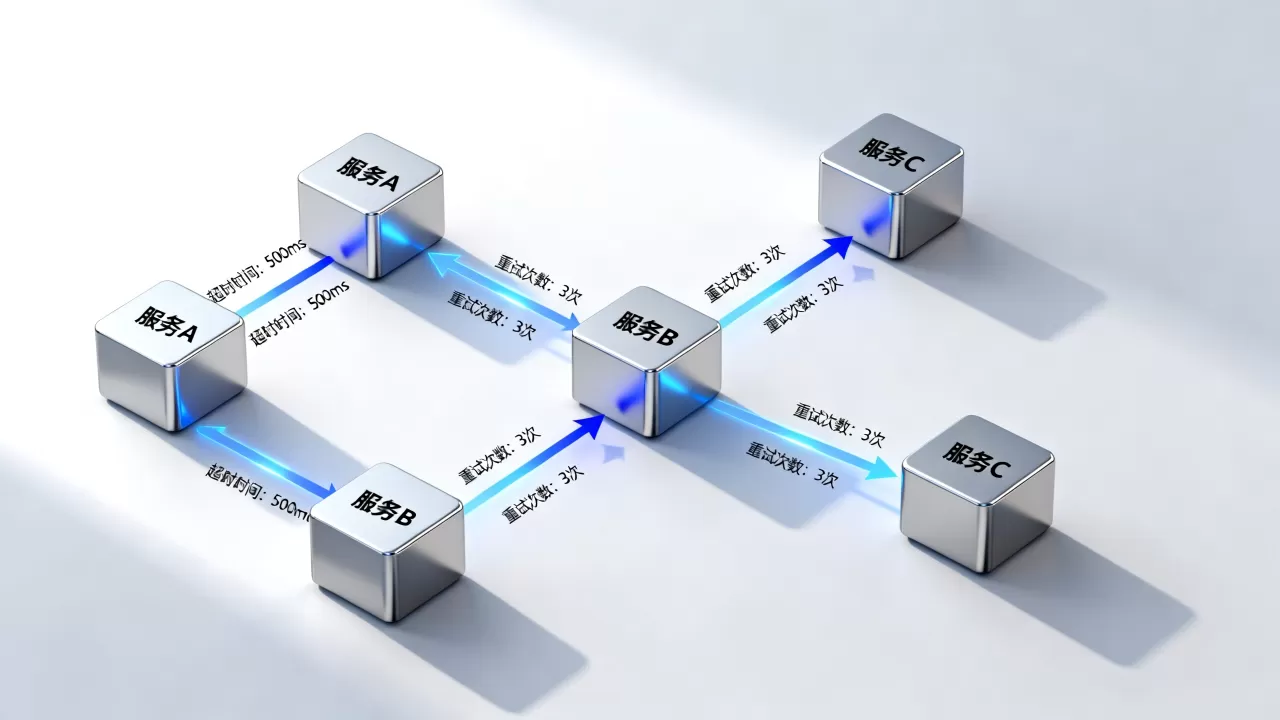
把超时时间固定写死成 3 秒或者 5 秒,是比较常见的做法,但不同接口的耗时模型完全不同,查询订单列表可能要 500ms,导出报表可能要 30 秒,统一设置超时时间肯定不合理。
用“超时预算”代替“固定超时”
从入口到出口,总体的时间预算是固定的,比如网关允许的端到端延迟是 2 秒,那么各环节如何分配呢?
- 网关调用订单服务,超时预算设定为 1 秒。
- 订单服务调用库存服务,超时预算只能占 600ms。
- 订单服务调用商品服务,超时预算只给 400ms。
一旦下游超时,上游会立即中断自己这部分等待,把错误返回给更上层,而不是傻傻等到 2 秒,这个思路,就是很多中间件里的“超时预算传递”机制。
根据 TP99 延迟动态调整超时
不要看平均响应时间,要看 TP99 和 TP999,平均响应时间可能被长尾请求拉高,但 TP99 更能反映大多数用户的真实体感。
- 监控库存服务接口的 TP99,比如近一周 TP99 是 300ms。
- 此时超时时间设置为 TP99 的 3 倍到 5 倍,即 1 秒到 1.5 秒,既能容忍正常的波动,又不会像 3 秒那样过长。
- TP99 数据一直在变,可以通过配置中心动态调整,无需发版。
超时是手段,降级才是目的
超时触发后的处理逻辑,比超时本身更重要,我们见过太多案例,超时时间改了又改,但还是雪崩,就是因为在超时后没有对应的降级动作。
- 库存服务不可用时,订单服务如果读不到库存,可以直接放行,允许超卖,后续通过消息队列异步对账。
- 推荐服务超时后,直接返回兜底的商品列表,而不是让整个首页卡死。
- 降级开关可以在配置中心一键打开,不需要改代码。
统计显示,很多微服务故障场景中,超时时间设置不合理导致的线程阻塞,是比下游本身故障更严重的风险点。
微服务调用链超时怎么排查,给你一套可落地的流程
排查超时传导,不能只盯着报错日志看,得从入口到出口全链路追踪。
第一步:看链路追踪,确认超时发生在哪一跳
用 SkyWalking 或者 Zipkin 查看 Trace 信息,重点看 Span 之间的消耗时间,如果一个上游 Span 的耗时和下游 Span 的耗时几乎一样,基本都是下游慢,如果上游 Span 耗时远大于下游 Span 耗时,多半是网络问题或线程池排队。
第二步:看线程池活跃数,判断是否线程堆积
连接对应中间件或使用 Java 自带的 jstack 命令导出线程快照。
jstack -l 12345 > thread_dump.txt
在 dump 文件里搜索下游调用相关的线程状态,如果大量线程处于WAITING状态,stack trace 停在了 java.util.concurrent 的 Future.get() 上,基本上就能断定是等待下游响应。
第三步:看下游服务自身的瓶颈
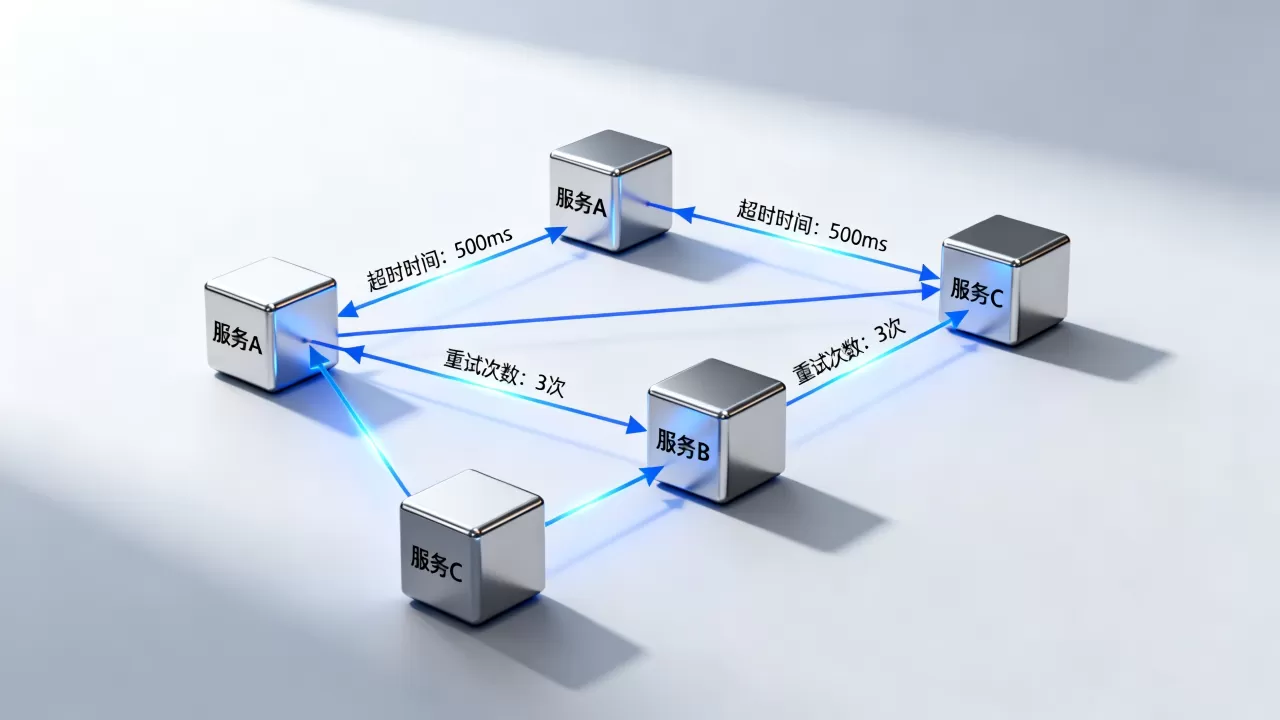
登录下游服务所在的机器,用 top 查看 CPU 负载,用 dstat 查看磁盘 IO,CPU 和 IO 都不高,那大概率是数据库拿不到连接,或者在做 Full GC,此时可以看 GC 日志,确认有没有 Allocation Failure 异常。
第四步:验证超时参数是否全局生效
初查之下,往往会发现某几个接口还是用的历史遗留的 30 秒超时配置,建议把超时配置统一收敛到一个配置中心里,用 Java 的 @RefreshScope 动态刷新,不要散落在各个服务的 application.yml 里。
| 层级 | 推荐超时区间 | 说明 |
|---|---|---|
| 网关 | 1s – 3s | 应当做端到端的最外层拦截 |
| 核心同步调用 | 300ms – 1s | 根据 TP99 灵活调整 |
| 非核心异步任务 | 5s – 10s | 不阻塞主链路即可 |
| 重试总时长 | 不得超过单次超时的 50% | 否则没有意义 |
信号量隔离与线程池隔离,到底选哪个
很多开发者只知道有熔断,不知道熔断背后还有隔离策略,Sentinel 和 Hystrix 都支持这两种隔离方式,选错了会让超时传导继续存在。
线程池隔离,适合慢依赖
线程池隔离:给下游依赖单独分配一个线程池,比如订单服务调用库存服务,最多只能用 20 个线程,库存服务慢到天荒地老,最多只占掉这 20 个线程,不会拖垮订单服务主线程池。
- 适合像数据库连接、第三方 API 调用这类不可控的依赖。
- 开销大,每个依赖都创建自己的线程池,内存占用和上下文切换的成本不低。
- 适合高并发核心链路。
信号量隔离,适合耗时短的依赖
信号量隔离:不是单独分配线程,只是控制进入某个调用的“许可证”数量,如果信号量用完,调用直接失败,不会排队等待。
- 适合本地缓存查询、耗时不长的 Redis 调用。
- 开销小,轻量级。
- 但不适合跑很慢而且阻塞的 I/O 操作,因为没有独立的线程池,一旦信号量被占满,新的请求直接快速失败,容易引发大量报错告警。
实操建议
如果资源充足,优先用线程池隔离;如果追求性能和资源利用率,对耗时在几十毫秒内的本地操作使用信号量,不管选哪种,隔离的核心是让故障的影响范围被“圈养”在一个可控范围内。
微服务超时时间怎么设置合理,记住这几条原则
服务上线前夕,架构师最常头疼的就是这个超时配置问题,你要懂每一层的角色定位。
入口层,有放大效应的同时也有盾牌作用
网关是流量的总入口,网关超时时间应该比内部任何一跳都要短,如果网关超时是 10 秒,内部任何服务超过 10 秒还没有返回,网关就会直接断开连接,这反而保护了内部资源,但前提是
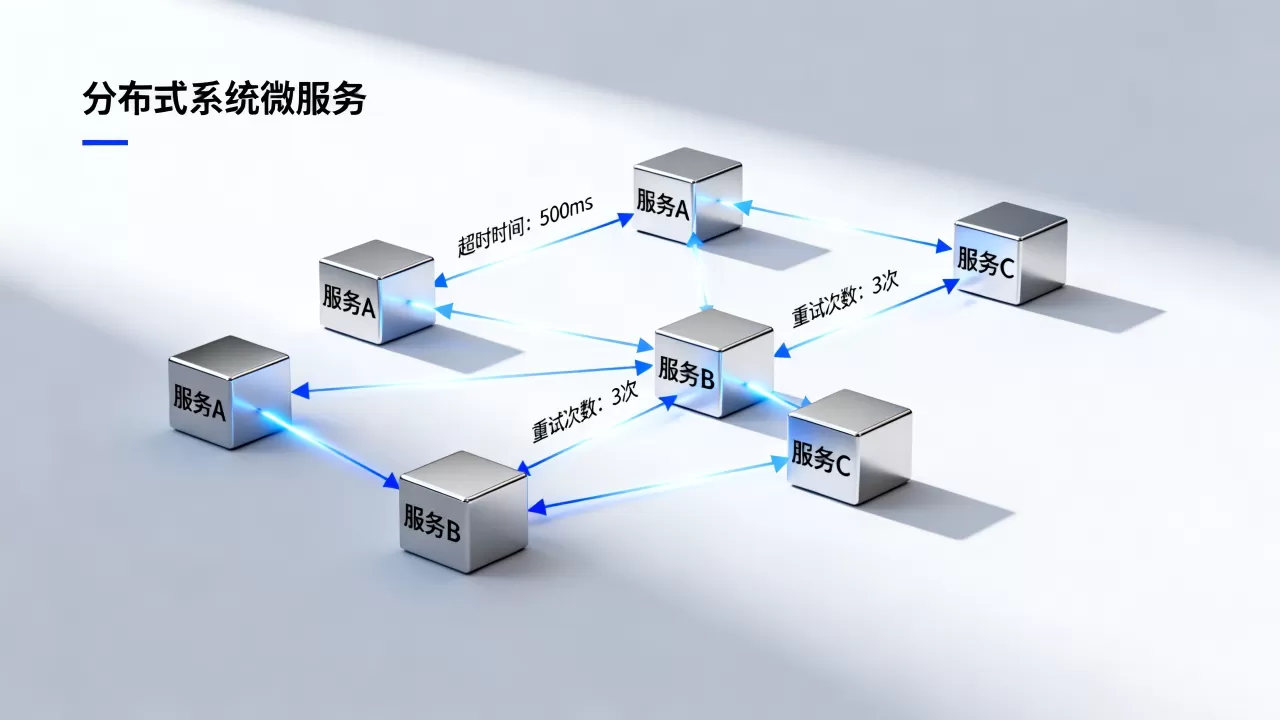
网关设置的时间要能覆盖绝大多数正常请求。
服务间调用,按 TP99 的倍数来
这是最稳定的一种取值方案,假设你统计出库存服务接口的 TP99 是 200ms,直接设为 200ms 容易误杀,设为 2 秒又太长,想要比较合理的值,可以考虑取 TP99 乘以 3 到 5,也就是 600ms 到 1s,这样既不会频繁误杀,也能把空闲线程的占用时间压到最短。
写操作与读操作要区别对待
不能因为查询接口慢,就把写接口的超时时间也一起放大,写操作往往伴随数据库事务,长时间占用数据库事务连接是致命的,写接口超时时间应压缩到读接口的一半甚至更低,比如读 1s,写 500ms。
面对成本与机器资源有限的情况,如何做取舍
很多业务团队在机器资源有限时,误以为“可以不设超时”,希望服务能一直等到下游恢复,这个思路大错特错,你在等待,流量一直在进来,你以为在止损,其实是在无限放大损失。
- 用有限的线程处理无限堆积的请求,相当于让所有调用方都陪你一起卡住。
- 与其大家一起等死,不如切掉一部分非核心流量,保住核心交易链。
- 针对核心接口,可以设定一个“最大并发阈值”,当超过阈值时直接返回“系统繁忙”,这比等待超时更快释放资源。
拿最常见的电商下单场景来举例,商品详情页的推荐位接口超时,可以不依赖主链路;但库存扣减接口超时,必须快速失败,非核心调用的超时时间可以设置很激进,200ms;核心调用的超时时间可以稍微宽裕,但也要小于整体预算。
FAQ:关于微服务调用链超时的三个高频疑问
为什么我设置了超时,服务还是被拖垮
超时参数生效的前提是线程没有被更底层的阻塞所困住,如果下游数据库连接池满了,连接获取本身就阻塞了 10 秒,那么你设置的 HTTP 超时 2 秒根本不起作用,因为线程卡在获取连接的环节,解决思路是给连接池也设置获取超时,务必小于整个调用链的超时预算。
如何避免重试机制成为超时放大的帮凶
重试只对“瞬时错误”有意义,比如网络闪断,如果接口返回的是超时异常,或者业务异常码是 500,此时不建议重试,如果非要重试,务必限制次数最多 1 次,且退避间隔要大于 100ms,同时配置全局重试开关,便于故障期间一键关闭。
超时设置应该改代码还是改配置中心
所有超时参数都不建议写死在代码中,Java 开发中可以使用 Spring Cloud Config 或 Nacos 配置中心,通过 @RefreshScope 注解实现热更新,当高峰期来到时,无需重启 JVM 就能动态收紧超时时间;当系统空闲时,可以适当放宽超时时间提供更好的用户体验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/641937.html