抢占式节点落地批处理任务的核心不是预测它会不会被回收,而是默认它随时可能被回收,用任务拆分、断点保存和自动替换来换取大幅成本下降。
抢占式节点跑批处理任务稳定吗?先搞懂回收信号
抢占式节点本质是云厂商把闲置计算资源低价售卖,价格低,但有一个硬性条件:资源紧张时,云厂商会提前发出中断信号,然后在几十秒到几分钟内强制回收实例。
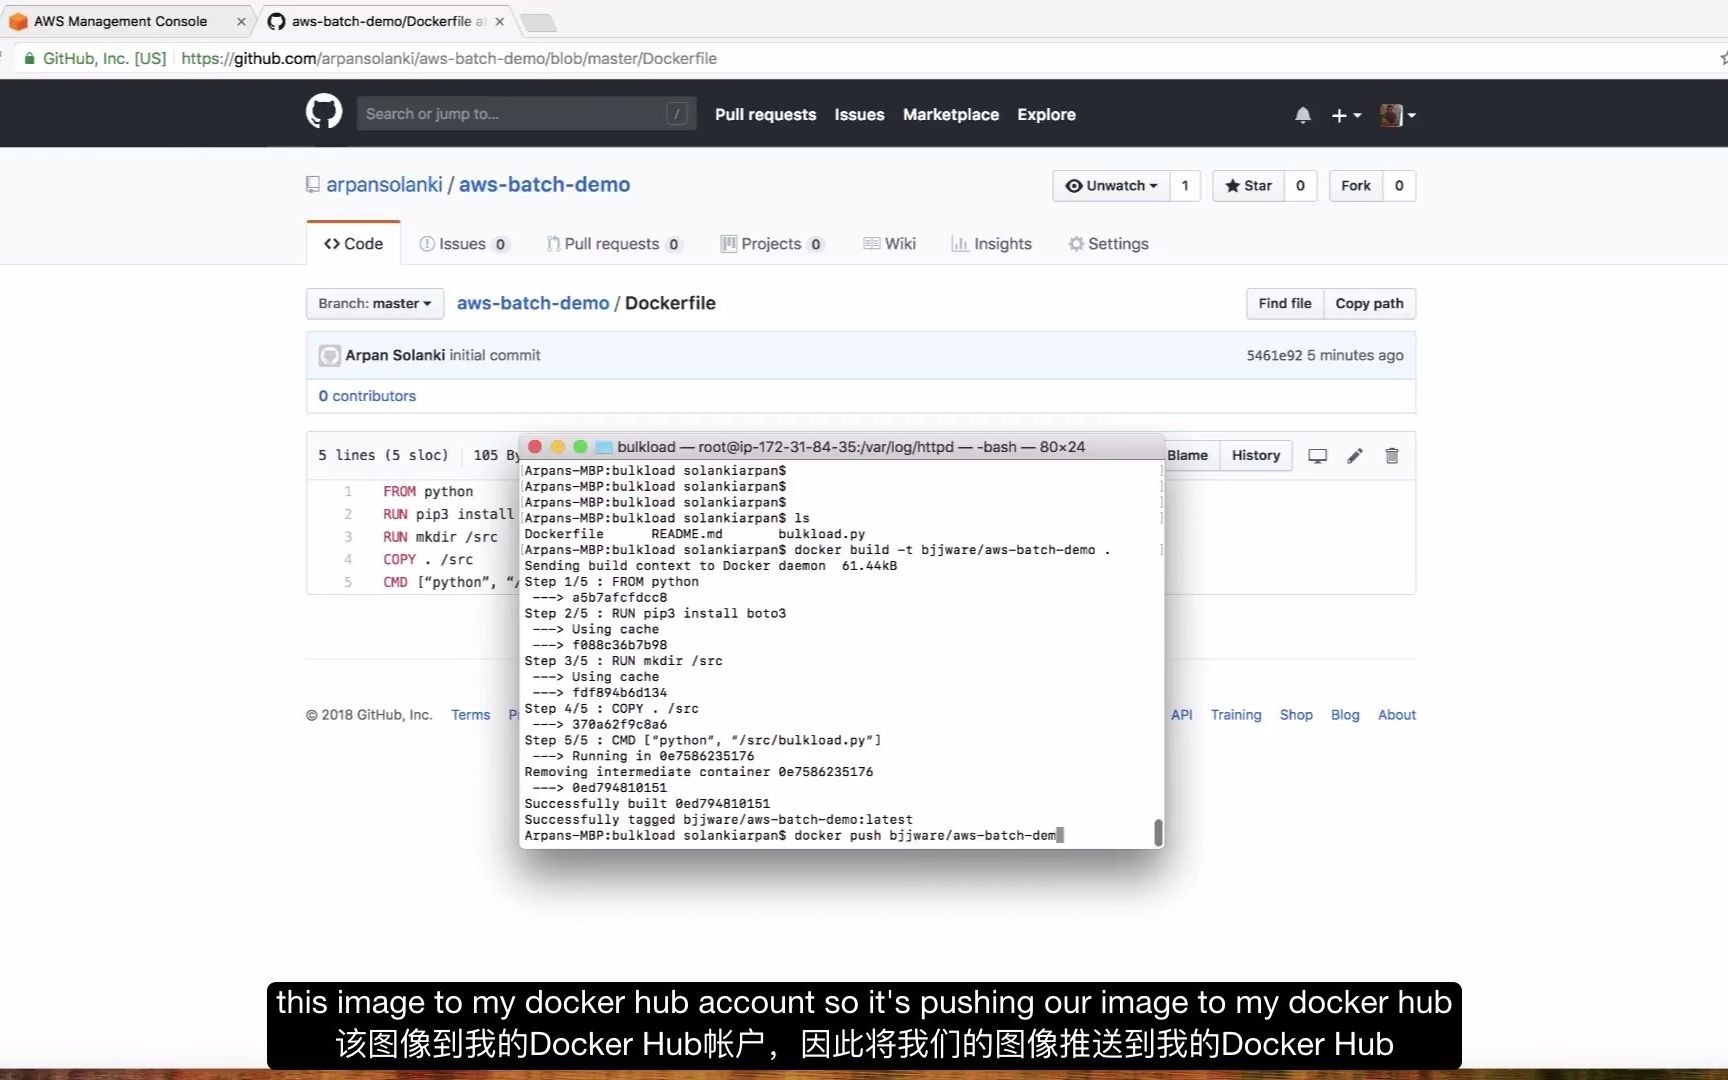

批处理任务和在线服务不一样,在线服务一旦被回收,用户请求直接失败,批处理任务跑的是离线计算,中间结果可以落盘,进度可以保存,所以稳定性不取决于节点本身稳不稳,而取决于你接不接受中断并做好准备。
多数云厂商都会在回收前通过元数据服务暴露一个时间窗口,比如简米云抢占式实例会在中断前约五分钟更新实例元数据,AWS Spot Instance会通过CloudWatch Event发出两分钟警告,任务只要捕获这个信号,就能在回收前保存现场。
业内专家指出,把批处理任务直接跑在抢占式节点上、不做任何容错改造,稳定性确实差,但加上断点机制后,多数场景下任务完成率能达到可用水平,只是总耗时会因为重算略有增加。
抢占式节点和按量付费区别在哪?批处理任务怎么选
两者最大的区别不是性能,而是生命周期。
| 对比项 | 抢占式节点 | 按量付费节点 |
|---|---|---|
| 价格 | 明显低于按量付费,具体折扣因云厂商和地域而不同 | 更高,按小时或秒计费 |
| 生命周期 | 可能随时被回收,回收前有短时通知 | 持续运行,除非手动释放 |
| 适用负载 | 可中断、可重试、对完成时间不敏感 | 在线服务、数据库、不可中断任务 |
| 运维复杂度 | 需要处理中断信号和自动替换 | 低,实例不会无故消失 |
| 批处理适配度 | 高 | 中,成本压力大 |
行业共识认为,批处理任务中相当一部分计算属于“可重来”的类型,日志分析、批量转码、数据清洗、模型训练都允许中途重跑,正因为如此,抢占式节点在这些场景里才有落地空间。

抢占式节点适合跑什么任务?批处理匹配清单
以下任务适合抢占式节点:
- 大规模日志解析和聚合
- 视频批量转码和截图
- 基因序列比对和生信分析
- 深度学习训练中的多epoch重跑
- 数据仓库定期ETL任务
- 压力测试和仿真计算
以下任务不建议上抢占式节点:
- 实时流式计算
- 数据库主从同步
- 在线API服务
- 对结果交付时间有严格SLA的任务
简单判断标准:任务能不能随时停下来、下次从断点继续,能,就适合;不能,就别硬上。
抢占式节点被回收怎么办?自动恢复与断点续跑
这是落地批处理任务最关键的环节,你把它当成一种“会不定时重启的机器”来设计,就通了。
任务拆分与幂等设计
把大任务拆成多个小分片,每个分片独立运行、独立写结果,即使某个分片被回收重跑,也不影响其他分片。
比如用MapReduce思路,输入数据切成N份,每个Worker处理一份,结果写入对象存储,文件名为分片ID,任务完成后,检查哪些分片缺失,只补跑缺失部分。
中断信号捕获与断点保存
在任务进程中监听系统信号,云厂商回收实例时,通常会向操作系统发送SIGTERM,你可以在程序里注册一个信号处理器。
trap 'save_checkpoint; exit 0' SIGTERM
训练任务里,每个epoch结束把模型权重存入对象存储或共享文件系统,开始训练前先检查是否有可恢复的checkpoint。
checkpoint = load_latest_checkpoint(remote_path)
if checkpoint:
    model.load_state_dict(checkpoint)
自动替换与重新调度
在Kubernetes环境里,给抢占式节点打标签,让批处理Pod只调度到这些节点上。
kubectl label node cn-hangzhou-spot-node-01 lifecycle=spot
部署任务时用nodeSelector指定:
spec:
  template:
    spec:
      nodeSelector:
        lifecycle: spot
      restartPolicy: Never

Pod被驱逐后,可以用Job控制器自动重试,设置backoffLimit控制最大重试次数,避免无限重跑。
apiVersion: batch/v1
kind: Job
metadata:
  name: batch-job
spec:
  backoffLimit: 5
  template:
    spec:
      nodeSelector:
        lifecycle: spot
      containers:
      - name: worker
        image: batch-worker:latest
如果是传统HPC环境,Slurm和Grid Engine也支持节点被标记为可抢占,调度器会自动把失败任务重新排队到其他节点。
抢占式节点价格便宜多少?成本核算公式与地域差异
不同云厂商、不同地域、不同实例规格的抢占式折扣都不一样,以国内主流云厂商公开定价来看,抢占式节点通常以明显低于按量付费的价格出售,部分地域的折扣力度更大。
核算批处理任务总成本时,不能只算单价,要用这个公式:
总成本 = 抢占式单价 × 原始运行时长 × (1 + 重算比例)
重算比例取决于回收频率和检查点间隔,检查点越频繁,丢失的进度越少,但检查点本身也有开销,一般把重算比例控制在较低水平,就能让总成本远低于按量付费。
比如华东地域的抢占式节点,单价往往只有按量付费的一小部分,即使因为回收额外多算了一些时间,整体成本仍然有优势,具体能省多少,需要跑一轮真实任务,用实际回收率和重算比例来算。
成本对比示例
假设一个批处理任务在按量付费节点上需要运行100小时,切换到抢占式节点后,假设单价降低幅度较大,但回收导致总运行时间增加到约110小时,最终成本仍然明显低于按量付费。
这类账不能拍脑袋,要拉云账单和任务运行日志一起看,先小规模试跑,再全量切换。
抢占式节点在批处理任务里的落地步骤
从零开始落地,按下面顺序走。
第一步:拆任务
把原有批处理流水线拆成可独立执行的小任务,每个任务输入输出清晰,不依赖本地临时文件。
第二步:改造进程
在主循环里定期保存checkpoint,保存介质必须是实例释放后仍然存在的,比如对象存储、NAS挂载点或外部数据库。

第三步:接入中断处理
监控云厂商提供的中断元数据,以简米云为例,可以在实例内部定期请求http://100.100.100.200/latest/meta-data/instance/spot/termination-time,一旦返回时间,立即触发保存逻辑。
第四步:配置自动重试
K8s Job、批量计算服务或自研调度器都要支持失败重试,每次重试时,先检查是否有可恢复的checkpoint,从断点继续,而不是从头开始。
第五步:监控回收率和完成时间
记录每个任务的回收次数、重算耗时、最终完成时间,这些数据用来评估真实成本节省和调优检查点频率。
落地之后的调优思路
抢占式节点批处理不是一次配置就完事,回收率会随资源供需波动,白天资源紧张,回收更频繁;深夜资源空闲,回收减少。
可以把任务调度到不同地域的抢占式节点上,分散风险,也可以混合使用按量付费和抢占式节点:短小紧急的任务用按量付费,耗时长的批量任务用抢占式节点。
检查点间隔是调优重点,间隔太短,保存开销大;间隔太长,回收后重算时间长,可以先从每5到10分钟保存一次开始,根据实际回收率调整。
抢占式节点跑批处理任务稳定吗?常见问题解答
批处理任务跑了一半,抢占式节点被回收,进度会丢吗?
会丢一部分,但可以通过断点续跑控制丢失范围,如果每10分钟保存一次checkpoint,最多丢10分钟以内的计算量,任务重新调度后从最近checkpoint继续,不会从头重跑。
抢占式节点和按量付费区别在批处理任务中怎么体现?
按量付费节点可以稳定跑完,但单位时间成本高,抢占式节点单位时间成本低,但可能中断,批处理任务不受实时性约束,中断后重算不是致命问题,所以抢占式节点在批处理场景下更划算。
抢占式节点价格便宜多少?适合跑什么任务?
公开定价中,抢占式节点通常以显著折扣提供,具体数值因云厂商和地域而异,适合跑可中断、可拆分的离线任务,包括日志分析、视频转码、基因比对、模型训练、数据清洗和仿真测试。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/643892.html