监控海外各区域命中率与延迟,本质上是把CDN或边缘节点的缓存日志、主动探测延迟数据统一接入一套时序监控系统,再按地域维度聚合、对比基线和触发告警。
海外各区域命中率监控方案:先定义指标边界
命中率不是一个单一数字,很多团队把全局缓存命中率当成健康度指标,结果东南亚某区域命中率已经跌到很低,全球平均值却只下降一点,要先明确你监控的是哪一层命中。
- 边缘命中:用户请求在距离最近的边缘节点直接返回缓存内容。
- 父层命中:边缘节点没有缓存,向区域父层节点请求并命中。
- 回源:父层也没有缓存,请求穿透到源站。
不同CDN和自建架构的日志字段完全不同,Nginx用$upstream_cache_status输出HIT、MISS、BYPASS、EXPIRED,AWS CloudFront日志里的x-edge-result-type会记录Hit、Miss、RefreshHit,Cloudflare则在响应头CF-Cache-Status中返回HIT、MISS、DYNAMIC等状态,据AWS CloudFront日志字段说明,这些状态码是判断命中率的核心依据。
从Nginx日志提取缓存命中率
自建Nginx缓存时,先修改log_format,把缓存状态写进访问日志。
log_format cache_debug '$remote_addr - $region - $upstream_cache_status - $request_uri';
access_log /var/log/nginx/cache.log cache_debug;然后用Promtail或Filebeat把日志推到Loki或Elasticsearch,Promtail配置里保留$upstream_cache_status字段,之后在Grafana里用LogQL按地域聚合,计算命中率时,把HIT请求数除以该区域总请求数,不是除以全局请求数。
用Prometheus采集缓存指标
如果不想只依赖日志,可以在Nginx编译时加入nginx-module-vts模块,暴露nginx_cache_status计数器,Prometheus拉取后,使用类似下面的PromQL按区域维度计算命中率。
sum by(region) (rate(nginx_cache_status{status="HIT"}[5m]))
/
sum by(region) (rate(nginx_cache_status[5m]))

这种方式能直接得到时间序列,比每次从日志解析更高效,但需要保证region标签在采集层就已经注入,否则Prometheus无法做地域拆分。
海外服务器延迟怎么测试:用主动探测代替被动等待
被动等用户上报延迟太迟,也缺少地域维度,主动探测是固定节点定期发起请求,把网络耗时和HTTP各阶段耗时记录下来,海外服务器延迟怎么测试,核心不是跑一次ping,而是让多个地理位置的探针持续上报数据。
部署全球探测点
行业共识认为,海外延迟监控至少要在目标用户集中的几个区域部署探针,不能只从一个地方测,轻量方案是使用云厂商低配VPS:AWS Lightsail、GCP e2-micro、Azure B1s,建议覆盖美国西部、美国东部、欧洲法兰克福、新加坡、东京、圣保罗。
不想维护探针时,用商业拨测服务会更省事,Pingdom、Uptrends、简米云拨测、酷番云拨测等都能从全球不少区域发起探测,探针的分布直接决定监控结果是否有代表性。
可执行命令与结果入库
常用探测命令有三类,每条命令的结果打上region标签后写入时序库。
- ping测RTT:
ping -c 20 -i 0.2 目标域名 - mtr看路径丢包:
mtr -rw -c 100 目标域名 - curl测HTTP各阶段耗时:
curl -w "dns:%{time_namelookup} connect:%{time_connect} tls:%{time_appconnect} starttransfer:%{time_starttransfer} total:%{time_total}n" -o /dev/null -s https://目标域名
更自动化的方式是使用Prometheus Blackbox Exporter,它支持HTTP、TCP、ICMP模块,能定时执行上述探测。
modules:
  http_2xx:
    prober: http
    timeout: 5s
    http:
      valid_status_codes: [200, 301, 302]
method: GET在targets文件里给每个目标添加region标签,采集间隔建议设在15秒到60秒之间,间隔过长会漏掉瞬时抖动,过短则增加探针负载。

按区域设置延迟基线
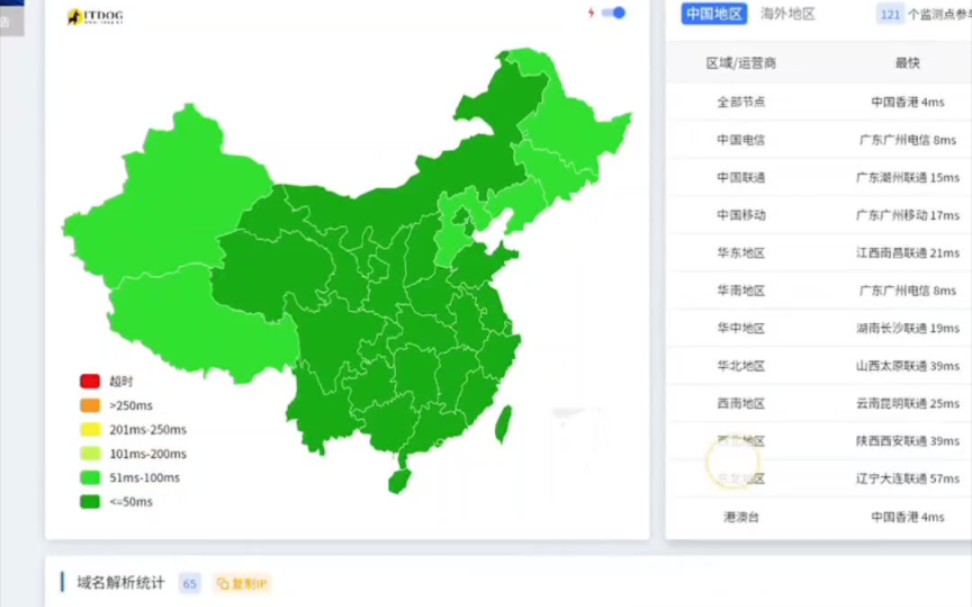
不要用全球平均值判断延迟是否正常,北美到中国大陆的直连链路,RTT多数情况下在130ms以上;欧洲到东南亚往往更高,不同区域物理距离天然不同,所以给每个区域单独计算过去7天的P50、P95、P99基线,当实时值偏离基线超过合理范围时再告警。
海外CDN命中率和延迟区别:别把两个指标混在一起
海外CDN命中率和延迟区别在于,命中率衡量缓存复用程度,延迟衡量从发出请求到收到响应的时间,两者相关,但不能互相替代,一个节点可能缓存命中率很高,但用户被调度到该节点时物理距离较远,延迟仍然不低;反过来,延迟很低的节点如果缓存命中率差,回源时间会拉长整体响应。
典型故障场景对照
- 命中率下降,延迟升高:缓存过期策略异常,或源站压力大导致回源变慢。
- 命中率正常,延迟升高:区域节点过载,或上游网络链路劣化。
- 命中率升高,延迟也升高:用户被调度到较远区域节点,缓存虽命中但物理距离变远。
业内专家指出,只监控命中率或只监控延迟,都会漏掉局部区域的服务劣化,必须把两者放到同一个时间轴上,按区域叠加查看。
海外多区域延迟监测工具与告警落地
工具选择取决于团队规模和成本,自建Prometheus+Grafana+Blackbox Exporter灵活性高,第三方拨测开箱即用但数据导出自定义受限。
自建监控链路的配置要点
- Blackbox Exporter至少部署在3个不同区域,避免单点视角偏差。
- targets添加
region和target_type标签,例如region: "us-west-2"、target_type: "api"。 - 延迟告警规则可以设置
probe_success == 0持续2分钟触发。 - 命中率告警根据各区域历史基线,例如当前值低于过去7天同时段均值较大幅度并持续10分钟触发。

Alertmanager里按region分组通知,避免告警风暴把真正问题淹没,通知内容直接带上区域标签,收到告警后不需要再人工定位。
第三方拨测工具的取舍
不想维护探针、需要覆盖更多冷门地域时,商业拨测更合适,这类服务通常提供海外节点延迟对比工具,能同时从数十个地理位置发起测试,直接输出各区域平均延迟和丢包率,缺点是导出的原始数据可能不支持自定义PromQL查询,长期留存和二次分析不如自建链路自由。
日常巡检面板拆分
Grafana面板不要只看全球汇总,用region变量做维度拆分。
- 命中率用堆叠柱状图或热力图,横轴时间,纵轴区域。
- 延迟用P95折线图,每个区域一条线。
- 告警通知携带区域标签,缩短定位路径。
监控海外各区域从来不是一两个命令能搞定,它依赖日志、探测、指标三套数据流,把地域维度做深,告警和巡检才有实际意义。
Q&A
海外各区域命中率监控方案需要自建服务器吗?
不一定,自建探针能自定义探测路径和频率,但维护成本较高,业务规模较小或区域覆盖要求不高时,优先用商业拨测服务;需要监控私有协议、内网源站或希望完全控制数据留存时,再自建轻量探针。
海外服务器延迟怎么测试最准确?
没有单一最准确方法,要组合使用,ping测网络RTT,mtr看路径丢包,curl测完整HTTP响应时间,并从多个地域同时探测,单个区域单次探测只能反映该探针所在位置的局部视角。
海外CDN命中率和延迟区别是否影响调度决策?
会影响,调度系统常优先选择延迟低节点,但若该节点缓存命中率低,回源时间会拉长整体响应,正确做法是按地域分析两者关系,再决定调度策略是否需要调整。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/645546.html