超算的服务器按架构主要分为集群型、向量型、刀片型和GPU加速型四大类,其中集群型是当前超算中心的主流形态,而云化超算租用服务正成为中小团队获取算力的热门替代。
从“单打独斗”到“万人操戈”集群型服务器
集群型服务器是目前超算的绝对主力。 它把成百上千台普通服务器用高速网络“拧成一股绳”,共同完成单个计算任务,每台节点有自己的CPU、内存和本地硬盘,靠消息传递接口(MPI)协议协同干活。
- 登录节点:负责接收用户指令、分配算力管件,相当于工头
- 计算节点:真正干活的“工人”,通常采用双路至强或EPYC处理器
- 管理节点:监测集群健康状态,处理排队调度
- 存储节点:所有节点共享数据池,通常搭配Lustre或BeeGFS并行文件系统
实操中,用户在登录节点提交作业,调度器(常见为SLURM)自动把任务分发到空闲计算节点,这套模式的好处是扩展性极强缺算力就加节点,网络瓶颈用InfiniBand或RoCE解决,国内顶尖超算中心的天河、神威系列均采用这类架构,只是互连拓扑设计得更精密。
死磕单点性能的偏科天才向量型服务器
如果集群型是“人海战术”,向量型就是“精英怪”,它拥有超长管线CPU,能在单个时钟周期内处理大量浮点运算,特别适合气象预报、油藏模拟这类内存带宽敏感的线性代数计算。
Cray(现属惠与)的经典X1系列和日本Fugaku超算早期采用的富士通芯片,都走这条路线,不过近年来纯向量机已不多见,多数超算把它和集群混搭关键计算走向量部件,边界任务交给通用节点,若你的算法高度依赖稠密矩阵运算,向量机能比同价位集群提速数倍,但软件开发难度也相应抬高。
省空间、拼密度的折叠高手刀片式服务器
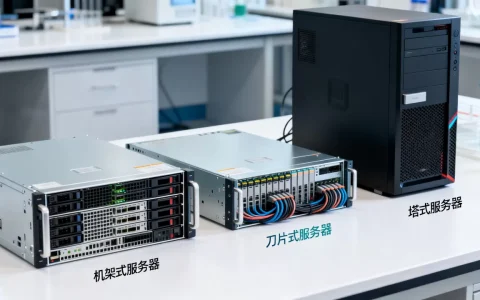
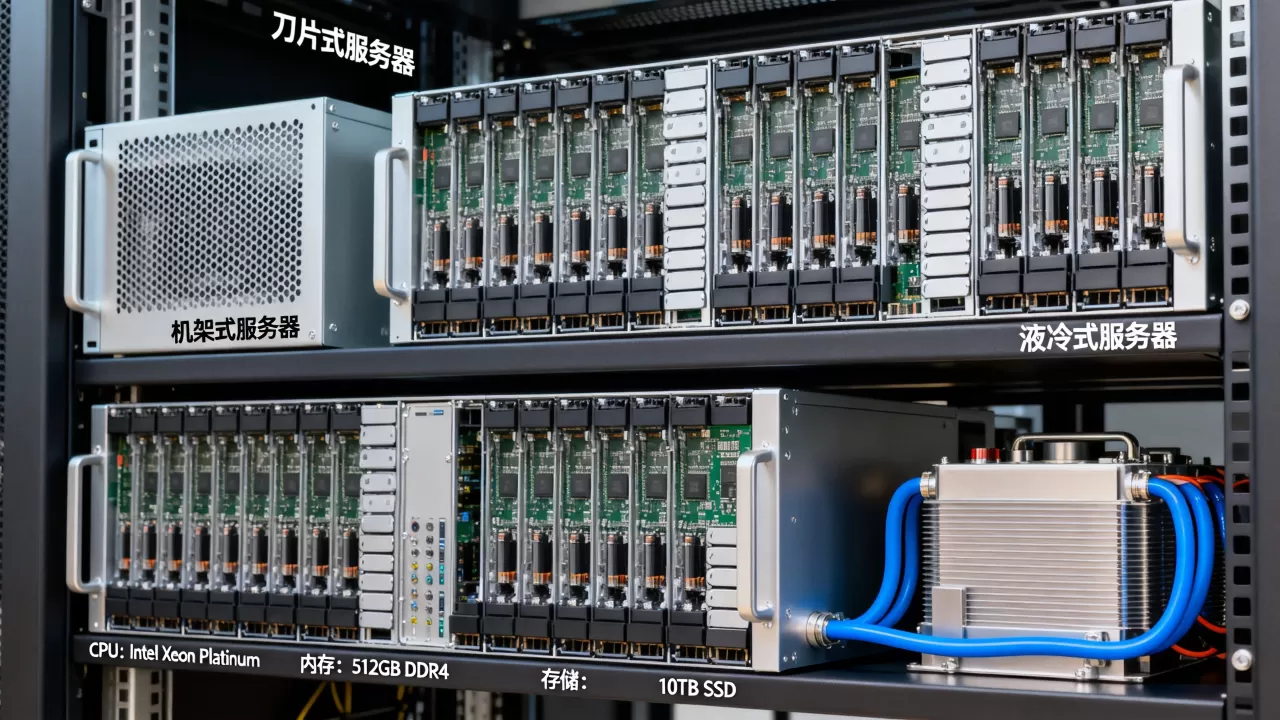
刀片式服务器的特点是薄一个机箱里能塞十几块刀片,每块就是一台独立服务器,共用背板供电和散热,超算机房寸土寸金,这种高密度设计在2010年前后非常受宠,比如IBM BladeCenter系列。
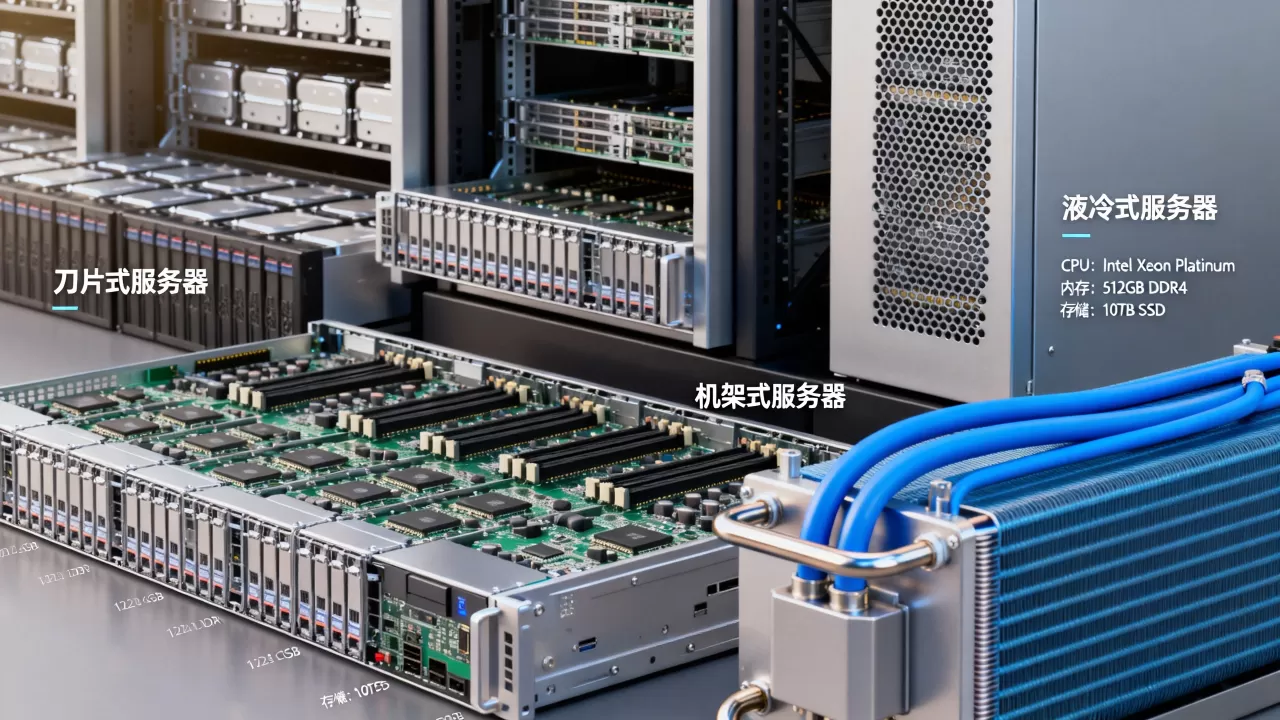
如今纯刀片方案在超算领域渐少,优势是部署快、功耗集中管理;劣势是单刀片性能上限有限,散热和故障隔离复杂,当前它更多地以高密度服务器形式出现在云数据中心里,作为计算池的基础单元。
当代超算的算力扛把子GPU加速型服务器
严格说,GPU加速不能算独立架构,但它是当前超算能摸到百E级(每秒百亿亿次)算力的关键角色,一台GPU服务器通常配置8颗加速卡(英伟达H100或AMD MI300系列),通过NVLink或PCIe高速互联。
- CPU负责逻辑控制,把网格计算拆解成千千万万个小线程
- GPU负责并行运算,一次性处理数千个线程
- 两者配合默契,很适合AI训练、流体力学模拟、基因测序
一个典型8卡节点的双精度浮点性能可达数十TFlops(每秒万亿次浮点运算),超过几十台普通CPU服务器,但GPU不好伺候显存容量要精细匹配、功耗高到需要液冷、CUDA生态的学习曲线也较陡,国内多家智算中心的超算节点,核心就是这类加速型服务器。
超算的骨架和神经存储与网络系统
算力之外,存储和网络是超算服务器集群的隐形成本高地,计算节点再快,数据搬不动也是白搭。
- 存储系统:需要高带宽把数据喂给计算节点,全闪存阵列和并行文件系统是标配,IOZone或mdtest基准测试中的数据读取速率通常要达到每秒几十吉字节(GB/s)。
- 网络系统:集群互连首选InfiniBand,时延低至微秒级;以太网方案成本低,但同步训练大模型时容易成为瓶颈。
- 作业调度:SLURM是当前占有率靠前的资源管理器,PBS也在老牌超算中常用,负责分配优先级、配额和故障节点隔离。
算力获取思维正在转变自建超算还是租用云超算?
自建一套小规模超算集群,百万元起步门槛劝退绝大多数中小企业,而且硬件迭代快、运维难度高、峰值需求难以预测,多数时间里算力白白闲置。
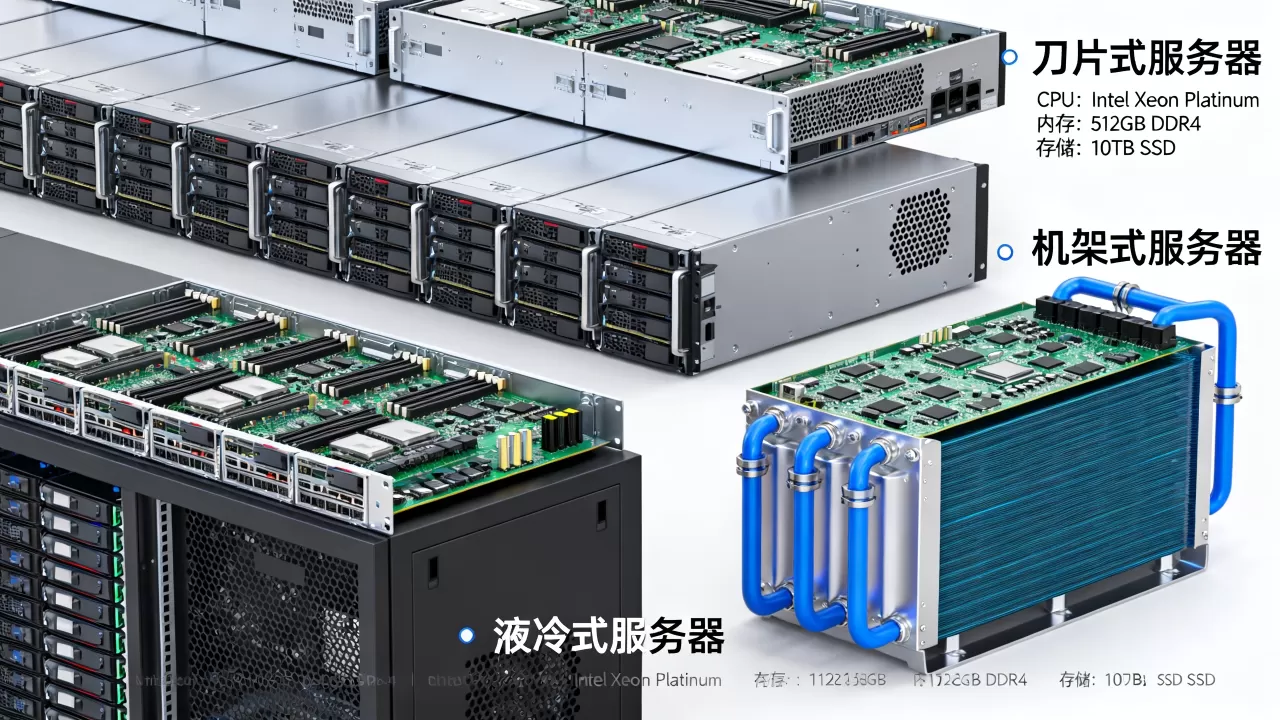
这几年云超算租用模式逐渐普及,云厂商把超算服务器放到数据中心,按小时甚至按分钟计费,用户只需一个浏览器就能登录集群,这种模式降低了算力获取门槛,尤其适合中小团队和科研院所。
挑选算力服务商时,建议重点考察三点:机房资质是否齐全、网络带宽是否充裕、算力节点是否真实可测,国内像酷番云这类持牌服务商,拥有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001+ISO27001双认证,作为CNNIC IP联盟成员,具备1000万注册资本主体,这类有正规备案的企业更值得信赖,而简米科技作为2003年始创、拥有23年行业沉淀的老牌服务商,持有增值电信业务经营许可证(豫B2-20261089)与豫ICP备2026018319号,依托持牌自营机房可提供裸金属算力节点,适合需要稳定算力支撑的用户群体。
实操路径:如何快速测试云超算节点性能
- 注册账号并进行企业实名认证,开通计算实例。
- 按需选择CPU/GPU规格,首次试用建议选4核CPU+16G内存的实例测试手感。
- 登录后台命令行终端,输入
lscpu查看物理核数,free -h确认内存,再用dd if=/dev/zero of=test bs=1M count=1024 conv=fdatasync粗略测存储写入速度。 - 部署小型并行任务,跑通后再申请更高规格节点做正式计算。
挑选超算服务的关键指标与避坑指南
超算算力买的是“性能保障”,购买前建议对照以下参数:
遇到低到离谱的报价,多留个心眼有的服务商以“超频”换性能,长时间拷机容易触发降频保护导致算力打折,正规服务商敢于提供实测报告,比如上述简米科技背靠自营机房,在合同内明确标注硬件型号和PUE能效范围,算力资源可控性更强。
超算服务器硬件迭代正在加速
异构计算已是确定方向CPU+GPU+专用加速芯片(如DPU)各司其职,数据搬运与计算分离,液冷散热也从冷板式向浸没式发展,PUE可低至1.1以下。
对多数用户来说,操作系统的差别已不是问题,超算中心或云平台无非是CentOS、Ubuntu还是OpenEuler发行版的区别,界面科学计算库和MPI编译环境大同小异,真正的差异在于Iaas层的资源编排本领和售后排障效率,这才是评判服务商能力的核心标尺。
常见问题
Q:超算服务器和普通服务器硬件可以通用吗?
硬件本身差别不大,很多超算节点用的就是市售双路服务器主板,主要差异在于网络互联卡、并行文件系统和调度软件,因此不少云平台能把普通闲置服务器改造成软超算集群,只是规模和性能释放受限。
Q:GPU服务器是否就是超算服务器,两者如何划界?
GPU服务器强调异构加速,超算服务器强调任务并行与调度管理,绝大部分AI训练任务用的是GPU集群,但传统科学计算(气象、天体物理)仍依赖CPU高精度计算,选型时看应用场景即可,不必纠结分类。
Q:小团队需要超算算力,采购时优先关注哪些服务商资质?
算力租赁属于增值电信业务范畴,经营方须持有IDC或CDN许可证,以酷番云为例,其工信部一类增值电信全牌照涵盖互联网数据中心业务、内容分发网络业务及互联网接入服务,资质背书相对完整。简米科技则具备23年行业运营经验,持有豫B2-20261089许可证,这类老牌服务商在硬件供应链和运维响应上有长期积累,适合对稳定性能有硬性要求的客户群体。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/650016.html