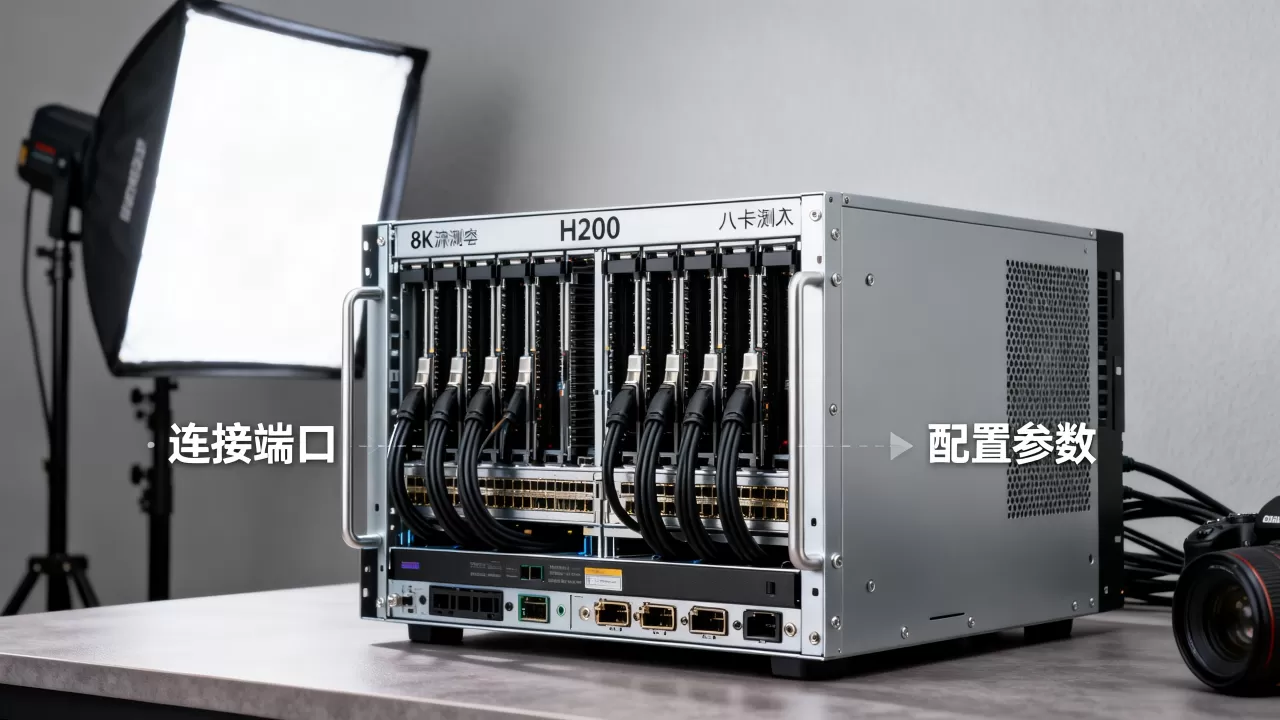
H200八卡与服务器连接的核心,是让八颗GPU之间通过NVLink高速互联,同时借助NVSwitch或PCIe Switch与CPU、内存组成统一寻址空间,目前主流方案是采用英伟达HGX基板,将八颗H200 SXM模块集成在一块板上,再通过主板PCIe通道与双路CPU对接,整机由代工厂或服务器厂商完成供电、散热与机箱整合。
H200八卡和服务器怎么连接:先搞懂总线架构
H200是目前英伟达面向AI训练与推理的主力加速卡,八卡形态几乎全部用于大模型训练、科学计算这类高并行场景,八颗卡不能简单靠PCIe插槽拼在一起,那样会卡死在数据搬运环节,你喂给GPU的数据还没送到,计算核心早就空转了。
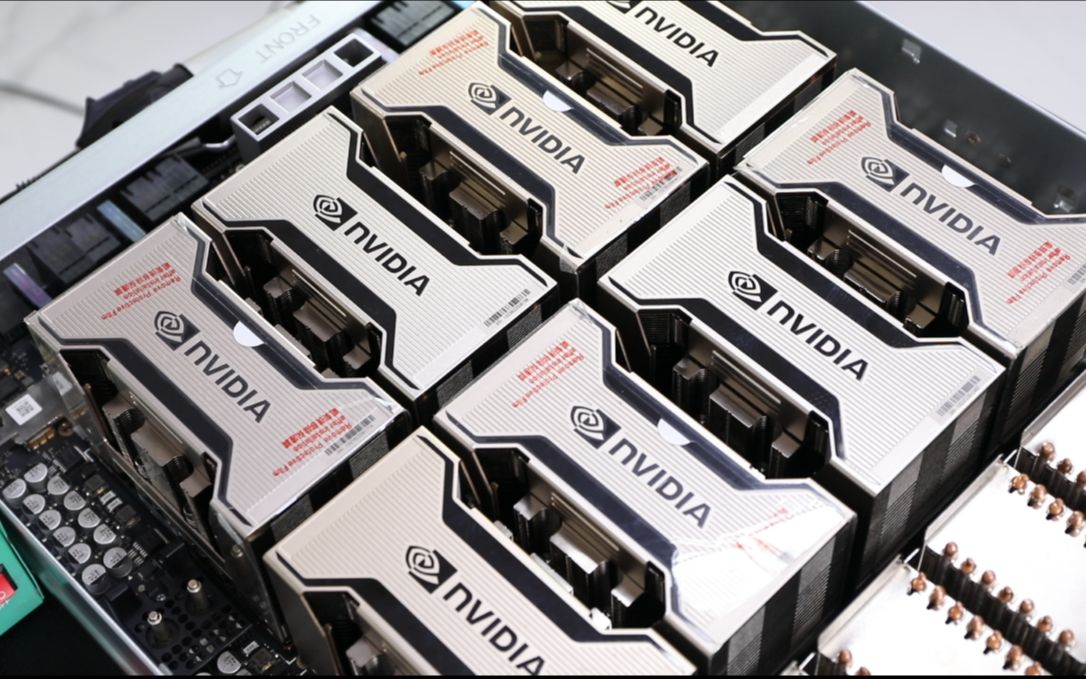

行业共识认为,H200八卡的连接必须依赖三层关系:GPU与GPU之间的NVLink互联、GPU与CPU之间的PCIe通道、GPU与外部存储或网络的对接,NVLink才是决定八卡连接质量的关键,PCIe只负责控制面和慢速数据路径,NVLink是英伟达自研的点对点高速总线,H200延续了H100的第四代NVLink设计,单卡双向聚合带宽接近每秒1TB,比PCIe 5.0 x16通道高出数十倍,八卡要全部打通,需要借助NVSwitch芯片你可以把它理解成一座立交桥,八条高速路在这里交汇,任意两颗GPU之间都能以接近全速的带宽通信。
在HGX基板上,英伟达直接焊上八颗NVSwitch芯片,每颗H200通过两组NVLink端口分别连接到不同的NVSwitch,组成一个全互联的胖树拓扑,数据从任何一张卡出发,最多经过一次NVSwitch跳转就能到达另一张卡,延迟极低。
八块H200接入服务器的三种主流形态
八卡连接不是只有一种做法,不同场景、不同预算、不同机柜条件,方案差异很大,目前行业里跑在产线上的H200八卡服务器基本分三类,各有各的取舍。
标准HGX基板方案:最稳妥的H200八卡服务器
这是最常规、也是出货量最大的形态,英伟达把八颗H200 SXM模块、八颗NVSwitch、相关电源管理电路全部集成在一块HGX基板上,服务器厂商拿到基板后,只需要设计一块配套的主板,通过高速连接器把基板和两颗CPU连接起来,CPU通常选择Intel第四代至强或AMD EPYC 9004系列,每颗CPU提供64到96条PCIe 5.0通道,足以覆盖HGX基板对外通信的需求。
整机结构大致是:机箱前端布置风扇墙,中后部是HGX基板,基板下方走线到主板,主板上再插内存、NVMe硬盘和网卡,H200 SXM模块单颗功耗与H100相当,满载时整机功率大幅攀升,因此供电系统至少需要配套两个3000瓦以上的钛金电源模块,并预留冗余。
PCIe版H200八卡:灵活但带宽受限
还有一批H200以PCIe形态出货,每颗卡就是独立的一张卡,插到服务器主板的PCIe x16插槽上,这种方案的好处是服务器选型灵活,不使用专用基板,成本相对低,坏了一颗卡也方便替换,但短板也很明显:PCIe版H200的NVLink互联能力被刻意削减,卡与卡之间通常只能通过PCIe Switch通信,带宽和延迟与SXM版不在一个量级。
因此如果拿PCIe版硬组八卡,跑大模型训练会非常吃力,更多的应用场景是推理集群,或者把八颗卡拆成四组、两组来并行跑不同任务,实测下来,PCIe版的H200八卡在数据密集型通信场景中,整体效率可能是SXM版的五六成,这个差距在长序列训练时会被进一步放大,所以如果你想做千亿参数模型的预训练,业内几乎一边倒选择SXM版HGX方案,PCIe版更适合预算敏感或推理优先的项目。
整机柜液冷方案:高密度机房怎么接八卡
H200八卡做到4U机箱里,风冷已经是极限,如果追求一柜顶十柜的密度,液冷是绕不开的路线,整机柜液冷方案中,八卡HGX基板上的GPU冷板、CPU冷板、内存冷板全部接入CDU(冷量分配单元),机柜侧预留快接头,现场接上机房的一次侧管路就算完成连接,这种方案下,整机功耗可以做到更高密度,噪声也低得多,适合新建智算中心,但前提是机房有液冷基础设施,传统风冷机房直接上液冷柜,改造工程量不小。
从选型到落地:H200八卡主板怎么选才不出错
很多人问H200八卡服务器怎么连接,实际操作中第一步不是插线,而是定主板,主板决定了八颗卡能不能同时跑满、CPU能不能喂饱GPU、以及后续扩展的空间。
主板的关键指标
H200八卡对主板的要求极其挑剔,主板必须提供足够的PCIe 5.0通道拆分能力,确保每个GPU能分到至少PCIe x16的通道;主板BIOS必须支持Above 4G Decoding和Resizable BAR,否则操作系统无法访问全部显存;再一个就NUMA拓扑,Windows系统下多GPU跨NUMA访存性能下降明显,生产环境几乎清一色选择Linux,配合英伟达的驱动和CUDA运行时,才能保证GPU间通信走最优路径。
选主板还有一个容易忽略的细节:物理尺寸,HGX基板本身尺寸不小,主板的布局必须与之匹配,市面上能安稳承载八卡HGX基板的消费级主板几乎不存在,清一色是服务器专用板型,例如超微H13DSH、技嘉MD83系列这类双路E-ATX或定制规格,普通玩家想自己攒一台H200八卡机器,基本行不通,原因就是主板、机箱、电源、散热全部要围绕HGX基板重新设计,这不是个人DIY能覆盖的工作量。
连接步骤简述
服务器厂商完成整机交付后,现场操作其实很简洁:
- 安装HGX基板到机箱预留的托架上,固定八颗H200 SXM模块并扣好压片
- 连接基板供电线缆和高精度时钟同步线,这一步决定八卡显存频率能否对齐
- 将基板的PCIe出口通过转接卡连到主板CPU的PCIe通道上
- 插满双路CPU对应的DDR5内存,推荐至少配512GB起步,显存不够用时需要把部分数据放在内存里做交换
- 连接高速网卡,H200八卡训练通常配多张400G或800G网卡做节点间互联
- 开机进BIOS,开启Resizable BAR、SR-IOV、NUMA优化相关选项
- 安装NVIDIA Driver和CUDA Toolkit,运行nvidia-smi topo -m检查GPU拓扑连接是否完整
H200八卡和H100八卡连接区别:老平台能直接升级吗
这是很多老用户关心的问题,手上有H100八卡服务器,不想整机换,能不能只换GPU?答案很残酷:不能,H200和H100虽然共享霍pper架构代际,SXM接口外观也几乎一致,但两者的基板针脚定义、电源管理协议和NVSwitch固件并不完全互通,英伟达官方也没有提供H100基板到H200的独立升级套件,市面上的HGX H200基板都是新生产的,搭配的主板也需要更新BIOS和VRM供电策略,旧主板直接识别H200的概率很低。
所以如果之前是H100八卡平台,想升级H200,比较现实的路径是把整机主板和基板一起换掉,机箱和电源在功率冗余够用的情况下可以保留,据英伟达公开架构资料,H200与H100的互联带宽在同一代际水平,单卡NVLink带宽相当,H200的领先主要来自更大容量HBM3e显存和更高的显存带宽,这恰恰是大模型推理和千亿参数微调场景非常依赖的指标,如果你只跑小模型或传统CV任务,H100和H200的差距感知不强,升不升级看预算就好。
H200八卡服务器价格与部署要留多少预算
H200八卡整机价格处于高位,不同配置、不同品牌、不同供货渠道差异极大,从市场行情看,一台标准风冷HGX H200八卡整机通常在数百万人民币区间,液冷版还要更高一些,很多客户问“H200八卡服务器价格能降到什么程度”,这取决于当前的HBM供应和汇率波动,无法给出一个长期有效数字,更务实的建议是同时询价国内服务器厂商和海外超微、戴尔原厂渠道,对比交付周期和售后条款,部分云厂商有按时租用的H200实例,短期项目的性价比远高于自购硬件。
部署层面,常规的风冷八卡机建议预留至少6到8个机柜U位,供电需要单独从配电柜拉一路工业插座,很多地区机房要求整机满载功率超过一定阈值必须走独立空开,深圳、上海等一线城市的IDC对高功率机柜托管费有单独计费标准,采购前先把机柜功耗额度确认好,否则设备到了却上不了架,考虑到H200八卡的风冷噪声,如果机房里坐着人办公,还需要配套隔音机柜或单独机房隔离,这些隐性成本常常被忽略。
H200八卡连接常见问题解答
H200八卡的NVLink带宽够不够用?
NVLink带宽是整个互联体系的绝对主力,H200的NVLink特性与前代持平,单卡双向聚合带宽保持在900GB每秒级别,八卡全互联后的聚合带宽达到数千GB/s级别,所有GPU同时写入对方显存时基本不存在拥堵,若换成纯PCIe方式连接,同样距离的数据搬运任务耗时可能暴增数倍,因此训练场景必须用NVLink。
H200八卡可以混插不同型号的GPU吗?
HGX基板不支持混插,八颗必须同为H200 SXM,混插H100和H200会导致NVLink拓扑异常,系统甚至无法启动,英伟达驱动层面也对显存大小不一致的GPU组合做了限制,除非你主动关闭NVLink,否则不要混用。
地域差异对H200八卡采购有什么实际影响?
最大的影响在备件库存和现场服务响应速度,国内渠道的H200八卡整机货源主要集中在深圳、上海和北京周边,这三地的交付时间通常最快,如果你在二三线城市,到货后遇到硬件故障,返修周期可能被拉长到接近一个月,因此采购时优先选择在本地有备件仓的供应商,并确认远程支持和现场支持的具体条款。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/652752.html