大模型读综述命令的核心价值在于“精准引导”而非“简单提问”,直接扔给大模型一篇几万字的PDF并要求“总结全文”,是效率最低的使用方式,真正的专业用法,是将大模型视为一个需要明确指令的“研究助理”,通过结构化的命令框架,强制模型激活深度推理能力,从而提取出高密度的知识图谱。关于大模型读综述命令,说点大实话,大多数用户之所以觉得大模型“智障”或“幻觉严重”,根本原因在于指令缺乏思维链引导和上下文约束。
核心结论:高质量的综述阅读依赖于“分治法”指令,而非一次性概括。
大模型处理长文本综述时,本质上是在进行概率预测与信息压缩。 如果指令过于宽泛,模型倾向于生成“正确的废话”或遗漏关键细节。要获得专业级的综述分析,必须强制模型执行“定位-抽取-综合”的三段式操作流程。 这不仅能规避上下文窗口的限制,还能大幅降低模型“幻觉”的概率。
为什么普通指令无法驾驭长篇综述?
很多用户在使用大模型时,习惯输入“帮我总结这篇论文”或“这篇综述讲了什么”,这种指令在实际的NLP(自然语言处理)层面存在三个致命缺陷:
- 注意力机制分散: 综述类文献通常包含大量引用、背景介绍和无关修饰词,宽泛的指令会让模型的注意力平均分配,导致核心创新点被稀释。
- 缺乏逻辑锚点: 模型不知道用户关注“方法论”、“数据集”还是“未来趋势”,只能生成流水账式的摘要。
- 幻觉风险叠加: 越长的文本,模型在压缩信息时越容易产生“知识混淆”,将不同流派的方法张冠李戴。
专业级“综述阅读”指令的构建逻辑
遵循E-E-A-T原则中的专业性要求,我们需要构建一套标准化的指令框架,这套框架的核心在于“角色设定”与“任务拆解”。
角色设定与思维链激活
不要直接提问,先给身份。指令开头应明确:“你现在是该领域的资深专家,具备批判性思维。” 随后,必须启用思维链模式,要求模型“一步步思考”。
- 错误示范: 总结这篇综述的主要贡献。
- 正确示范: 请以资深专家的身份,分析这篇综述的三个核心贡献,并在每个贡献后标注具体的章节依据。
结构化信息抽取命令
这是解决长文本阅读的关键。强制模型按照预设的JSON格式或Markdown表格输出,能极大提升信息的可读性和准确性。 推荐使用以下指令模块:
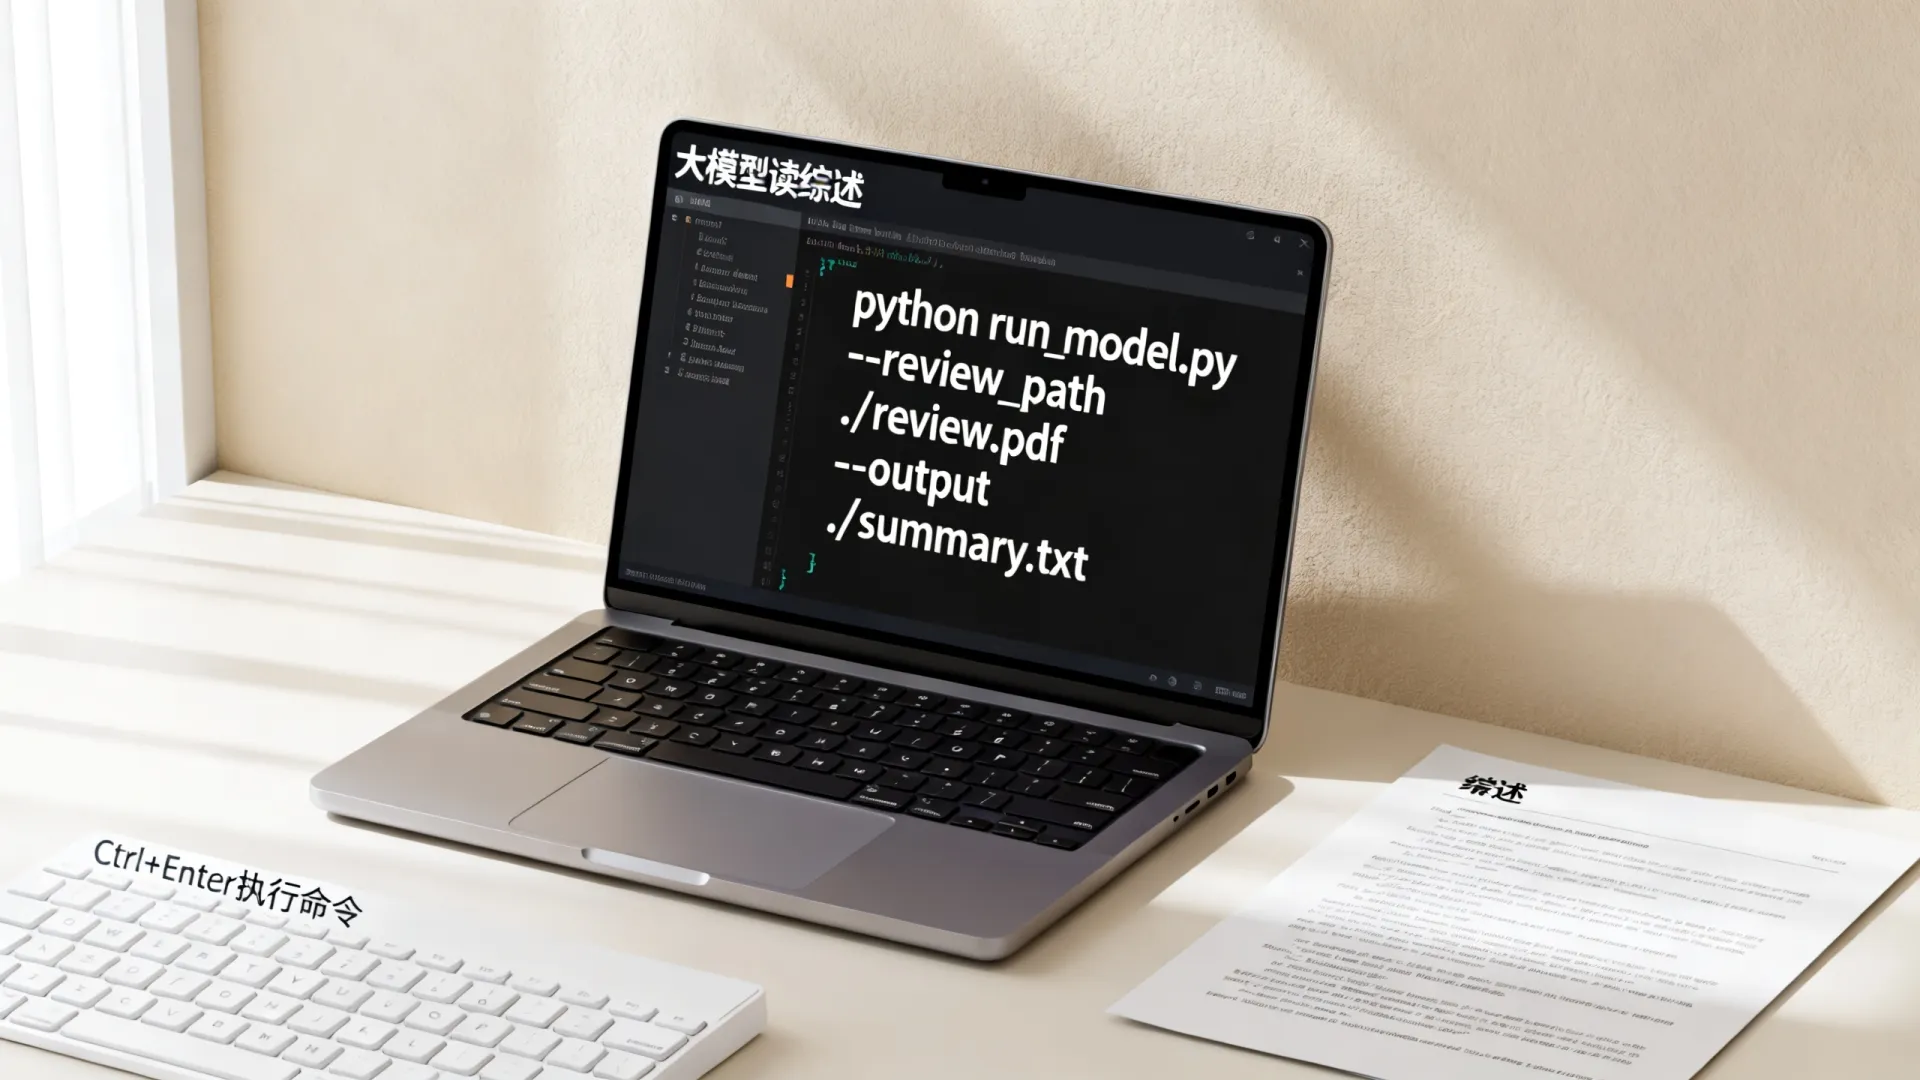
- 背景梳理: “用200字概括综述的研究背景,重点标注该领域目前亟待解决的痛点。”
- 方法分类: “列出文中提到的所有技术流派,以表格形式展示,包含:流派名称、核心思想、代表性论文、优缺点。”
- 数据集与基准: “提取文中引用的所有数据集名称,并说明它们分别用于评估哪些维度的能力。”
批判性分析与未来展望
大模型最强的能力不仅是总结,更是推理。在关于大模型读综述命令,说点大实话的讨论中,我们往往忽略了让模型进行“对比分析”的价值。
- 对比指令: “请对比文中提到的Method A与Method B,从计算效率、准确率、鲁棒性三个维度进行打分,并解释打分依据。”
- 趋势预测: “基于综述的‘未来展望’章节,总结作者提出的三个最有潜力的研究方向,并补充你认为可能存在的技术瓶颈。”
实战中的“避坑”指南与高阶技巧
在实际操作中,即便使用了结构化指令,仍需注意以下技术细节,以确保输出的权威性与可信度。
分段投喂与长窗口策略
尽管现在大模型支持128k甚至更长的上下文,但“迷失在中间”现象依然存在。对于超过50页的综述,建议采用分段指令:
- 第一阶段:仅投喂目录和引言,要求生成“知识框架树”。
- 第二阶段:针对核心章节,要求详细展开特定技术细节。
- 第三阶段:投喂结论部分,要求验证之前的总结是否一致。
引用溯源与事实核查
大模型极易编造参考文献。 在指令中必须加入约束:“在陈述观点时,必须引用原文的具体页码或章节编号,严禁编造不存在的文献。” 这一步骤符合E-E-A-T中的“可信度”要求,确保生成内容有据可查。
迭代式追问
不要满足于一次回答。专业的综述阅读是一个多轮对话的过程。
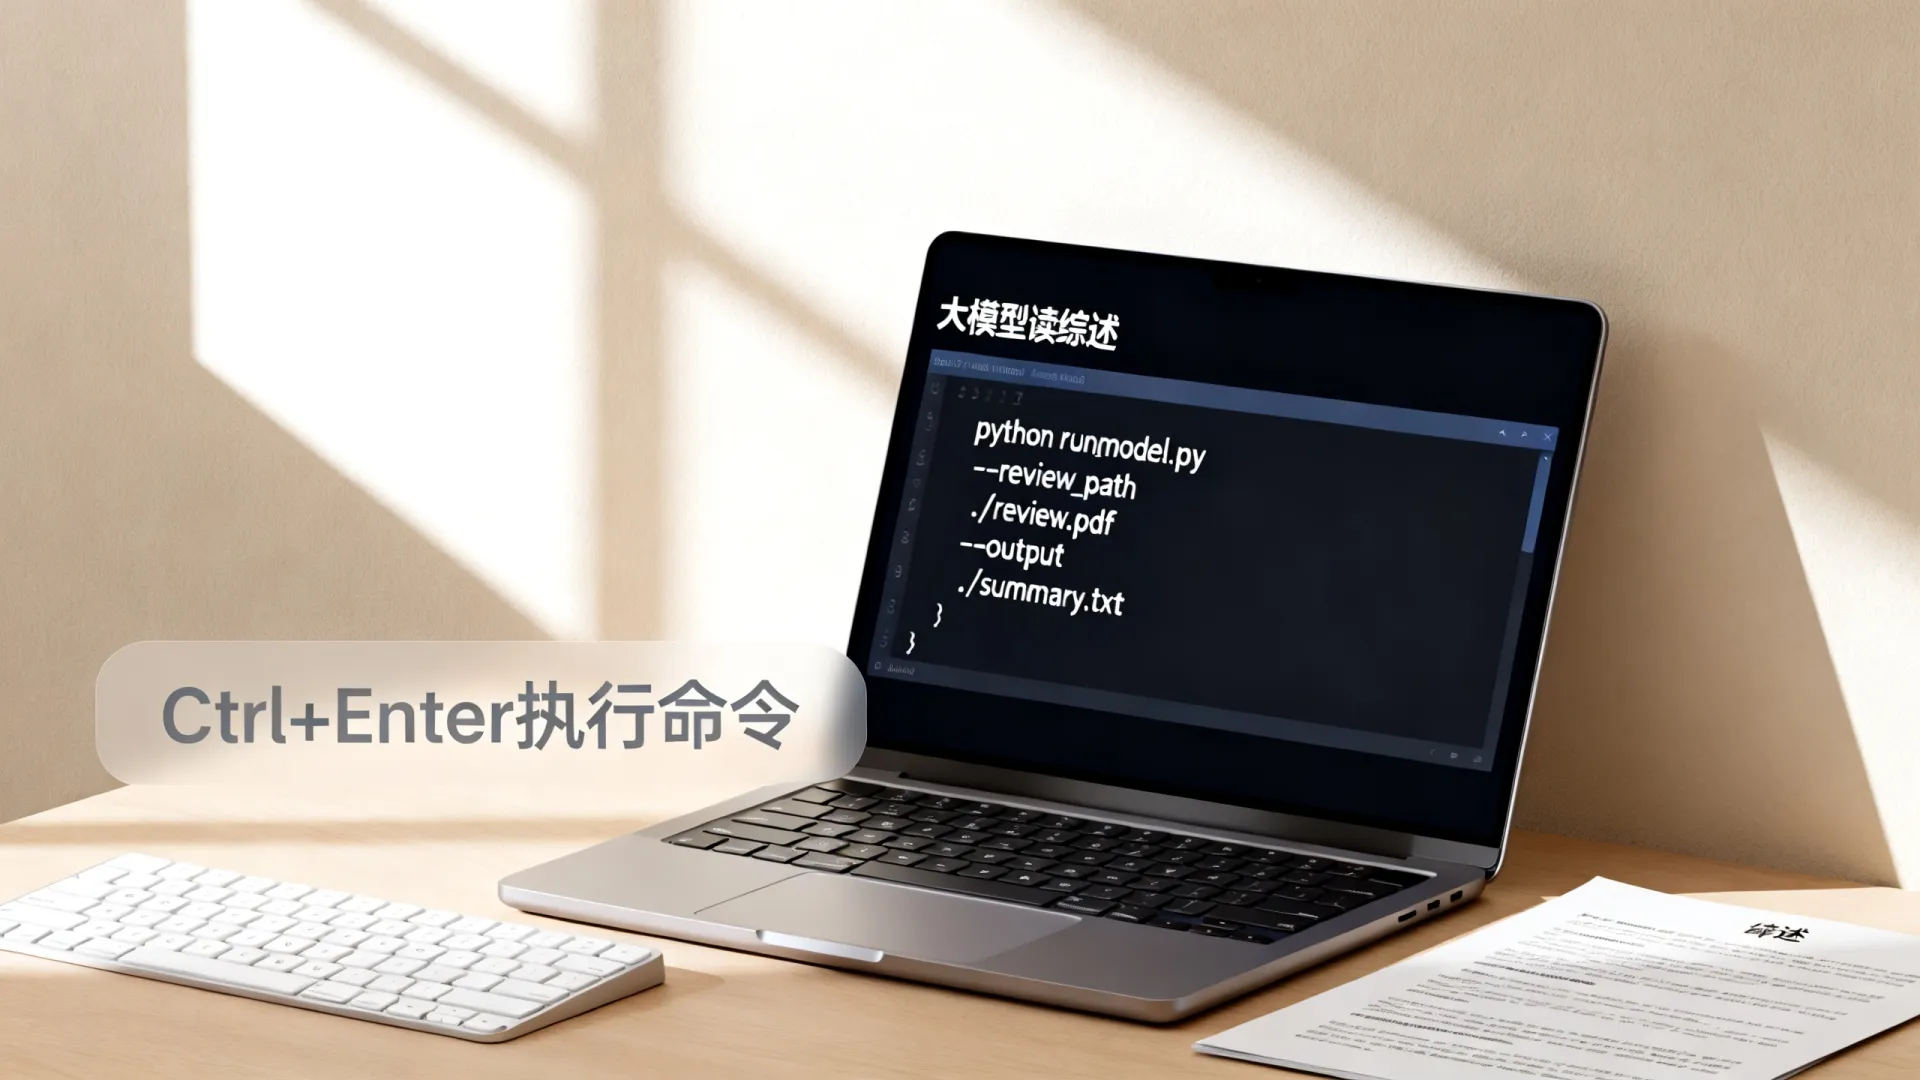
- “你提到的这个技术瓶颈,文中是否有给出具体的解决方案?请引用原文佐证。”
- “将上述分析内容整理成一份学术汇报PPT大纲,包含5个核心幻灯片页面。”
为什么你的命令效果不佳?
很多时候,问题不在于模型能力,而在于用户对“阅读”的定义不同,人类阅读综述是为了“构建知识体系”,而模型默认是“压缩文本”。
- 缺乏反馈机制: 用户往往在模型输出后直接结束对话。正确的做法是,指出模型输出中的错误或不足,你对第三章节的总结不够准确,忽略了关键的限制条件”,迫使模型进行自我修正。
- 忽视格式要求: 纯文本的输出难以阅读。强制要求模型使用“一级标题”、“二级标题”、“无序列表”、“加粗重点”等Markdown语法,能显著提升阅读体验。
驾驭大模型阅读综述,本质上是一场“人机协作”的思维博弈。核心不在于模型读了多少字,而在于你的指令“逼”它思考了多深。 通过角色设定、结构化输出、分段投喂和批判性追问,可以将大模型从一个简单的“摘要生成器”升级为真正的“科研副驾驶”,掌握这套逻辑,才能真正发挥AI在学术研究中的倍增效应。
相关问答
使用大模型阅读综述时,如何有效避免模型产生“幻觉”或编造虚假信息?
解答:避免幻觉的核心在于“约束源”与“验证机制”,在指令中明确要求模型“仅基于提供的文本回答,不要使用外部知识库”,这能切断模型“脑补”的来源,强制模型在回答中标注引用来源,如“请标注该观点所在的页码或段落”,采用“反向验证法”,要求模型列出文中未解决的问题或矛盾点,如果模型回答得过于完美且泛泛而谈,通常存在幻觉风险,需进行二次核查。
面对一篇100页以上的超长综述,大模型经常“遗忘”前面的内容,应该如何解决?
解答:这涉及大模型的“长上下文记忆”瓶颈,解决方案是采用“分治策略”与“摘要链”技术,不要一次性投喂全文,而是将综述拆分为引言、方法论、实验、结论四个部分,先让模型总结第一部分,生成一个精简的“中间摘要”,然后将这个摘要作为上下文的一部分,连同第二部分一起投喂,以此类推,通过传递“记忆摘要”,让模型始终保持对前文的认知,最终实现全篇的逻辑连贯。
如果你在让大模型读论文时也遇到过“一本正经胡说八道”的情况,欢迎在评论区分享你的经历或提问。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/65439.html