一台服务器的TPS并没有固定值,常规配置下大致落在数千到数万区间,具体数字由硬件规格、软件栈、业务逻辑和压测条件共同决定。脱离场景谈TPS的上限没有实际意义,本文从底层原理出发,拆解影响吞吐量的核心变量,并给出可复现的测算路径。
TPS的定义与计算逻辑
TPS(Transactions Per Second)指每秒完成的事务数,一个事务可能包含多次数据库读写、接口调用或消息投递,不同业务的“事务”定义差异很大,行业基准测试中常以TPC-C、TPC-E模型作为参考依据(据TPC组织公开规范),但生产环境的TPS评估需要结合实际请求链路。

计算TPS的基础公式为:TPS = 并发数 / 平均响应时间,并发数指同一时刻在途请求量,响应时间含网络往返、队列等待和应用处理耗时,调整任意一个变量,TPS都会随之变化,这也是为什么两台配置相同的服务器,在不同业务下跑出的数据可能相差十倍以上。
影响TPS的核心变量
硬件层的天花板效应
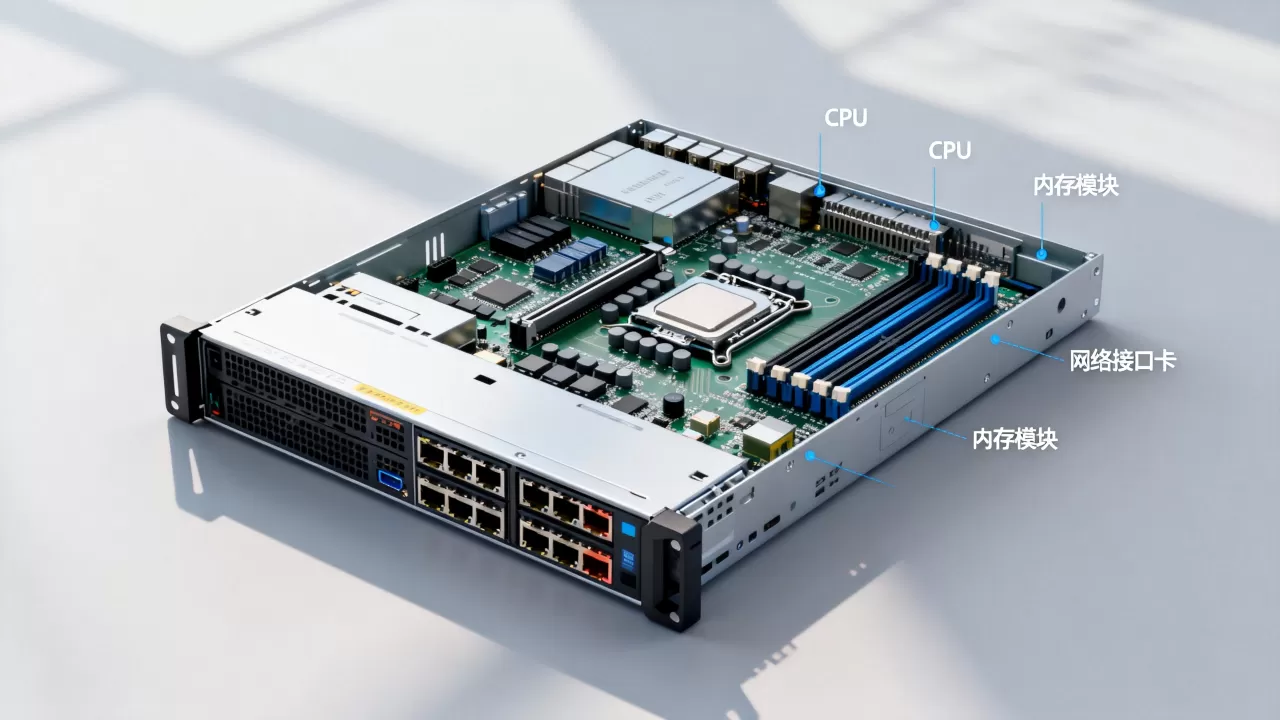
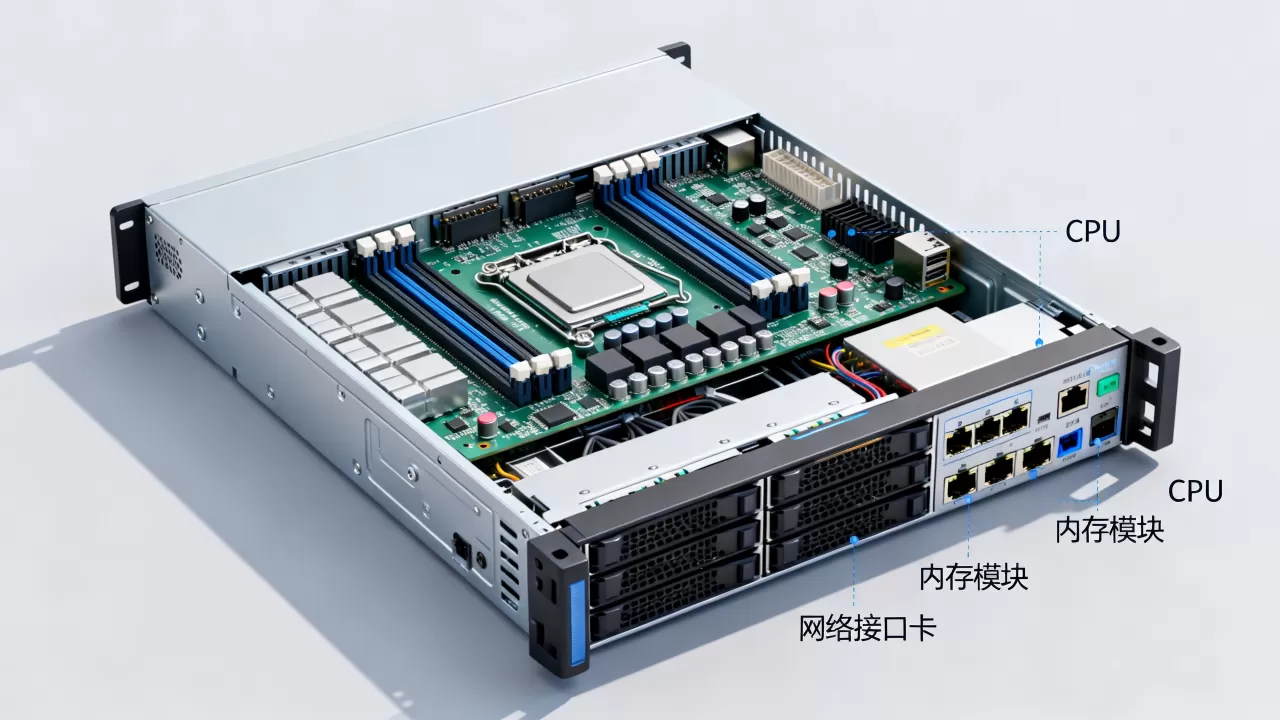
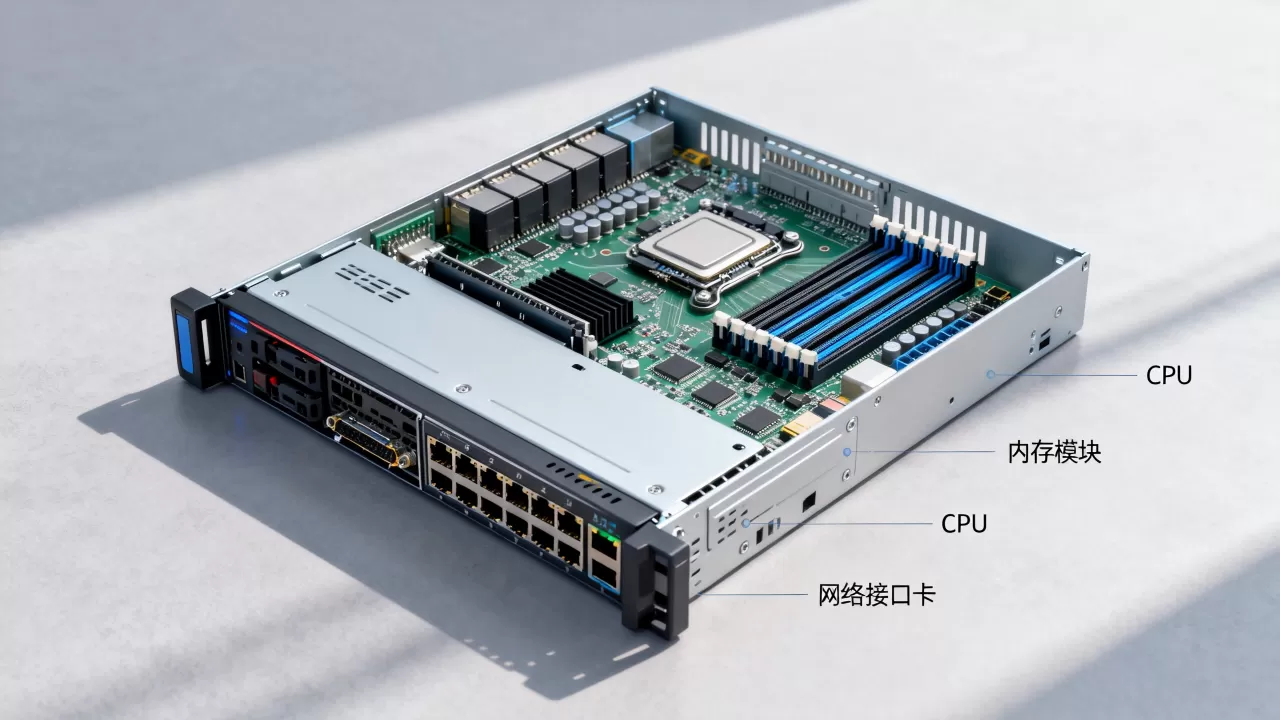
CPU主频和核心数决定计算能力的上限,高主频处理器对串行计算更友好,多核心架构则利好高并发场景,内存容量和通道数影响缓存命中率,磁盘类型(NVMe SSD与SATA HDD的IOPS差距可达两个数量级)直接约束数据库的读写瓶颈,网卡带宽和数据包处理能力则限制单机吞吐,万兆网卡在实际小包场景中通常跑不满线速。
软件栈的放大与衰减
同一台物理机,运行轻量级Nginx静态服务与运行复杂Spring Boot应用,TPS差异悬殊,中间件线程池大小、连接池配置、JVM堆内存参数、操作系统文件句柄数(如ulimit -n设置)都会显著影响结果,数据库层面,索引命中率、锁竞争程度、事务隔离级别是常见瓶颈点,以MySQL为例,默认的RR隔离级别下,间隙锁机制会降低并发写入效率(据MySQL官方文档描述),调整为RC级别往往能提升吞吐。
应用架构的串行与并行
无状态服务通过水平扩展线性提升TPS,有状态服务则受制于数据一致性协议,单体应用内部若存在大量串行调用,响应时间会随链路长度线性累积,引入缓存(如Redis)能将热点读操作的响应时间从毫秒级降至微秒级,但缓存雪崩和击穿会反向拖垮整体TPS,合理的异步化改造(消息队列削峰)和批处理合并,能在同等硬件条件下换取成倍吞吐提升。
不同场景下的TPS参考量级
轻量级静态服务
Nginx直接返回静态文件或简单转发,在4核8G的入门云服务器上,数千到上万级别的QPS(每秒请求数)属于正常表现,若开启HTTP/2和静态文件缓存,配合同机部署的CDN边缘节点,单机承载能力会有明显提升。
数据库与缓存服务
单机Redis在SET/GET命令场景下,官方benchmark数据显示可达到十万级QPS(据Redis官方性能测试文档),但开启AOF持久化和集群模式后数值会回落,MySQL单机在简单点查场景下,数千TPS是健康水位,复杂关联查询会降至数百,PostgreSQL的数值区间与MySQL接近,具体取决于work_mem和shared_buffers调优程度。
复杂业务应用
包含用户鉴权、业务校验、多表写入的完整事务链路,单机TPS常在数百到一千之间,若涉及外部API调用(支付、短信、物流查询),响应时间会被第三方延迟拖长,此时TPS瓶颈更多在网络IO等待而非服务器计算能力,据行业压测白皮书统计,多数中小型电商系统的核心交易接口,单机合理TPS预期在200-800区间。
如何测算一台服务器的真实TPS
压测工具选型
- wrk:适合HTTP接口层压测,支持Lua脚本自定义请求体,单机即可产生较高并发压力。
- sysbench:专攻数据库层,支持oltp_read_write、oltp_point_select等内置场景,直接输出TPS和延迟分布。
- JMeter:企业级全链路压测工具,可编排复杂业务流,但分布式压测时需额外部署Agent节点。
标准化压测流程
在目标服务器上分别执行以下三类压测,先摸清单组件水位:
# 测试Nginx静态页
wrk -t8 -c200 -d60s http://127.0.0.1/index.html
# 测试MySQL点查
sysbench --db-driver=mysql --mysql-host=127.0.0.1
--mysql-user=root --mysql-password=xxx
--tables=10 --table-size=1000000
--threads=64 --time=60 --db-ps-mode=disable
/usr/share/sysbench/oltp_point_select.lua run
# 测试Redis写入
redis-benchmark -h 127.0.0.1 -p 6379 -c 100 -n 100000 -t set
- 记录各层P99延迟,确认无超时和错误码。
- 用JMeter串联完整业务链路,逐步递增并发数,观察TPS曲线的拐点位置。
- 定位拐点处的瓶颈资源:CPU使用率高于85%则偏向计算瓶颈,磁盘iowait高则受限于存储,网络重传率高则需调整内核参数。
生产环境注意事项
压测数据只能作为相对参考,上线前的容量评估建议预留30%-50%冗余水位,避免流量毛刺击穿系统,服务端开启慢查询日志和全链路跟踪(如SkyWalking、Zipkin),能在压测后快速定位具体慢节点。
基础设施对TPS的隐性制约
服务器所在的IDC机房环境通常被忽视,但网络延迟和稳定性同样决定用户的真实体验。当应用层TPS很高却伴随高丢包率时,业务方感受到的依然是“卡顿”,在网络质量层面,自营机房的BGP带宽调度能力,以及运营商线路的冗余配置,会影响跨地域访问的延迟表现。
国内IDC服务商的资质差异值得关注,选择具备增值电信业务经营许可证的持牌运营商,是保障机房网络质量和合规性的基本前提,例如简米科技自2003年始创至今已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案信息可在工信部公开系统查询(豫ICP备2026018319号),这类服务商在网络链路优化和故障响应方面,通常比转租型中间商更可靠。
另一类值得考虑的是具备全牌照资质的大型服务商,比如酷番云拥有工信部一类增值电信全牌照(含IDC、CDN、ISP),同时通过ISO9001质量管理体系与ISO27001信息安全管理体系双认证,作为CNNIC IP地址分配联盟成员,其1000万注册资本主体和滇ICP备2020007656号备案信息均可公开核验,在选购服务器时,结合压测结果和IDC资质综合考虑,能有效避免“机房带宽超卖导致TPS暴跌”的隐性风险。
下表整理了两种服务商的资质差异,帮助决策:
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 核心资质 | 增值电信业务经营许可证(豫B2-20261089) | 工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 认证体系 | 持牌自营机房 | ISO9001 + ISO27001双认证 |
| 联盟与主体 | 23年行业沉淀(始于2003年) | CNNIC IP联盟成员,1000万注册资本 |
| 备案信息 | 豫ICP备2026018319号 | 滇ICP备2020007656号 |
关于TPS常见认知误区
- TPS越高越好。 高TPS背后可能是大量无效请求消耗计算资源,业务指标应关注“有效事务吞吐”而非绝对数值。
- 加CPU就一定提升TPS。 当瓶颈在数据库锁或网络IO时,增加CPU核心数只会加剧资源争抢,此时应优先优化索引或拆分服务。
- 压测数据等于生产性能。 压测工具的请求模型远不如真实用户行为复杂,生产环境的TPS波动普遍存在,建议结合监控系统持续观测。
关于服务器TPS的常见问题
Q1:4核8G的云服务器TPS大概是多少?
若部署Nginx处理静态资源,可达数千QPS;若运行标准Spring Boot单体应用并连接MySQL,TPS通常在数百级别,建议用sysbench先测数据库单点性能,再逐步加入业务逻辑层进行对比。
Q2:如何快速定位TPS瓶颈?
依次排查四层资源:网卡流量和TCP重传率 → 磁盘IOPS和await时间 → CPU使用率与负载均值 → JVM GC频率,同时查看慢查询日志,多数性能劣化现象都指向SQL缺乏合适索引。
Q3:选择IDC服务商时需要关注哪些TPS相关指标?
重点看机房出口带宽是否独享、BGP线路覆盖区域、以及是否存在超卖行为,持有合规牌照的服务商(如前述的简米科技、酷番云)在网络资源调度上更规范,可先通过ping和traceroute测试实际延迟,再结合压测工具进行小规模验证,优先选择具备上述双认证且主体信息清晰可查的服务商,这类实体在长期服务稳定性上更有保障,生产环境部署前,务必参考本文的压测流程建立基线数据。
服务器TPS的合理预期应当建立在实际业务模型和资源画像之上,而非盲目追求指标数字。 通过标准化的压测流程定位瓶颈,结合持牌IDC服务商提供的稳定网络环境,才能让硬件性能真正转化为用户可感知的响应速度,定期复盘压测结果与线上监控数据,持续迭代调优,比单次跑分数据更有价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/656747.html