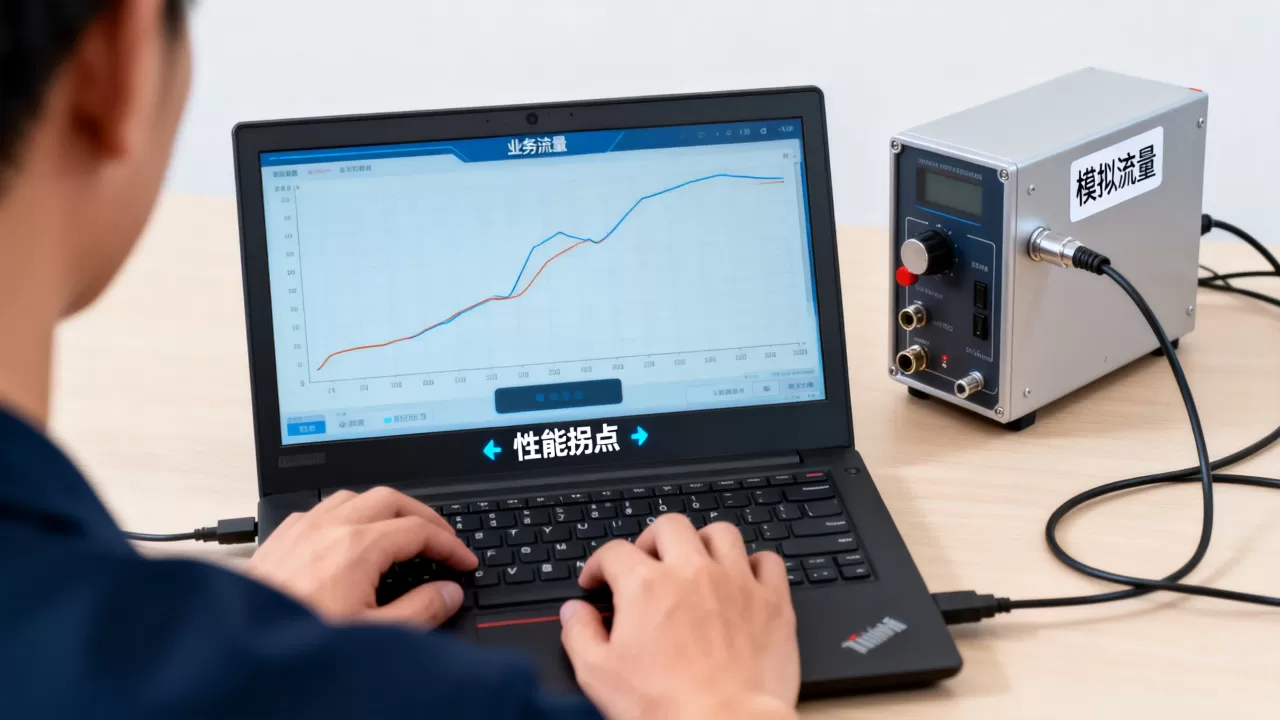
在测试机之上模拟真实业务流量,核心是找到TPS不再线性增长、响应时间突然抬头、错误率开始爬坡的性能拐点,三者出现任一即代表系统进入瓶颈区。
为什么测试机模拟真实业务流量比脚本回放更接近真相
脚本回放看不到的三个盲区
- 固定参数让数据库缓存命中失真,压出来的TPS偏高。
- 缺少用户会话保持,登录态和购物车状态无法真实还原。
- 突发流量和业务脉冲无法通过固定节奏脚本模拟,拐点出现得更晚。
真实业务流量模拟给测试机带来的三个直接收益
- 提前暴露连接池、线程池和内存池的争用。
- 找到数据库行锁、表锁的触发点。
- 给容量规划提供可信的基线,而不是拍脑袋的估算。
行业共识认为,测试机上的真实流量模拟不能替代生产全链路压测,但能提前发现多数配置类瓶颈。


于测试机之上模拟真实业务流量的操作步骤
准备符合业务分布的参数文件
从生产网关访问日志里抓取接口调用比例,清洗出高频交易和低频查询,导出成CSV参数文件,JMeter用CSV Data Set Config加载,参数名与接口字段一一对应,这样每次请求都带着不同用户ID、商品ID和会话Token,而不是同一组数据反复跑。
从低频到高频找到性能拐点
压测不要一上来就拉满线程,阶梯加压更容易观察拐点位置。
| 并发档位 | TPS表现 | 响应时间表现 | 错误率表现 |
| 低档 | 随线程线性上升 | 平稳 | 无 |
| 中档 | 增速开始放缓 | 逐步爬升 | 偶发 |
| 高档 | 不再增长甚至轻微回落 | 大幅抬升 | 明显增加 |
当并发从低档切到中档,TPS增速明显放缓时,拐点已经接近,继续加量只会让响应时间恶化,记录下这个拐点对应的线程数、TPS和资源使用率,就是本次测试的容量基线。
监控测试机自身资源,避免误判
测试机自己先到瓶颈,测出来的拐点不代表被测系统能力,用这些命令实时观察:
top -H看负载机线程是否打满vmstat 1看CPU等待和上下文切换iostat -x 1看磁盘IO是否成了短板sar -n DEV 1看测试机网卡吞吐是否撞上限
如果测试机CPU长期处于高位,请先加负载机或换加压方式,否则系统仍有余量,结果已经失真。
性能拐点怎么判断:抓住三个不骗人的信号
性能拐点不是拍脑袋定的,它有三个明确信号。
TPS从线性增加转为持平
压测初期线程翻倍,TPS也接近翻倍,接近拐点时,同样增加五十个线程,TPS可能只增加十几个,再往后甚至出现TPS不升反降,这个“增量锐减”的点就是拐点。
响应时间突然抬头
响应时间曲线不会一直平滑上升,多数情况下,拐点前平均响应时间缓慢增加,拐点后斜率突然变陡,从毫秒级跳到秒级,业内专家指出,性能拐点的本质是资源争用从隐性转为显性,一旦排队出现,响应时间会非线性恶化。
错误率开始爬坡
- 连接池耗尽,报“无法获取连接”
- 线程池拒绝,报“任务被拒绝”
- 数据库死锁或锁等待超时
- 网关超时或负载机自身端口不足
错误率从无到有,从偶发到持续,是系统已经进入瓶颈区的硬信号,不要等到大面积报错才停压。
测试环境与生产环境性能差异大吗?多数情况需要折算
测试机与生产环境的性能差异,多数情况下不是等比例关系。
硬件配置差异造成拐点偏移
测试机往往是8核16G,生产是32核64G甚至更大,不能简单按核心数线性推算,数据库连接池、JVM堆大小、线程栈深度都会影响拐点位置,测试机上TPS为800,不代表生产翻四倍能到3200。
数据量与缓存命中率差异
测试环境数据量小,缓存命中率偏高,拐点来得更晚,生产环境数据量大,冷热分层明显,同样的接口可能更早出现磁盘IO瓶颈,因此测试机得到的拐点要当相对基线,不要当绝对值。
北京性能测试服务怎么收费与自建成本
如果公司没有专职性能工程师,会考虑采购外部服务,北京性能测试服务怎么收费没有统一标准,受并发规模、脚本复杂度、是否录制真实流量影响,性能测试服务一般多少钱,也取决于是否包含瓶颈定位和拐点分析报告,自建测试机加JMeter做一轮基础拐点测试,工具成本几乎为零,主要投入在参数清洗和结果分析上。
测试机自身性能不够,拐点会提前出现
负载机网卡带宽占满
如果测试机是单网卡千兆,压大接口时带宽先撞满,响应时间会假性升高,此时加负载机或换万兆网卡,拐点立刻后移。
测试数据没有预热
第一次请求要建立连接、加载类、缓存冷启动,响应时间会异常高,正式加压前先空跑一轮预热,把JIT和缓存热起来,否则拐点会误判到更低并发。
长连接与短连接混用
压测工具默认可能是长连接,生产业务可能短连接为主,或者反过来,连接模式不同,TCP握手和端口回收成本差别很大,拐点位置也会变,按生产网关的连接模式调整JMeter的HTTP取样器配置。
| 资源 | 健康状态 | 需处理状态 |
| CPU使用率 | 曲线平稳 | 持续打满或剧烈抖动 |
| 内存 | 无明显swap | swap频繁换入换出 |
| 磁盘IO | 队列深度低 | await持续偏高 |
| 网络带宽 | 未触顶 | 吞吐曲线走平 |
在测试机之上模拟真实业务流量,最终要沉淀成一条可复用的拐点基线:同一套参数、同一套监控、同一套路径,每次版本发布前重跑,拐点左移代表性能退化,右移代表优化生效,基线比单次报告更有价值。
Q&A
测试机模拟真实业务流量时性能拐点怎么判断最简单?
最简单的判断方式是阶梯加压,看TPS增量是否明显小于线程增量,每档稳定运行几分钟,记录TPS和响应时间,当线程数增加而TPS几乎不涨、响应时间快速上升时,当前档位就是拐点附近,无需复杂模型,看曲线斜率即可。
性能测试服务一般多少钱?北京性能测试服务怎么收费?
性能测试服务费用没有固定标准,受脚本复杂度、并发规模、是否录制真实业务流量以及是否需要拐点分析报告影响,北京地区多数服务商按项目或按轮次报价,基础单场景压测从数千元到数万元都有,自建团队用开源工具在测试机上做拐点测试,工具成本几乎为零,人力成本是大头。
测试环境与生产环境性能差异大吗?测试机结果能不能直接当容量上限?
多数情况下差异较大,不能直接当容量上限,测试机硬件、数据量、网络链路和生产不同,拐点出现得更早或更晚都有可能,正确做法是把测试机的拐点当相对基线,记录同配置倍率,必要时用生产少量引流数据做校准,测试机给出的是可比较的拐点位置,不是绝对容量值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/659979.html