高密度虚拟化服务器的散热和供电必须捆绑设计,先按机柜实际功耗密度倒推散热方式和电源冗余,再部署虚拟机,否则后期大概率出现局部热点或断路器跳闸。
机架式服务器功耗多少瓦:先算清热负荷
虚拟化环境里,一台物理机承载的虚拟机数量越多,CPU、内存、网卡的持续负载越高,功耗也越接近标称上限,很多人在做虚拟化整合时只看服务器标称功率,忽略了真实运行功耗,结果上架后发现一个42U机柜只放6台机器就跳闸。

影响功耗的主要部件如下:
- CPU:双路至强或霄龙处理器,满载功耗通常在几百瓦区间,空闲时大幅下降。
- 内存:单条DDR4/DDR5功耗不算高,但128GB以上容量插满几十条后,总量不可忽视。
- NVMe固态盘:持续写入时功耗明显高于SATA SSD,高IO负载下每块可能多消耗数瓦到十几瓦。
- 网卡:25G/100G网卡满载时也有一定功耗,双口或四口累积起来不能忽略。
- GPU或FPGA卡:如果做虚拟化AI推理或图形加速,单卡功耗可能高达数百瓦。
常见机架式服务器功耗场景可参考下表:
| 服务器形态 | 典型配置 | 单台功耗粗略范围 |
|---|---|---|
| 1U单路 | 单CPU、4条内存、2块SATA SSD | 较低,多在百瓦级 |
| 2U双路 | 双CPU、16条内存、4块NVMe | 中等,数百瓦到上千瓦 |
| 4U四路 | 四CPU、大量内存、多GPU | 高,可能突破千瓦 |
要获得真实功耗,不要用电源额定功率代替,可以登录服务器的带外管理口查看实时读数,以HPE iLO为例,通过SSH执行:
show /system1/power
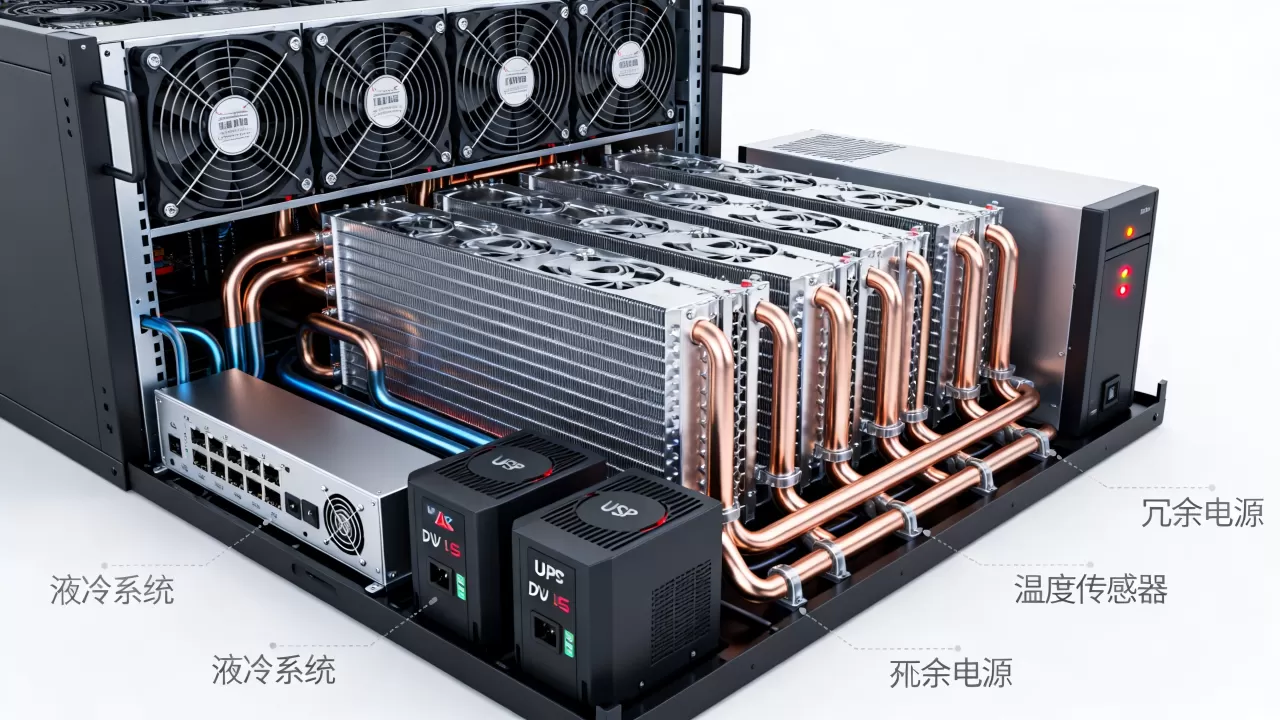
Dell iDRAC可使用racadm命令或Web界面查看Power Consumption,Linux系统内也可以用ipmitool sensor读取功率相关传感器,但部分平台不一定暴露,实测比估算可靠,尤其是高密度虚拟化场景。
高密度虚拟化服务器散热怎么解决
高密度虚拟化最常见的散热问题不是空调总冷量不够,而是气流组织失效,多台高功耗主机堆叠后,机柜后部热空气无法快速排走,前部冷空气被短路,导致局部热点频繁触发CPU降频或宕机。
先做机柜级气流管理
- 封闭所有空U位,使用空白挡板,防止热风从机柜后部绕回前面。
- 检查服务器内部导风罩是否齐全,尤其是自己加装PCIe卡后是否被拆除。
- 使用前后网孔门,避免玻璃门阻挡气流。
- 如果机柜密度较高,优先做热通道封闭,让热风直接回到精密空调回风口。
- 冷通道地板开孔位置要对准机柜前部,不要大范围开孔导致风量浪费。
再判断制冷方式是否需要升级
多数高密度虚拟化机柜仍可采用风冷,但对单柜功率有明确约束,行业共识认为,普通精密空调加好的气流组织,单柜可稳定散掉相当可观的热量,但如果单柜持续超过一定密度,就需要引入行级空调或背板空调。
北京机房服务器托管散热要求通常比南方部分城市更复杂,北京四季温差大,冬季可以利用自然冷源,但春秋季沙尘天气多,新风系统需要更细的过滤维护,虚拟化高密度机柜在托管前,最好先确认机房是否支持高功率密度,不同机房的单柜供电和散热上限差异很大。
液冷什么时候值得考虑
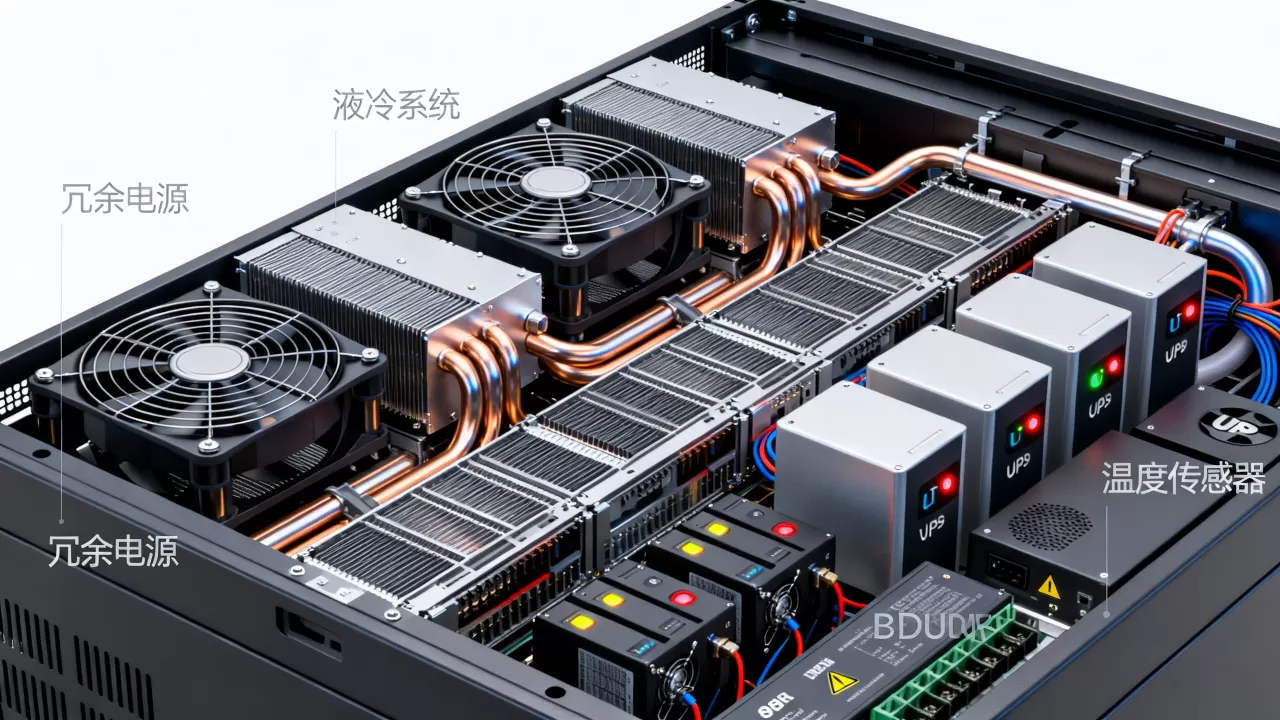
当单机柜功率密度高到风冷已经无法稳定维持时,液冷才会成为必选项,目前多数虚拟化集群还没到这个阶段,真正推动液冷的是带大量GPU的AI服务器,或者超大规模虚拟化整合后的整机柜高密度部署,对于普通2U双路虚拟化主机,先优化风道和热通道封闭,成本远低于上液冷。
虚拟化服务器供电方案对比:单路还是双路更稳
供电方案直接决定虚拟化集群的可用性,高密度场景下,供电不足带来的风险比散热更隐蔽,因为散热问题通常会先表现为性能下降,而供电问题可能直接触发宕机或硬件损坏。
三种常见供电模式
| 方案 | 结构 | 优点 | 缺点 |
|---|---|---|---|
| 单路供电 | 单配电单元,单电源 | 成本最低 | 任何一点故障都会中断业务 |
| N+1冗余 | 多电源模块,其中1个备用 | 电源故障不停机 | 配电侧可能仍是单路 |
| 2N冗余 | 双路输入,双PDU,双电源 | 任一路故障都不影响 | 成本明显上升 |
虚拟化服务器本身通常都支持双电源模块,但很多人把两个电源接到同一个PDU上,这并不能称为真正的2N冗余,正确做法是:双路市电或UPS输出分别接入两个独立PDU,服务器两个电源分别连接这两个PDU。
高密度机柜要算清的三个数
- 单柜总功率:把所有服务器的实测功耗相加,再留出一定余量,不能按电源额定功率叠加。
- PDU额定电流:例如32A单相PDU,实际可用功率要打折扣,不能满载长期运行。
- UPS输出能力:确认该机柜所在的UPS分配单元是否有足够余量,尤其是夜间或节假日负载变化。
实际操作中,可以先列出每台服务器的带外管理地址,逐个读取实时功耗,导出到表格求和,然后核对配电柜断路器和PDU标签,看是否满足需求,供电改造通常比散热改造更麻烦,因为涉及停机窗口和配电安全。
机柜功率密度与扩容顺序
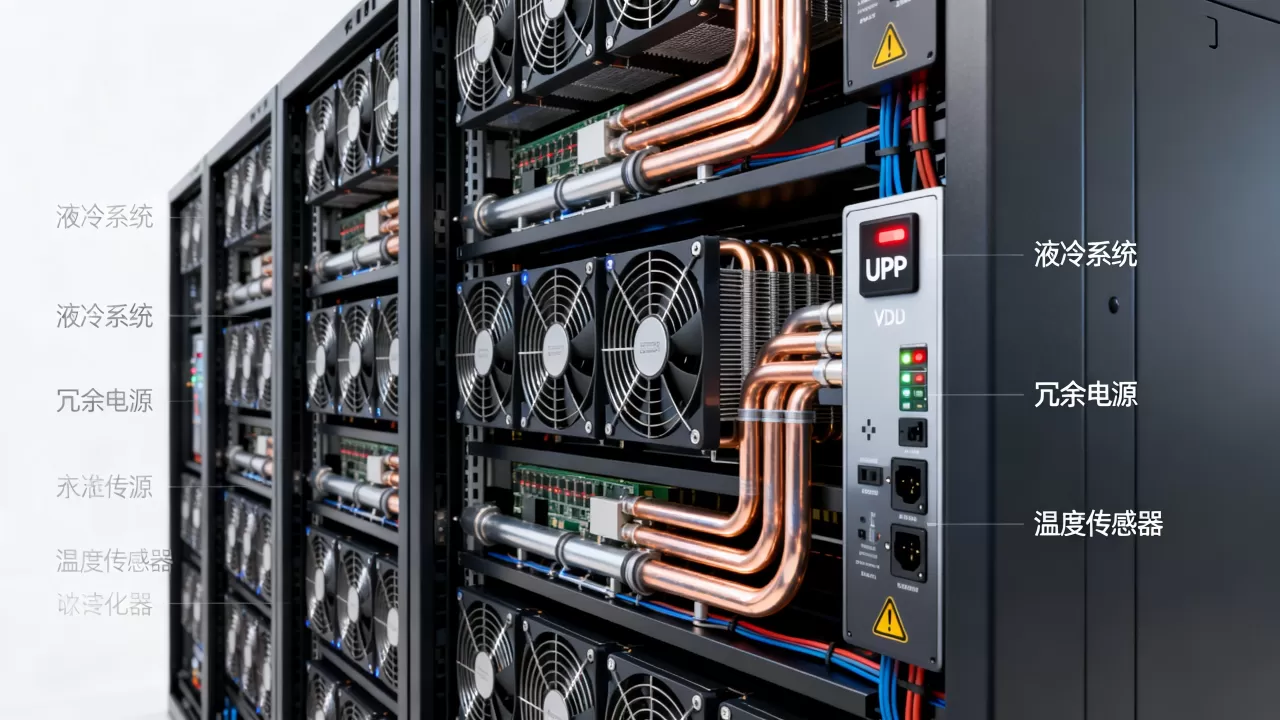
高密度虚拟化部署不能一上来就插满机柜,稳妥的做法是分阶段扩容,每阶段都验证散热和供电是否同步跟上。
- 第一阶段:先上架少量高功耗节点,实测单柜温升和功耗。
- 第二阶段:补齐空白挡板,调整地板开孔,持续监测不同区域温差。
- 第三阶段:根据实测数据决定是否增加行级空调或升级PDU。
- 第四阶段:再继续填充虚拟机负载,观察CPU降频和磁盘IO延迟。
这种顺序可以避免一次性投入过大,也能防止局部热点在深夜负载升高时才暴露,高密度服务器散热成本里,最大的隐性成本往往是后期拆机柜、重新布线的停机损失,而不是空调或PDU本身。
高密度虚拟化服务器供电散热常见问题
高密度虚拟化服务器散热怎么解决最省成本?
先做无成本或低成本的气流管理,比如安装空白挡板、整理线缆、封闭热通道,再根据实测温度数据决定是否增加制冷设备,盲目增加空调数量而不做气流组织,多数情况下效果很差,还增加电费。
虚拟化服务器供电方案对比中,2N和N+1哪个更划算?
要看业务对停机的容忍度,N+1只解决电源模块故障,不解决配电链路或UPS故障;2N解决从输入到输出的完整冗余,如果虚拟化集群承载核心数据库或大量生产虚拟机,2N更合适;如果只是测试环境或可快速恢复的业务,N+1成本更低。
北京机房服务器托管散热要求为什么比南方部分城市更复杂?
北京可以充分利用自然冷却,但沙尘天气要求新风过滤更频繁,北京部分老旧机房电力容量紧张,提升单柜功率密度前需要重新核算配电,这些条件叠加后,散热和供电的配合比单纯追求低温更关键。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/661060.html