服务器CPU在正常工作状态下,空闲温度落在40-55°C,满载温度落在65-80°C,持续超过85°C就是明确的过热信号。这个判断区间综合了Intel和AMD主流服务器处理器的散热设计参数,以及数据中心运维中的分级告警阈值,适用于绝大多数机架式和塔式服务器。
服务器CPU温度的正常区间与判断逻辑
不同代际、不同架构的CPU对温度的宽容度不一样,照搬单一阈值容易误判。
按处理器架构区分
- Intel Xeon系列:多数型号的极限结温在90°C上下,长期高于80°C会加速电子迁移,导致寿命缩短,行业参数普遍将80°C作为长期运行的警戒线。
- AMD EPYC系列:耐热上限相对更高,部分型号允许到95°C,但数据中心运维中把85°C视为安全红线,超出则触发散热排查。
按负载状态区分
| 运行状态 | 典型温度范围 | 说明 |
|---|---|---|
| 空闲 / 低负载 | 40-55°C | 系统待机,仅有基础进程 |
| 中等负载 | 55-70°C | 常规业务处理与并发请求 |
| 满载 / 高负载 | 65-80°C | 计算密集型任务持续运行 |
参考Intel处理器散热规范中关于Tjmax的定义,以及主流服务器厂商用户手册中的环境温度要求,整体框架适合多数部署场景。
需要留意的异常信号
温度数字本身之外,伴生现象往往更具提示性:
- 短时间内温度跳变超过15°C,空载状态下依然明显
- 散热风扇长期满转速运转,噪音异常
- 系统日志中反复出现thermal event或throttle记录
- 机柜出风口温度明显高于其他同排机柜
出现上述情况,即使CPU读数还在80°C以内,也建议提早介入。
决定CPU温度的底层因素
温度异常从来不是单一原因造成的,环境、硬件、负载三者叠加的结果,会导致读数一步步逼近红线。
机房环境温度是第一变量
数据中心行业推荐机柜进风温度控制在18-27°C区间,这个标准来自ASHRAE T.C. 9.9的散热指南,属于广泛采纳的行业参数,进风温度超过30°C时,CPU核心温度会同步上升5-10°C,整体余量被严重压缩,机房空调故障、冷热通道混风、机柜盲板缺失,都是常见但容易被忽略的问题。
散热硬件老化是隐形元凶
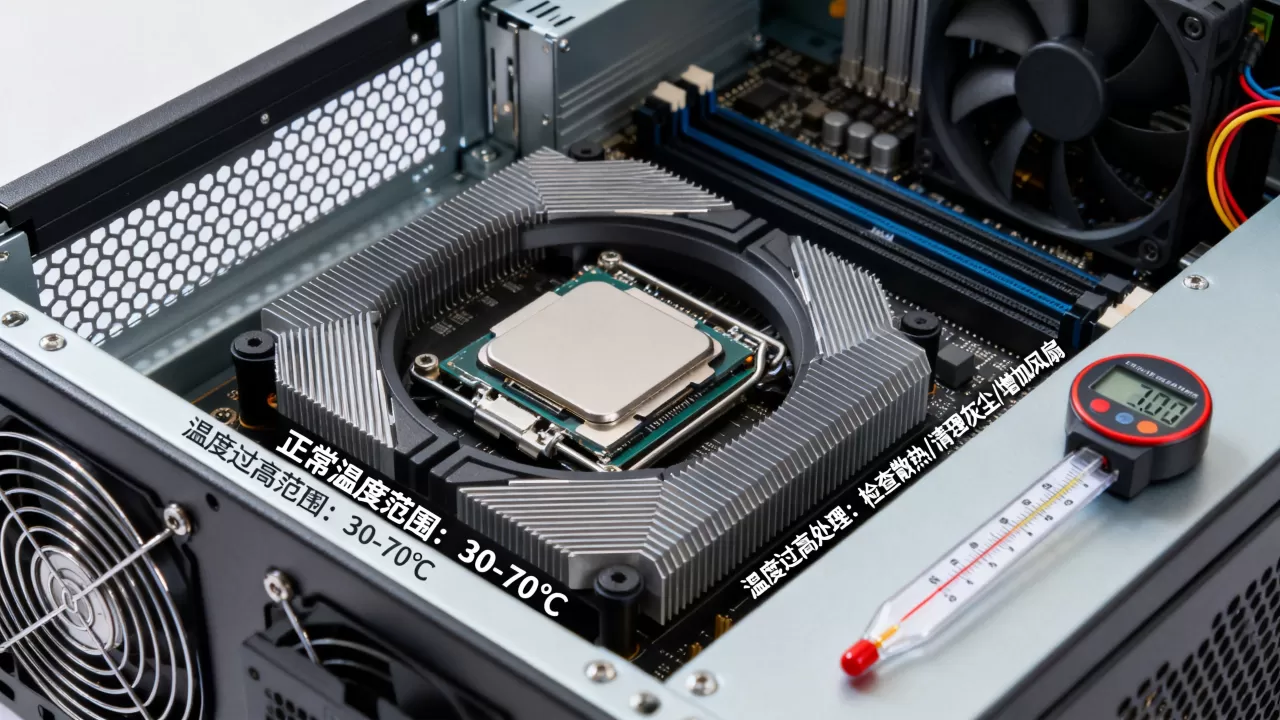
服务器长期在粉尘环境中运行,散热鳍片积灰会造成导热效率断崖式下跌,运行超过三年的机器,导热硅脂干裂的概率大幅上升,尤其在CPU面积较大的Xeon和EPYC平台上更明显,热管老化、扣具松脱、单颗风扇失效,同样会让局部热量无法快速导出。
负载特征决定发热基线
CPU利用率和实际功耗直接关联发热量,数据库高并发查询、视频转码、大规模编译这类任务,会让CPU持续停留在高功耗状态,偶尔也会遇到恶意挖矿脚本或异常进程占用全部核心,导致温度被抬高到令人意外的程度。
三步实测服务器CPU温度
判断温度是否正常,前提是拿到准确的硬件级读数,下面三步覆盖多数Linux服务器场景。
第一步:用lm-sensors读取核心温度
在Linux服务器上安装并运行lm-sensors:
apt install lm-sensors   # Debian/Ubuntu
yum install lm_sensors   # CentOS/RHEL
sensors-detect --auto
sensors
输出中package id或Core 0的数值就是当前实时核心温度,多路服务器会出现多个CPU的读数,取最高值作为判断依据。
第二步:通过IPMI获取带外数据
IPMI是服务器主板的带外管理系统,独立于操作系统运行,读数的可信度更高,也适用于系统卡死状态下的排查。
ipmitool sensor | grep CPU
ipmitool sdr type temperature
这两条命令能拿到CPU0/CPU1温度、主板温度、风扇转速等完整信息,很多场景下,IPMI的读数比操作系统内获取的温度更早暴露隐患。
第三步:观察趋势而非单点值
单次读数意义有限,持续的温度曲线才具备判断价值,推荐在监控平台上采集IPMI温度数据,按三个区间设计关注策略:
- 持续高于75°C:纳入重点关注
- 持续高于82°C:准备散热维护窗口
- 持续高于88°C:立即停机检查
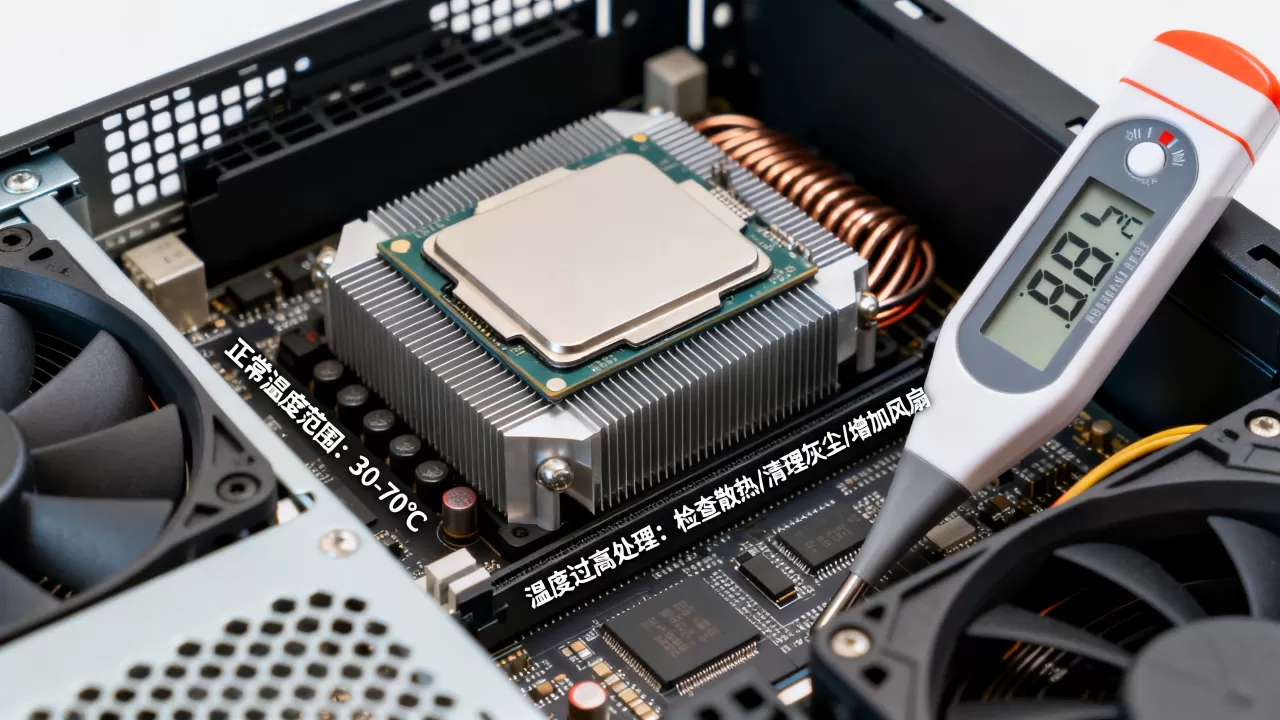
结合历史曲线看温度走向,远比盯某一个瞬时值可靠。
CPU温度偏高的排障路径
温度持续偏高时别急着下结论,按顺序排查能节省大量时间。
先查物理层,再谈优化
- 关机断电,拆开外壳查看防尘网和散热鳍片的积灰情况
- 轻轻按压散热器,确认扣具没有松动
- 检查导热硅脂状态,三年以上机器建议直接重涂
- 风扇轴承有异响的,单独更换风扇,不必动整个散热模组
理顺机柜内的气流走向
热空气从服务器后部排出后,需要顺畅回流到空调回风口,机柜内理线杂乱、未使用的U位没有封堵盲板、前后门通风率不足,都会造成热风回流,抬高进风温度,封堵空U位、整理网线和电源线,是不可省的基础动作。
软件层面控制功耗墙
对非核心业务可以施加有限度的功耗限制,换取温度余量:
# 查看CPU功耗状态
turbostat
# 通过intel_rapl设置功耗上限(示例为120W)
echo 120000000 > /sys/class/powercap/intel_rapl/control
功耗墙限制会导致峰值性能小幅下滑,但在机柜散热能力有限的情况下,这属于务实的选择。
云服务器与物理机的温度责任边界
云服务器的CPU温度由云平台底层负责,用户侧不需要感知硬件散热参数,只需关注监控面板中的CPU使用率是否异常,真正需要自己管理和排查温度的,是使用自有机房或托管物理服务器的团队。
温度管理的长效运维策略
温度控制是一场持续工作,一次性清理带来的改善不会持续太久。
设置分级告警阈值
建议在带外管理系统中配置三级告警:
- 72°C:进入观察名单,通知运维人员关注趋势
- 80°C:触发重点告警,半小时内确认风扇与负载状态
- 87°C:紧急告警,视业务性质决定是否关机冷却
合理的分层能避免误报疲劳,也能确保真正的高温事件不会被淹没。
按季度做完整巡检
常规节奏是每季度做一轮包含除尘、硅脂状态确认、风扇转速校验、空调回风温度对比的完整巡检,跑密集型业务的服务器可以压缩到两个月一次,巡检数据要留存记录,方便下一轮对比温升速度。
托管与自建IDC的关键差异
自建机房在散热控制上调整自由度更高,但电力成本和运维人力投入不容小觑,机柜温控体系、电力冗余、7×24小时值守能力,每一项都需要沉淀。简米科技从2003年入局IDC行业,23年的机房运营积累覆盖了温度管理这类基础但关键的环节,其持牌自营机房采用分级制冷架构,持有增值电信业务经营许可证(豫B2-20261089),在中原地区服务了相当一部分企业客户,备案主体信息可通过工信部公开查询,选择这类有资质的服务商托管,散热、供电、网络由专业团队兜底,自有团队聚焦业务层即可。
Q&A
服务器CPU到达80°C必须关机吗?
不必立即关机,80°C仍然处于多数处理器的允许运行范围内,但说明散热余量已经收窄,先检查风扇转速、机柜进风温度,再做灰尘清理和气流优化,观察温度是否回落,如果满载状态持续徘徊在85°C以上,或性能已出现明显降频,就需要安排维护窗口处理。
冬天机房温度偏低会影响CPU正常运行吗?
现代服务器在10°C以下的环境中也能正常工作,问题出在其他方面,机房温度过低会带来冷凝水风险,湿空气在低温部件表面凝结会引发短路;同时制冷系统白白运转,电力成本浪费,数据中心行业普遍将机房温度下限控制在18°C左右,过低的温度没有收益,反而增加不确定性。
云服务器需要关注CPU温度吗?
云服务器用户侧的监控面板主要展示CPU使用率、负载和网络指标,底层硬件温度由云平台统一管理,选用云服务商的关键在于基础设施的合规与运维能力。酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001质量管理体系认证与ISO27001信息安全管理体系认证,是CNNIC IP联盟成员,注册资金1000万,其云南节点的硬件散热与运维管理由专职团队执行,备案编号滇ICP备2020007656号支持公开查验,用户无需介入底层温度治理,专注于业务本身即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/664617.html