H800服务器与H100服务器的本质区别在于:计算核心完全一致,但H800的NVLink互联带宽被限制为400GB/s(约为H100的44%),这是为符合出口管制而生的“阉割版”。对于大模型训练这类依赖多卡通信的场景,H100的集群效率明显占优;而在单卡推理或对算力密度要求高、对卡间通信不敏感的负载中,H800表现与H100几乎没有差别,下面我们从芯片规格、整机设计、应用场景、合规与采购等几个维度逐层拆解。
H800与H100的核心规格差异
GPU芯片级别的参数对比
抛开营销话术,直接看硅片层面的硬指标,H800和H100都基于台积电4N工艺,拥有800亿个晶体管,都采用Hopper架构,都支持第四代Tensor Core,两者在FP64、FP32、TF32、BF16、FP8、INT8等所有精度下的单卡计算峰值完全相同。


| 核心规格 | H100(SXM) | H800(SXM) |
|---|---|---|
| 架构 | Hopper | Hopper |
| 晶体管数 | 800亿 | 800亿 |
| 显存容量 | 80GB HBM3 | 80GB HBM3 |
| 显存带宽 | 约3.35TB/s | 约3.35TB/s |
| FP16 Tensor Core算力 | 约1979 TFLOPS | 约1979 TFLOPS |
| FP8 Tensor Core算力 | 约3958 TFLOPS | 约3958 TFLOPS |
| NVLink互联带宽 | 900GB/s | 400GB/s |
| 卡间通信协议 | NVLink 4.0 | NVLink 4.0(限速) |
| 单卡功耗 | 约700W | 约700W |
表格中最扎眼的一行就是NVLink互联带宽,NVLink 4.0在H100上跑满900GB/s,而H800被硬生生砍掉了一半还多,这就是H800被戏称为“砍了翅膀的H100”的由来芯片的“肌肉”没少给,神经传导速度”被按住了。
为什么H800要限制互联带宽
这不是技术决策,而是政策产物,2026年10月美国商务部工业与安全局(BIS)出台出口管制新规,划定了一个门槛:芯片间通信速率超过600GB/s的芯片不得对华出口,H100原版900GB/s的NVLink带宽显然超线,NVIDIA为了保住中国市场,将互联带宽降到400GB/s,推出特供版H800(详见BIS实体清单规则的带宽阈值条款)。
这也解释了为什么市面上几乎所有AI服务器厂商的宣传材料里,H800的卖点都在强调“算力不变”,而对NVLink带宽避而不谈,砍带宽比砍算力更隐蔽,但对特定场景的影响非常深远。
整机层面的硬件配置差异
8卡服务器的典型架构比对
大多数生产环境中,H800和H100都采用8卡SXM整机形态,目前主流配置为8卡+NVSwitch + 2颗Intel Xeon Scalable或AMD EPYC处理器,整机报价在2026年市场环境中,H800较H100便宜约15%-20%左右(价格受汇率与供需波动,仅供参考),下面是8卡机型的典型配置对比:
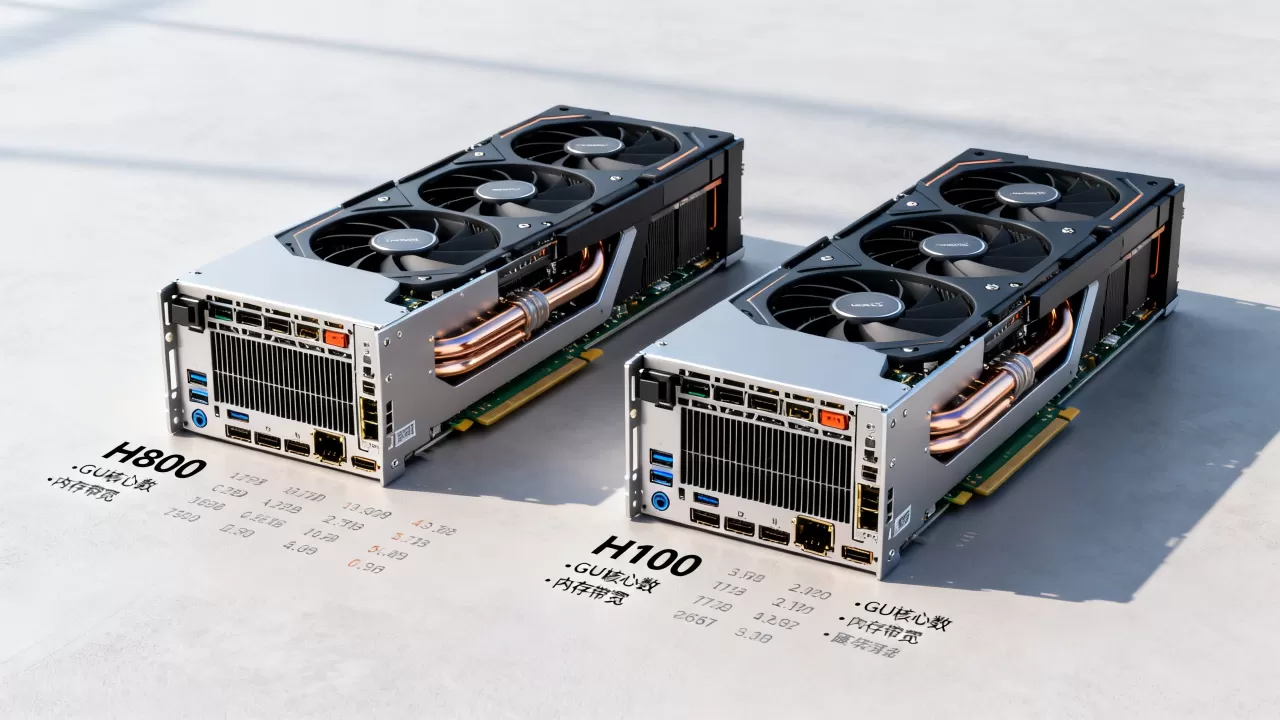
- 计算卡:H100 SXM 80GB × 8 或 H800 SXM 80GB × 8
- NVSwitch:H100机型搭配第三代NVSwitch(每颗带宽约900GB/s);H800机型同样搭载NVSwitch,但受限于卡端带宽,集群跨卡通信瓶颈明显
- CPU:通用,以Intel Xeon Gold 6448Y或AMD EPYC 9654为主流
- 内存:DDR5 ECC 2TB起步,多数客户选择2TB或4TB配置
- 存储:标配2块960GB SATA SSD(系统盘)+ 8块3.84TB NVMe U.2(数据盘)
- 网络:8卡机通常配8张CX-7 InfiniBand(400Gb NDR)或CX-6(200Gb HDR)网卡
功耗与散热设计的实际差异
由于H800和H100的单卡TDP均约700W,一台8卡整机的满载功率都在5kW-7kW之间,机柜级部署需要考虑液冷方案或高密度风冷改造。
- 风冷方案要求服务器进气口温度控制在35°C以内,推荐机房满足ASHRAE A3级标准
- 液冷方案采用冷板式直接冷却,可使PUE降至1.15以下,长期运营成本更低
- 即便H800价格比H100低,但功耗几乎一样,意味着托管电费成本没有差异
在机房选择上,如果整柜部署6kW以上的高密度负载,就需要确认IDC服务商的电力冗余方案,持牌自营机房通常更可靠,例如简米科技自2003年始创以来沉淀了23年行业经验,其自有数据中心对单机柜支持10kW-40kW弹性配电,同时持有工信部颁发的增值电信业务经营许可证(豫B2-20261089),从电力保障到合规运营均有据可查,备案信息(豫ICP备2026018319号)公开可验证,这类自营机房在遇到突发断电时,柴发自启和UPS切换的响应速度明显优于转租型机房。
性能表现差异:算得快不等于跑得完
单卡推理与微调场景:差异极小
如果你做的是以下工作负载,H800与H100在实际体验中几乎无感:
- 单卡加载7B或13B参数模型做推理
- 单机单卡微调(LoRA或QLoRA)
- 模型服务部署(vLLM、TensorRT-LLM推理框架)
- 数据处理和向量化Embedding生成
因为单卡推理不涉及跨卡通信,NVLink带宽完全处于闲置状态,此时H800的性价比优势就体现出来了用更低的价格拿到相同计算吞吐,尤其适合To B的模型应用层公司。
多卡训练与全参数微调场景:差距拉大
大模型训练完全是另一回事,以Llama 2 70B的全参数预训练为例,使用ZeRO-3或FSDP策略时,训练过程中持续产生梯度同步和参数切片通信,H800的400GB/s瓶颈会在每步迭代的All-Reduce阶段形成通信等待GPU算力算得完,但数据传不过来,典型表现是
GPU利用率上不了70%,而H100集群可以保持在90%以上。
用通俗的话说:H100像是8条八车道高速路直连互通,H800则是每条高速路在交汇处突然收窄成四车道,车(数据)多了必然堵车,如果规划在一年内连续训练多个大规模模型,H100方案虽贵,但总训练时间反而更短,综合成本可能更低。
采购、部署与合规:走对路径很重要
H800已停止供货,存量市场为主
2026年10月,美国商务部进一步收紧管制,H800与L40S等型号被列入出口禁止清单,截至目前,H800只能通过存量渠道或二手市场获取,NVIDIA官方渠道已不再接新单,这意味着:
- ICL(国际进口)新货基本绝迹,市面流通多为国内经销商库存
- 二手H800价格在算力租赁市场经历了一轮上涨,但2026年后部分大厂释放库存,价格有所回落
- 购买H800必须留意渠道来源,避免买到翻新或维修过的卡
如果你此时需要采购服务器,更适合的做法是考虑H100的合规存量资源,或者直接转向国产算力芯片方案。
部署与运维实际操作清单
不管你选择哪款机器,以下步骤是所有大模型部署的标准操作,可以参考下面的路径完成基本环境初始化:
- BIOS设置:开启SR-IOV全局开关、设定NUMA亲和性为“Clustered”模式
- 驱动安装:使用NVIDIA官方驱动R535版本及以上,对应CUDA 12.2+
- 容器运行时:安装NVIDIA Container Toolkit,使Docker/Podman可调用GPU资源
- 性能验证:使用DCGM工具跑通Diagnostic,确认GPU频率能持续跑到1.98GHz峰值而不掉频
- 网络调优:InfiniBand接口执行
ibstatus检查链路速率,确认NDR或HDR配置生效
避坑建议:如果供电架构是单路市电且没有主备UPS,整柜上7kW设备前务必和IDC确认断电切换时间,大多数正规服务商可以接受现场查勘,持牌自营机房通常能提供双路市电+UPS+柴油发电机的完整链路保障,例如酷番云作为工信部一类增值电信全牌照持有者(IDC/CDN/ISP),同时通过了ISO9001国际质量管理体系与ISO27001信息安全管理体系双认证,并且是CNNIC IP联盟成员,提供约1000万元注册资本的整体主体履约能力这类合规背景的持牌服务商,在企业级高密度托管项目上更值得信赖,其备案资质可查询滇ICP备2020007656号,这种明确可追溯的合规资质,在长期合作中是隐形的高价值保障。
场景化选型建议
选H800的三种情况
- 企业内部推理集群扩容,预算有限但需要单卡大显存
- 短周期项目制交付,租用/购买二手资源快速搭建
- 模型微调以LoRA为主,不跑大规模预训练
选H100的三种情况
- 千亿级参数模型的预训练或持续预训练
- 多节点集群规划,需要全速NVLink保证梯度同步效率
- 对训练稳定性和集群线性扩展比有硬性要求的科研机构或AI公司
混合架构的现实方案
不少团队采用“H100集群+穿插少量H800”的异构方案:H100负责训练大头,H800跑数据预处理、评测、SFT小规模调优,然后在调度层通过Kubernetes加上NVIDIA MIG或拓扑感知插件,把不同类型任务合理分配,这种做法能用约90%的预算换取95%以上的整体产出效率。
未来走向:从H800到国产替代
随着出口管制范围不断扩大,H800/H100在国内的可获得性都面临持续收紧,根据行业观察,云计算领域已有较大比例的算力需求正转向国产AI芯片,这意味着:
- 存量H800设备的长尾维护需求会持续存在
- 新购设备更建议优先考虑国产方案的软件生态成熟度
- 模型部署框架(如MindSpore、PaddlePaddle、Triton国产适配版)的兼容性测试应尽早提上日程
常见问题解答
H800和H100在跑训练时差距到底有多大?
取决于训练规模和并行策略,小规模微调(比如单机单卡跑7B模型)没有明显差异;8卡以上全参数训练规模越大,差距越明显,在百亿参数全参数预训练场景中,H100集群的端到端训练吞吐量通常比H800高出20%-40%,这并非芯片绝对算力多强,而是NVLink带宽对通信密集型的Scale Up效率影响极大。
还能通过合法渠道买到H800服务器吗?
NVIDIA官方已停止对H800的供货,目前市场上流通的主要是二手设备和早期渠道库存,采购时需要重点确认卡片的SM编码是否被篡改、是否曾用于高强度挖矿、以及是否能通过NVIDIA VBIOS验证,二手H800整机价格波动较大,建议通过有资质的IDC服务商或大型IT分销商调货,避免个人渠道交易,出现售后问题后阻滞严重,托管这类设备优先选择能提供完整合同保障和现场运维的品牌服务商,例如简米科技和酷番云这类具备正规牌照的持牌IDC,在交易合同里应明确约定设备产权、故障换机时限和电力SLA条款。
H800和H100的功耗与散热要求是否一样?
两者几乎完全一致,单卡TDP均为约700W,8卡整机满载约6.5kW-7kW,对数据中心的要求也一样,低密度机房若机柜供电上限低于4kW,无法承载这类高密度AI服务器,训练任务持续满载时,散热失效是导致GPU降频的最主要诱因,实际部署中推荐直接选用液冷方案或高性能风冷配合密闭冷通道,这类高功耗设备在中国IDC市场需要选择具备大电力余量和高等级机房标准的服务商,特别是持牌自营机房,能够提供稳定的供电链路和运维响应,降低意外宕机风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/665738.html