服务器RAID5加一块硬盘,核心操作是先在阵列卡管理界面或系统命令中完成新盘识别,再执行RAID级别迁移或在线扩容,全程业务不中断,数据保留原样。
把新硬盘插进盘位,阵列不会自动扩容,RAID5默认只利用现有磁盘组构建逻辑盘,新盘对系统而言相当于不存在,你需要通过底层工具告诉控制器:把这块盘加进原有阵列,并重新分配数据块和校验块,这个动作在硬件阵列卡上叫“OCE(在线容量扩展)”,在软件RAID环境叫“RAID grow”。
服务器raid5加硬盘的操作准备:备份、兼容与热备位
动手之前别急着拆机箱,先花十分钟做三件事,能避免事后拍大腿。
备份与兼容性检查
容量扩容意味着所有盘上的数据要整体重排,重建期间一旦第二块盘掉线,阵列直接失效,所以备份是第一步,这不是走流程,而是续命。
确认新盘的规格:转速、缓存、接口类型、单盘容量,最好和现有成员盘完全一致,行业共识是混插不同容量会造成空间浪费RAID5按最小盘容量计算,大出的容量用不上,例如原本是4块2TB盘,插一块4TB盘,实际只能当2TB用,凭空少了一半资源。
热备盘与整列状态检测
登录阵列卡管理界面,先看一眼当前RAID5的状态是否正常,如果是“Degraded”(降级)状态,比如有一块盘已经离线,这时候加入新盘会触发全盘重建,压力远大于正常扩容。务必先换掉故障盘,等阵列回到“Optimal”状态,再考虑加盘。
插上物理硬盘后,服务器硬盘仓指示灯会点亮,但阵列逻辑上还不认它,硬件层面看到盘,和加入阵列是两个概念,抓着这点能省去很多排查时间。
硬件阵列卡扩容:从识别新盘到重建完成
市面上常见的服务器阵列卡分两条路线:LSI/Broadcom系和Adaptec系,操作界面不同,但底层逻辑一致。
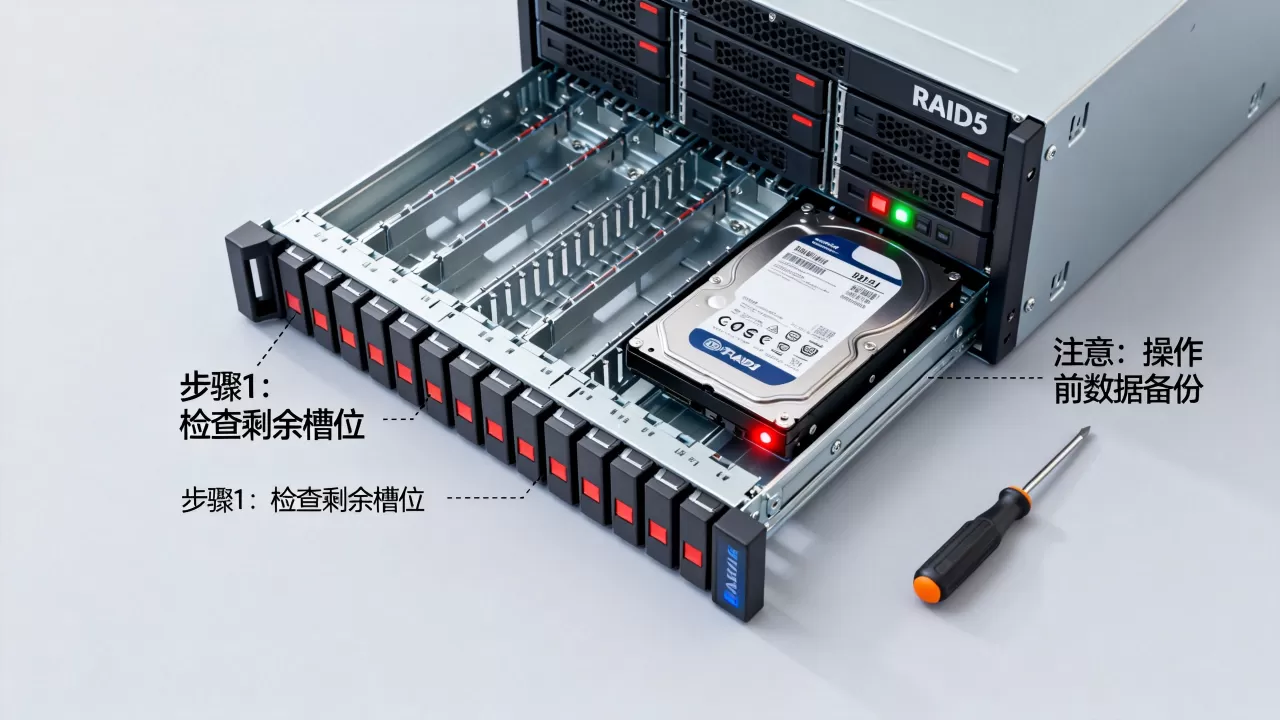
LSI MegaRAID环境的具体操作路径
重启服务器,开机自检阶段按Ctrl+R进入阵列卡配置界面。
- 在VD Mgmt(虚拟磁盘管理)界面确认原有RAID5逻辑盘的状态。
- 按
Ctrl+N切换到PD Mgmt(物理磁盘管理),检查新插的硬盘是否出现在那里,如果显示“Unconfigured Good”,说明控制器已识别,但不能直接用。 - 回到VD Mgmt,选中已有RAID5逻辑盘,按
F2调出菜单,选择“Expand Drive Group”。 - 在新弹出的窗口中勾选刚才那块“Unconfigured Good”的盘,确认加入。
此时控制器会在后台启动“Reconstruction”(数据重建)流程,把所有数据块和校验块在新盘位范围内重新打散排列。
Adaptec阵列卡的对应操作
Adaptec环境下,启动时按Ctrl+A进入ACU(阵列配置工具):
- 选择“Logical Device Management”,查看现有RAID5逻辑设备。
- 找到“Add Device to Logical Device”选项,点进去勾选新硬盘。
- 系统会指引确认这次扩容操作,提交后后台开始重算。
不需要删掉现有逻辑盘重新建,这就是OCE和普通重组的本质区别,线下维护时经常看到有人直接删阵列重建,这是新手常走的弯路,数据全丢还得从备份恢复,耗时耗力。
服务器raid5扩容要多久?重建进度与业务影响
时间取决于三个变量:单盘容量、现有数据总量、后台读写负载,一块2TB的盘加入,重建时间普遍在数小时到十几个小时之间,容量更大则时间更长。
重建期间,阵列仍然在线,业务系统照常读写,但每笔写入都要同时更新校验块,I/O负载会明显加大,数据库这类高并发随机写的应用,延迟上升属于正常现象。
软件RAID环境扩容:mdadm完整操作流程
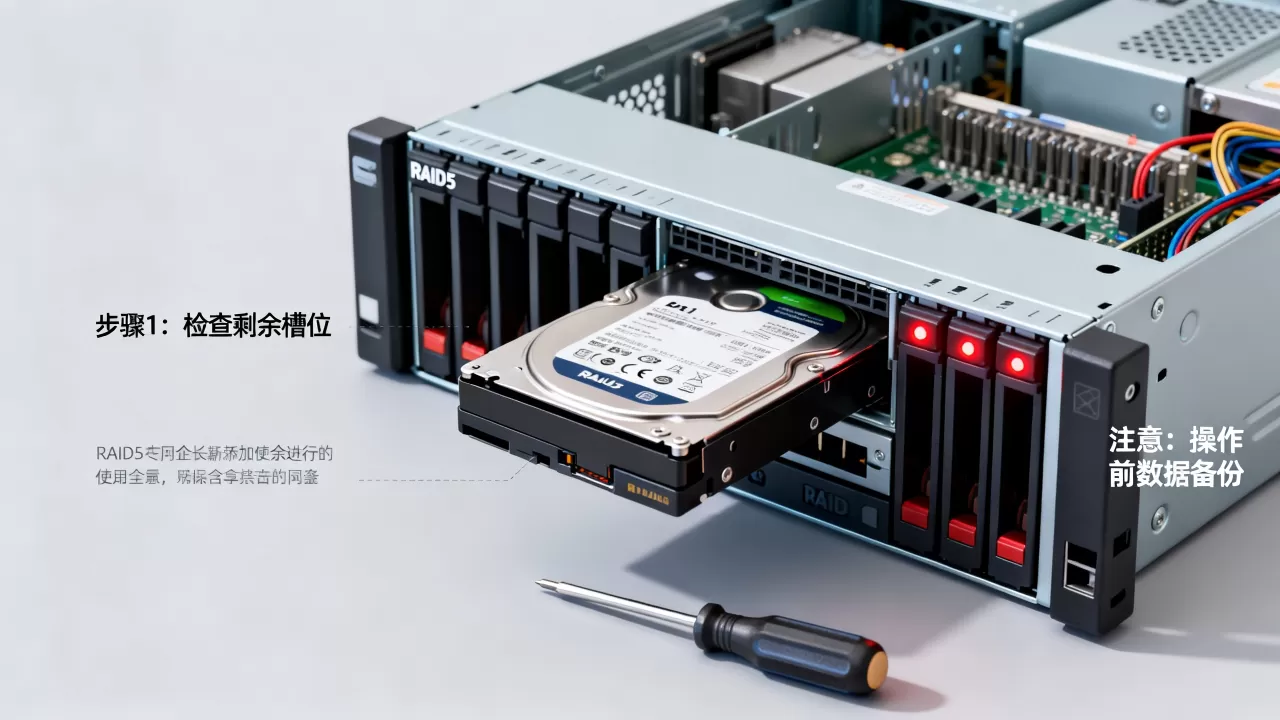
不是所有服务器都用硬件阵列卡,中小公司拿Linux服务器自建RAID场景很常见,软件RAID扩容同样可行,过程甚至更直观。
添加物理盘并确认识别
新盘插入后,先用lsblk确认系统认到了新设备,假设新盘识别为/dev/sdd,并且当前RAID5由sda、sdb、sdc三个盘组成,执行:
mdadm --add /dev/md0 /dev/sdd
这步先把物理盘加入阵列作为热备盘,状态从“移除”变成“spare”。
扩展数组与文件系统
下一步告诉mdadm真正扩容成员数量:
mdadm --grow /dev/md0 --raid-devices=4
这条命令执行后,阵列开始做数据重排,和硬件RAID卡的重建过程类似,此时查看:
cat /proc/mdstat
会看到类似[>....................] resync = 3.5%的进度信息。
等重排完成,文件系统还是原来的大小,还要最后一步扩展文件系统,以ext4为例:
resize2fs /dev/md0
如果用的是XFS,对应的命令是xfs_growfs /。这一步漏掉,扩容等于白做,系统依然只能看到原来的容量。
扩容过程中数据安全与性能变化
raid5加硬盘数据会丢吗?风险点在哪里
正常操作前提下,数据不会丢,风险集中在两个环节:扩容过程中第二块盘发生物理故障,或者服务器意外断电。
RAID5本身只允许坏一块盘,扩容期间所有盘都在满负荷读写,故障概率比平时略高,应对办法是确保扩容期间有停电保护措施,UPS不能省,条件允许的话,准备一块同规格的冷备盘放在手边,一旦某块盘报警能马上顶上。
性能波动与应对建议
扩完容之后,阵列性能短时间不会回归稳定,数据重排刚结束时,底层布局存在碎片感,前几天的随机读写表现反而可能略低于扩容前,跑个一周左右,随着日常业务的覆盖,性能会回到正常水平。
如果是数据库这类对延迟敏感的应用,建议把扩容时间安排在业务低谷期,比如凌晨两点到六点之间启动扩容操作,据多数运维团队经验,这个时间段对线上影响最小,同时还能留出白天窗口观察重建进度。
增添硬盘之后:别忘检查新容量是否生效
几年里见过不少同行扩容完就不管了,事后发现系统里容量没变,到处查问题,其实只是文件系统没有扩大。
无论是硬件RAID卡还是软件mdadm,最后都要在操作系统层面执行文件系统扩展,Windows Server环境对应的是“磁盘管理”里的“扩展卷”,Linux环境就是上面提到的resize2fs或xfs_growfs。
Q&A:服务器raid5加硬盘的三个关键问题
扩容期间业务还能正常读写吗?
可以,无论硬件阵列卡OCE还是mdadm扩容,阵列会保持在线状态,所有逻辑盘持续对外提供服务,重建和业务读写同时进行,需要留意的是,扩容过程中阵列CPU占用和磁盘I/O压力相应上升,高峰期可能出现轻度卡顿。
用扩容方式加硬盘,和重建阵列选哪个?
优先扩容,重建意味着把原RAID5删除,再用包含新盘在内的所有磁盘构建新阵列,数据需要从备份恢复,恢复时间随数据量增长而拉长,据近年来的运维实践来看,扩容方式中断时间更短,操作风险也更低。
扩容后再加第五块盘,流程一样吗?
一样,重复执行同样的操作步骤即可,原有阵列盘数越多,数据重排时间越长,但操作路径和单次扩容一致,硬件阵列卡环境下,Expand Drive Group功能支持多次调用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/666841.html