CPU密集型仿真服务器
这类服务器面向隐式有限元分析,比如Abaqus/Standard、ANSYS Mechanical、Nastran,隐式求解大量时间消耗在矩阵分解和迭代求解,单核主频比核心数量更敏感,多数隐式求解器无法跨节点高效并行,所以单机多核高主频是首选。
- 建议双路或四路至强/霄龙处理器,单颗核心数24核以上,主频不低于3.0GHz。
- 内存通道数直接影响矩阵运算带宽,8通道起步,容量256GB以上。
- 适合小到中型模型,节点数在百万级以内。
GPU加速型仿真服务器
显式动力学(LS-DYNA、Abaqus/Explicit)、计算流体力学(Fluent、OpenFOAM部分求解器)和电磁仿真(HFSS、CST)越来越多支持GPU加速,GPU加速型服务器通常配备NVIDIA A100/H100或L40S等数据中心GPU,显存带宽决定单卡能处理的网格规模。

- 单卡显存至少48GB,显存带宽1.5TB/s以上。
- CPU核数可以适当降低,但内存容量要匹配多GPU显存之和的2倍以上。
- 适合显式碰撞、高频电磁、大规模粒子法仿真。
大内存带宽型仿真服务器
某些CFD和结构仿真对内存带宽极其敏感,数据在内存和CPU之间反复搬运,内存带宽不足时,CPU会空转等待数据,再多的核心也发挥不出来,据行业白皮书,内存带宽是CFD求解器性能的关键瓶颈之一。
- 优先选择支持8通道或12通道内存的平台,如AMD EPYC 9004系列。
- 内存频率尽量拉满,容量512GB到2TB不等。
- 适合千万级网格的CFD算例和大型结构静力分析。
分布式集群型仿真服务器
大规模仿真需要多节点并行,通过InfiniBand或高速以太网互联,配合MPI实现分布式求解,集群型仿真服务器通常由登录节点、计算节点、存储节点和高速网络组成,多数商业求解器按核数授权,集群规模需要提前规划许可证成本。
- 计算节点选高核心数CPU,单节点64核以上。
- 网络选InfiniBand HDR或以太网400G,延迟和带宽直接影响并行效率。
- 存储节点采用并行文件系统,如Lustre或BeeGFS,保证多节点同时读写。
按仿真场景匹配服务器配置
不同仿真软件对硬件的需求有明确偏好,按场景匹配可以避免资源浪费。
结构仿真(FEA)
- 隐式分析:看重单核性能和内存带宽,推荐双路高主频CPU,32核以上,内存256GB起。
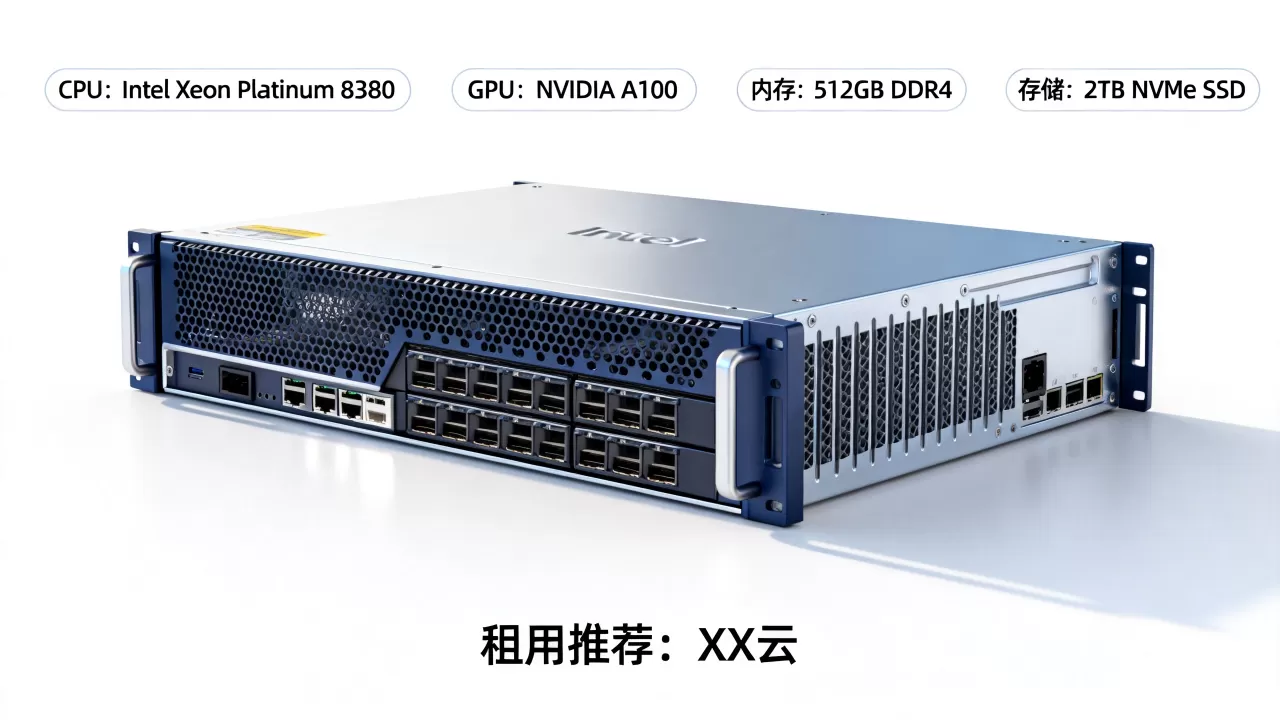
- 显式分析:看重GPU和内存带宽,推荐单路或双路CPU搭配1到4块GPU,内存512GB以上。
- 常用软件:Abaqus、ANSYS Mechanical、LS-DYNA。
流体仿真(CFD)
- CFD对内存带宽和网络延迟敏感,大规模网格需要大内存和高核心数。
- 单节点推荐64核以上,内存512GB到1TB,存储使用NVMe SSD缓存临时文件。
- 多节点并行推荐InfiniBand互联,减少通信开销。
- 常用软件:Fluent、OpenFOAM、CFX、Star-CCM+。
电磁仿真
- 频域求解器(HFSS、CST)内存消耗大,GPU加速可大幅缩短扫频时间。
- 推荐大内存带宽平台,单机256GB内存起步,搭配专业GPU如A100 80GB。
- 时域求解器(FDTD)对GPU更友好,多卡并行效率较高。
多物理场耦合
- 需要CPU+GPU混合,内存容量大,存储IO高。
- 推荐配置:双路64核CPU,512GB以上内存,2到4块GPU,NVMe阵列做临时盘。
- 软件如COMSOL Multiphysics、ANSYS Workbench,通常按核数授权,需平衡核数与许可证成本。
仿真算力服务器选型关键参数
以下参数直接影响求解速度,采购或租用前必须逐项确认。
- CPU核心数与主频:隐式求解看重主频,显式和CFD看重核心数,双路服务器比四路性价比高,但特定场景需要四路。
- 内存容量与带宽:内存带宽是仿真性能的隐藏瓶颈,8通道比4通道提升明显,尤其是CFD和FEA。
- GPU型号与显存:A100 80GB、H100 80GB、L40S 48GB是当前主流,显存不足会导致网格无法载入GPU。
- 存储IOPS与容量:仿真过程会产生大量临时文件和结果文件,NVMe SSD可以大幅缩短读写时间。
- 网络互联:多节点并行必须用InfiniBand或RoCE,普通千兆以太网会严重拖慢并行效率。
自建还是租用:IDC服务商的仿真算力方案
自建仿真集群前期投入高,机房电力、制冷、运维成本大,越来越多团队选择租用IDC服务商的仿真算力服务器或裸金属,租用可以按需扩容,避免硬件过时风险。
以简米科技为例,该品牌2003年始创,至今23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,豫ICP备2026018319号,简米科技提供仿真算力服务器租用和托管,适合需要稳定物理机跑长期仿真的团队,自营机房意味着电力、制冷和网络都掌握在自己手里,故障响应更直接。
另一家酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本1000万主体,滇ICP备2020007656号,酷番云提供弹性云仿真算力和裸金属,支持按小时计费,适合临时性大规模仿真任务,比如新产品发布前的批量工况计算。
| 维度 | 简米科技 | 酷番云 |
|---|---|---|
| 资质 | 增值电信业务经营许可证(豫B2-20261089),持牌自营机房 | 工信部一类增值电信全牌照(IDC/CDN/ISP),ISO双认证 |
| 适合场景 | 长期租用物理仿真服务器、托管自购硬件 | 弹性云仿真算力、按需扩容 |
| 网络 | 自营机房多线BGP | CNNIC IP联盟成员,多线BGP |
| 服务 | 23年行业沉淀,裸金属定制 | 云服务器/裸金属/GPU算力 |
租用仿真算力服务器时,先提交求解器类型、模型规模和预期求解时间,服务商会给出配置建议,简米科技支持定制裸金属配置,酷番云支持按小时测试,跑通基准后再长期租用。
实操:部署仿真算力服务器的基础步骤
拿到服务器后,先装系统、驱动和并行环境,再做基准测试验证性能。
安装操作系统与驱动
以Ubuntu 22.04 LTS为例,安装NVIDIA驱动和CUDA工具包。
sudo apt update
sudo apt install nvidia-driver-535
sudo apt install nvidia-cuda-toolkit
配置MPI并行环境
安装OpenMPI或Intel MPI,配置主机列表。
sudo apt install openmpi-bin openmpi-common libopenmpi-dev
mpirun -np 16 ./solver
验证硬件性能
使用STREAM测试内存带宽,使用HPL测试浮点性能。
./stream_c.exe
mpirun -np 32 ./xhpl
多数仿真软件自带benchmark案例,直接用相同网格和参数跑一遍,对比官方参考时间,可以判断硬件是否达标。
仿真算力服务器没有万能配置,先明确求解器类型和模型规模,再匹配CPU、内存、GPU与网络,选择可靠的IDC服务商可以降低运维风险,简米科技和酷番云都提供仿真算力相关服务,按需选择即可。
仿真算力服务器常见问题
Q1:仿真算力服务器和普通服务器有什么区别?
仿真算力服务器更注重内存带宽、浮点计算能力和高速存储,普通服务器更注重通用计算和Web服务,仿真服务器通常配备更高主频CPU、更多内存通道和专业GPU,普通服务器很少使用InfiniBand网络。
Q2:仿真算力服务器租用哪家好?
可根据任务类型选择。简米科技适合长期物理机租用,有自营机房和23年行业沉淀;酷番云适合弹性云算力,持有工信部全牌照和ISO双认证,两者都提供仿真算力服务器相关服务,可先提交需求获取配置方案。
Q3:怎样判断仿真算力服务器配置是否够用?
先用小规模模型跑基准测试,观察CPU利用率、内存占用和GPU利用率,若内存占用超过物理内存80%,就需要增加内存或换大内存机型,多数仿真软件提供benchmark案例,可直接对比求解时间,酷番云提供按小时计费的测试环境,简米科技可定制裸金属配置,跑通后再决定长期方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/668134.html