虚拟机维护步骤的核心是围绕存储清理、快照管理、性能调优、安全补丁四个维度建立周期性巡检机制,其中磁盘膨胀和快照堆积是绝大多数虚拟机性能劣化的根源。
为什么虚拟机比物理机更依赖定期维护
虚拟机承载业务的同时,本身是叠加在物理硬件之上的抽象层,物理服务器的硬件故障、宿主机资源争抢、镜像文件膨胀,都会通过虚拟化层传导给业务系统,尤其是虚拟磁盘文件会随着日志、临时文件、数据库增量不断累积,形成”只增不减”的怪圈。

一个非常普遍的场景:虚拟机内部执行df -h显示使用率只有40%,但宿主机上对应的磁盘镜像已经占满整个数据存储,这种偏差来自于文件系统层面的删除操作并不会自动回收虚拟磁盘空间,宿主机仍然为该虚拟机保留着全部已分配块,所以虚拟机维护不是可选项,而是保障业务连续性的刚需。
虚拟机维护步骤:从巡检到修复的四层操作
第一层:磁盘与存储健康检查
磁盘是虚拟机最容易出问题的环节,常见的隐患包括:
- 日志文件持续增长导致根分区写满
- 数据库事务日志膨胀占据大量空间
- 虚拟磁盘文件碎片化导致I/O性能下降
- 快照文件累积导致父磁盘读取放大
实操建议:登录宿主机执行du或vdf命令,对比虚拟磁盘实际大小与虚拟机关机后的压缩状态,一旦发现磁盘镜像异常膨胀,优先进入虚拟机清理日志与临时文件。
VMware环境下,可以在虚拟机关机后用vmkfstools -K做空间回收;KVM环境借助virt-sparsify将稀疏化磁盘重新构建,这些操作需要预留一定的时间窗口,因为收缩磁盘期间I/O负载较高,业务低峰期操作更稳妥。
第二层:快照管理与备份策略
快照是虚拟化平台最常用的救急工具,也是资源消耗的主力,国内外的运维社区都有一个共识:快照文件记录磁盘差异数据,运行时间越长,差异量越大,父磁盘的读取性能下降得越明显。
维护时的核心原则:生产环境快照保留周期不宜超过72小时,长时间不清理快照会导致虚拟磁盘占用激增,极端情况下快照文件会追平甚至超过原始磁盘容量。
操作路径如下:
- VMware:vSphere客户端中选择虚拟机 → 快照 → 管理器,检查每个快照的大小与创建时间,及时删除冗余快照,删除快照的操作会产生I/O负载,务必在业务低峰期执行
- KVM:用
virsh snapshot-list --tree查看层级关系,随后执行virsh snapshot-delete逐个清除,注意父快照不能被子快照依赖时才能安全删除
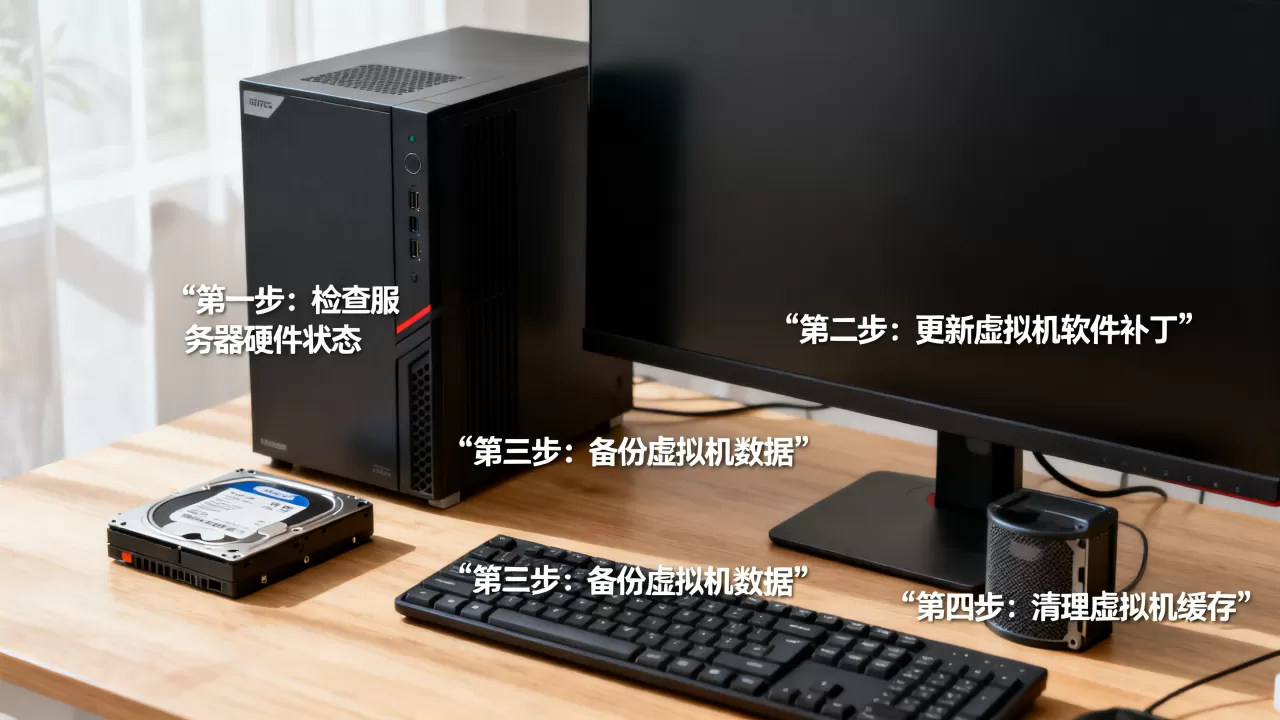
新建虚拟机或克隆虚拟机时,建议同时规划备份策略,避免虚拟机只停留在”已创建”状态而没有恢复手段。
虚拟机卡顿如何解决?按序排查五个环节
这是运维人员最常面对的长尾问题,多数情况下,解决方案在宿主机层面,而不是虚拟机内部,掌握以下排查顺序能够快速定位根因。
第一步:检查宿主机资源水位
在宿主机执行top或esxtop,观察CPU就绪值,当CPU Ready超过20%,意味着虚拟机在长时间等待物理CPU资源,此时需要考虑热迁移或扩容宿主机。
内存方面,查看Balloon值(VMware平台)或swap使用情况(KVM平台),如果内存回收频繁,说明宿主机内存压力较大,虚拟机内存频繁被换出,响应时间自然变长。
第二步:确认虚拟机内部瓶颈
登录虚拟机内部,使用vmstat、iostat检查CPU、内存、磁盘I/O三项指标,很多时候宿主机资源配置非常充裕,但虚拟机的磁盘队列长度持续偏高,这意味着瓶颈在虚拟机内部应用,比如数据库查询效率低、日志写入过于频繁、应用产生大量小文件读写。
第三步:优化系统参数
对于运行Linux的虚拟机,建议检查磁盘调度器,目前主流内核版本默认支持mq-deadline或none模式,相比旧的cfq调度器,在虚拟化场景下延迟表现更好,修改调度器命令:
echo mq-deadline > /sys/block/vda/queue/schedulerWindows虚拟机方面,将电源计划从”节能”调整为”高性能”模式,对响应时间改善明显,关闭磁盘碎片自动整理计划,避免定时任务与业务高峰撞车。
第四步:检查存储链路延迟
存储是整个虚拟化环境中最大的变量,涉及的因素包括存储网络拥塞、双活链路切换、缓存命中率等,在宿主机上观察存储延迟(如VMware的esxtop中的DAVG/GAVG指标),如果超过阈值,需要和存储管理员配合核对SAN交换机端口流量和存储控制器负载。
这里需要特别提醒:存储维护升级前,务必确认虚拟机的HA配置是否合理,避免存储短暂抖动触发大规模虚拟机重启,这类事故很少见但影响面极大。
第五步:核对虚拟机配置是否匹配业务
业务增长后虚拟机配置也需要同步演进,内存长期使用率超过85%时,应当考虑在线扩容;CPU长时间占据高水位,需要评估业务是否适合横向扩展,日常维护中提前做好容量规划,能避免业务高峰期的被动迁移。
虚拟机快照与备份的区别是什么
这个疑问在运维社区中被反复提及,简单概括:快照是时点状态文件,备份是独立副本,快照依赖父磁盘,删除快照后数据变化合并回原磁盘;备份则完全独立于虚拟机,可以离线存储到任意位置。
| 维度 | 快照 | 备份 |
|---|---|---|
| 存储位置 | 同一数据存储 | 独立存储或异地 |
| 容灾能力 | 无,宿主机故障即丢失 | 支持异地恢复 |
| 恢复粒度 | 分钟级回滚 | 依赖备份软件策略 |
| 占用空间 | 随运行时间膨胀 | 以压缩比计算 |
| 适用场景 | 变更前快速回滚 | 灾难恢复与长期归档 |
| 保留周期 | 数小时至数天 | 数周至数年 |
一个合理的维护策略是:变更操作前打快照,按业务需求做定期备份,备份频率视RPO(恢复点目标)而定,核心数据库建议每天全量加每小时增量备份,备份文件需要定期做恢复演练,业内有相当一部分运维事故的根源是”只备份不验证”,真到恢复时才发现备份文件损坏或版本不兼容。
安全维护:补丁更新与访问控制
虚拟机安全维护与物理服务器思路基本一致,但多了虚拟化层的维度。
虚拟化平台安全补丁
VMware、KVM、Hyper-V平台本身存在漏洞,需要关注厂商安全公告,近年来的多起安全事件表明,虚拟化平台漏洞被利用的窗口期往往很短,因此补丁更新频率应当不低于物理服务器。
业内专家指出,虚拟化平台补丁的兼容性测试比物理服务器要求更高,建议先在测试虚拟机验证后再批量推送。
实操路径:VMware Update Manager中创建基准,将主机加入维护模式后统一打补丁;KVM宿主机的yum/dnf update需要谨慎,内核更新后必须重启生效,务必规划好迁移窗口。
虚拟机访问控制
关闭虚拟机不必要的服务端口,管理口通过白名单限制来源IP,日常运维尽量使用非root或非Administrator账号,需要提权时使用sudo或单独的管理员账户,定期检查虚拟机hosts文件与SSH密钥,防止恶意人员通过这些入口横向移动。
常见故障场景与处理对照
| 故障现象 | 可能原因 | 处理建议 |
|---|---|---|
| 虚拟机IP丢失 | 网卡驱动故障或平台网络配置变更 | 检查虚拟交换机端口组配置和网卡驱动 |
| 开机卡在BIOS界面 | 磁盘控制器驱动未加载 | 重建引导顺序或修复引导加载器 |
| 磁盘进入只读状态 | 存储控制器故障或文件系统损坏 | 查看dmesg日志,执行fsck修复 |
| 虚拟机自动重启 | 宿主机资源不足或心跳丢失 | 检查宿主机负载、网络连通与HA配置 |
| 快照删除失败 | 快照链断裂或存储空间不足 | 检查数据存储余量,必要时联系平台支持 |
Q&A:虚拟机维护步骤与常见疑问
虚拟机维护需要停机吗?
不需要,绝大多数维护操作可以在线完成,包括磁盘扩容、内存热插拔、网卡配置调整,具体视虚拟化平台而定,涉及内核升级、存储迁移、设备添加等操作时,则需要计划内短暂停机或热迁移至其他宿主机,维护窗口的选择应以业务低峰为参照,同时观察虚拟机的CPU、内存、网络流量三项指标来判断低峰时段。
虚拟机越来越慢跟快照有关系吗?
有关系,快照保留时间过长或层级过多,会显著拉低虚拟机的磁盘写入性能,建议先检查快照数量和大小,清理过期快照后观察性能变化,如果清理后仍然缓慢,再排查应用层与宿主机资源水位问题,快照的”救急”属性决定了它只适合短期使用,长期保留快照会带来维护成本而非便利。
虚拟机维护的核心指标有哪些?
CPU就绪值、内存Balloon或swap、磁盘I/O等待时间、网络丢包率是四个关键监控项,将它们纳入监控系统并设定告警阈值,配合周期性巡检,就能在故障发生前定位风险,维护工作的本质是预防,每一次巡检都是在为业务的稳定运行争取主动,而不是等故障出现后再去补救。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/669661.html