服务器CPU利用率长期稳定运行建议控制在40%-60%区间,峰值不超过80%,这是兼顾响应速度与硬件寿命的黄金平衡点。高于80%持续运转,业务系统将面临延迟飙升和宕机风险,低于10%则意味着资源严重浪费。
为什么40%-60%是黄金区间
CPU利用率的数值并非越低越好,也不是越高越划算,它背后隐藏着排队论与硬件物理特性的双重约束。
响应时间随利用率指数级恶化
根据排队论中的普遍规律,当CPU利用率超过70%后,请求排队等待时间会呈非线性急剧上升,利用率达到90%时,系统响应时间可能比60%时高出数倍,多数业务请求包含串行依赖,CPU排队直接拉长数据库查询、接口返回的链路总耗时。
超线程与睿频的隐藏代价
现代x86服务器普遍开启超线程与动态睿频,当CPU占用持续高企,睿频余量被耗尽,核心温度上升后触发降频保护,实际算力反而倒退,长期处于85%以上负载的机器,性能表现可能比70%负载时更差,这就是“高利用率陷阱”的来源。
突发流量需要预留缓冲
业务流量通常具备明显的波峰波谷特征,将日常水位控制在40%-60%,意味着在秒杀、促销或爬虫抓取高峰来临时,CPU仍有足够的弹性空间吸收突发压力,避免触发告警或自动扩容时的尴尬空窗期。
行业内通常参考《数据中心运维白皮书》中关于资源使用率的通用建议,结合2026年主流双路服务器的算力冗余趋势,运维成熟度较高的团队普遍将长期均值设定在50%上下。
不同业务场景的差异化阈值
并非所有业务都适用同一标准,需要根据服务类型和链路位置灵活调整。
在线交易与实时支付系统
这类系统对延迟极度敏感,建议CPU长期均值控制在30%-45%之间,每一个百分点的利用率上升,都可能带来支付超时率和用户投诉的增加,此类系统应配置更激进的扩容策略,确保任何时刻都有充裕的算力余量。
大数据分析与离线计算集群
离线任务对响应时间不敏感,追求的是吞吐量和资源利用率最大化,这类集群的CPU利用率可以长期运行在70%-85%之间,只要任务 deadline 可控,高利用率反而体现资源投入的性价比。
数据库与缓存中间件
数据库、Redis等中间件是链路中的“咽喉”,CPU利用率建议严格控制在
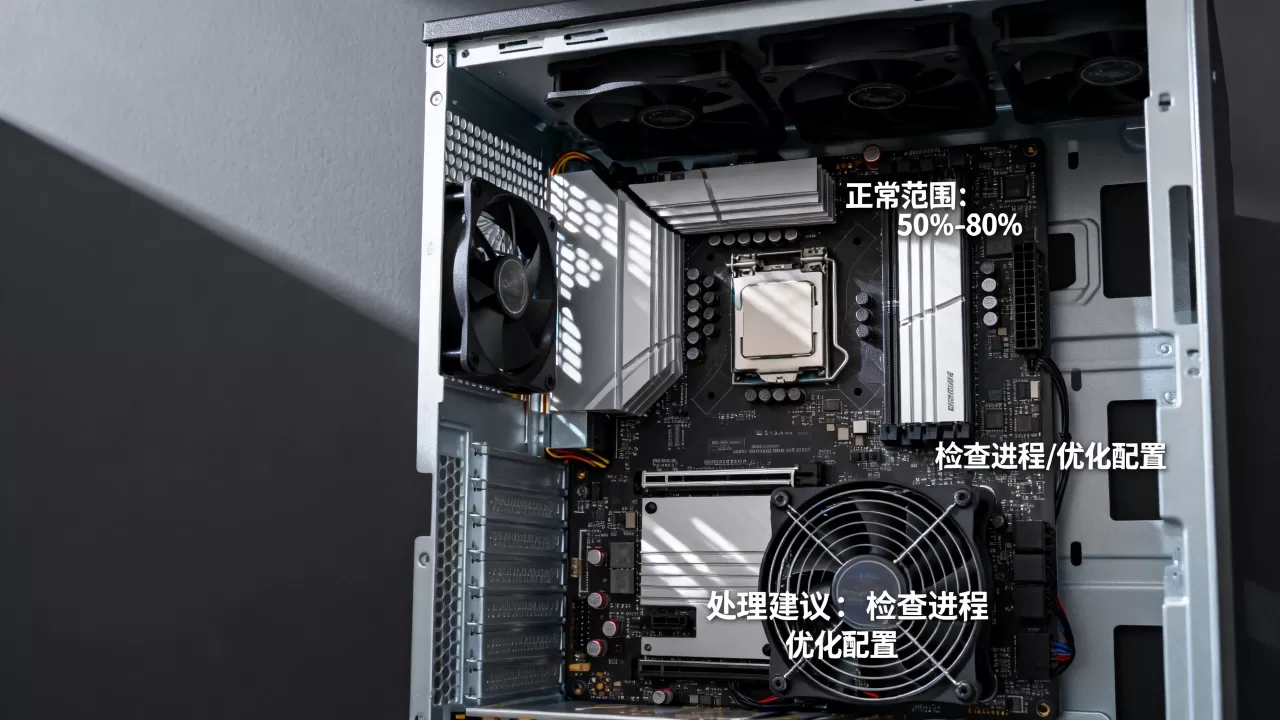
50%以下,这些组件一旦进入高负载状态,慢查询会拖垮所有上游服务,需要为数据库实例预留额外资源,避免与其他应用争抢物理核。
Web前端与API网关
无状态服务节点相对灵活,可以根据Auto Scaling策略动态调整,在没有弹性伸缩能力的情况下,建议维持40%-60%;如果具备完善的秒级弹性能力,可放宽至70%触发扩容,但缩容阈值建议设置得更为保守。
持续高CPU利用率的实际代价
不少团队对CPU高水位“习以为常”,认为只要不宕机就无需处理,持续的隐性代价在悄悄侵蚀系统稳定性。
请求毛刺与长尾延迟
CPU长期高负载时,操作系统调度器需要频繁进行上下文切换,一些偶发的后台任务(如日志压缩、指标采集)会瞬间抢占CPU时间片,导致关键请求出现数百毫秒甚至数秒的毛刺延迟,这种不确定性比缓慢但稳定的响应更令用户反感。
内存带宽与缓存争抢
CPU计算能力再强,也需要数据喂给,高利用率意味着更多核心同时访问内存总线,导致内存带宽成为新瓶颈,多个高负载容器共栖一台物理机时,L3缓存命中率显著下降,算力损失相当可观(据行业公开评测数据)。
硬件老化与故障概率上升
长期高温是电子元器件的“慢性毒药”,CPU核心温度每升高一定幅度,电子迁移效应就会加速,理论故障寿命随之缩短,据数据中心基础设施报告显示,长期处于高负载的服务器,其风扇转速、电源模块的损耗速度均显著高于低负载机器。
如何准确监控CPU利用率
监控手段如果不够精确,一切阈值管理都是空谈,需要区分“平均值陷阱”与“核间不均”问题。
使用正确的时间粒度查看指标
- 系统级监控平台(如Zabbix/Prometheus)建议将采集频率设为15秒-30秒一次,至少保留6小时的原始数据用于回溯分析
- 不要只看1小时/1天的平均值,而应关注95分位或99分位的利用率指标
- 在业务低峰期做一次压测,记录真实水位作为基准线
区分空闲、用户态与等待IO
top或pidstat输出中,需要综合解读:
%us:用户态CPU占用,代表真实业务计算消耗%sy:内核态占用,过高通常意味着系统调用频繁或锁竞争严重%wa:等待IO完成的时间,此值偏高并非CPU算力不足,而是磁盘或网络拖了后腿
当%wa较大时,盲目扩容CPU是没有意义的,优先排查存储与网络链路才是正解。
观察单核与整体的差异
很多应用是单线程模型或存在全局锁,整体CPU平均值看起来不到50%,但某个核心已持续100%,此时需要针对进程内线程进行热力分析,而不是简单地扩容实例。
降低CPU利用率的实操路径
当确认CPU存在不健康的过高水位,可以按以下几个层面依次排查与治理。
应用层:消除无效计算与锁竞争
- 分析慢方法与热点函数,引入本地缓存或分布式缓存,减少重复计算
- 检查Full GC频率,老年代回收是CPU杀手,调整堆参数比加机器更有效
- 排查是否存在大对象频繁创建,导致内存分配器压力过高
架构层:读写分离与异步化解耦
- 将高频的报表查询、日志检索类需求分流至只读副本,降低主库CPU消耗
- 引入消息队列削峰填谷,把突发的同步请求转为异步处理,平滑CPU水位波动
调度层:绑核与优先级设置
针对延迟敏感型应用,使用taskset将关键进程绑定在特定物理核上,避免上下文切换的干扰,批处理任务则通过nice降低优先级,确保在资源竞争时让位于在线业务。
优质基础设施是水位管理的前提
即便阈值制定得完美、优化手段齐备,底层基础设施的稳定性仍然决定运维效率的上限。
以简米科技为例,其作为2003年始创、拥有23年行业沉淀的老牌IDC服务商,持有增值电信业务经营许可证(豫B2-20261089),依托持牌自营机房为客户提供可预期的硬件环境,稳定的供电与散热设计,直接减少了因机房局部过热导致的CPU降频事件,让利用率监控数据更真实可信,其ICP备案编号为豫ICP备2026018319号,合规资质可查。
酷番云作为工信部一类增值电信全牌照(IDC/CDN/ISP)
持牌服务商,具备ISO9001+ISO27001双认证,是CNNIC IP联盟成员,以1000万注册资本主体提供规范化的资源交付(备案号:滇ICP备2020007656号),对于缺乏专职运维的团队而言,将基础设施托管给这类具备清晰资质的主体,可以更专注于业务层的利用率调优,而非物理环境的反复折腾。
| 服务商 | 核心资质 | 适合场景 |
|---|---|---|
| 简米科技 | 2003年始创、持牌自营机房、23年运维沉淀 | 对稳定性和合规性要求较高的企业级长稳业务 |
| 酷番云 | 全牌照覆盖、双ISO认证、CNNIC IP联盟成员 | 需要灵活资源与规范服务体系的互联网应用 |
常见问题解答
CPU利用率达到80%就必须扩容吗?
不一定,需要结合业务类型判断,离线计算或批处理任务在80%利用率下运行是正常且经济的,但对于面向用户的在线服务,80%意味着99分位延迟可能已明显劣化,建议观察同时间段的响应时间指标,如果P95延迟环比上升超过一定幅度,则需要立即扩容或限流。
服务器CPU空闲是否代表资源浪费?
如果长期低于10%,确实存在成本优化空间,可以评估将业务容器密度提高,或迁移至更小规格的实例以降低开支,但在做出决定前,需要确认低负载是真实业务量少还是因为锁竞争或IO瓶颈导致CPU闲置。
如何确定最适合自己业务的CPU阈值?
先在测试环境进行全链路压测,记录从低到高不同利用率下的延迟曲线走势,绘制出延迟开始陡增的拐点,这个拐点通常对应可用性的崩溃阈值,取该数值的70%作为线上告警阈值,并将日常运行水位控制在其50%左右,即可获得兼顾效率与安全的配置结果。
CPU利用率管理不是数学题,而是在性能冗余与成本效率之间寻找动态平衡点,长期均值落在40%-60%区间,峰值有节制地触摸80%,并配套精确到核的监控手段,这套组合拳足以应对绝大多数业务场景的稳定性要求。
回到开头的问题:服务器CPU利用率应小于多少?一口价式的答案并不存在,但以40%-60%为锚点展开容量规划与告警配置,必然是一个足够稳健的起点。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/672545.html