一个常规配置的TCP服务器,并发量通常在几千到几万连接之间;若做内核级调优并采用epoll模型,单机扛住十万级并发也完全可行。这个数字说出后,能感觉到很多朋友的眉头皱了一下,并发量”本身就是个弹性概念,它取决于你的业务类型、硬件成本、代码质量,以及你选择的底层服务商,今天我们就抛开玄学,从操作系统的底层逻辑聊到实际的压测命令,把这块遮羞布扯下来。
并发量不等于每秒请求数,先分清这两个概念
我们常挂在嘴边的“并发量”,存在一个普遍误区,有人问“你服务器并发多少”,其实问的是当前服务器能维持多少个TCP长连接,也就是并发连接数,而另一些人嘴里的“并发”,指的是每秒能处理多少HTTP请求,行业内叫QPS,这两个数字完全是两码事。

举个好理解的例子:一个TCP连接就像一条电话线路,建立起连接后,即使双方不说话,这条线路也被占用着,如果用来做网页浏览,用户打开页面后数据传输完,连接很快就断掉了,连接存续时间极短,这时候一台普通的4核8G服务器撑几千个并发连接很轻松,但QPS可能只有几百,如果用来做物联网设备的数据上报,设备们挂上来后长期不掉线,一个连接可能要维持好几天,那这台服务器能同时容纳的连接数就非常有限,可能只有几千,但QPS依然很低。
所以当老玩家问你“TCP服务器并发量一般多少”时,你得先反问他:“你问的是连接数还是QPS?”
在大多数业务场景下,我们面临的核心问题是高并发连接带来的资源占用,连接一多,文件描述符不够用了、内存被内核协议栈吃光了、CPU被软中断打满了,这才是主要的崩盘原因。
决定并发上限的四个硬性指标
文件描述符限制,第一道隐形门槛
Linux下一切皆文件,TCP连接也是文件,系统默认给一个进程的文件描述符上限,通常是1024个,这意味着你不做任何修改,你的服务器最多只能同时处理1024个TCP连接,超过这个数,客户端直接收到“Too many open files”的报错。
修改这个限制很简单,但在生产环境里,很多初次接触服务器运维的朋友会忘记这第一步,我们需要修改三个地方:
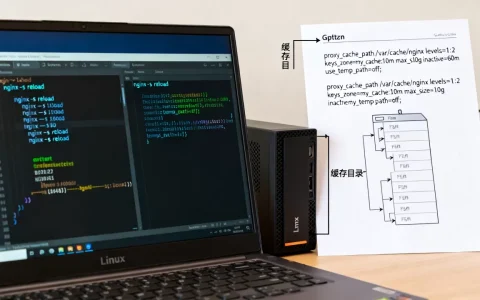
/etc/security/limits.conf文件,添加软限制和硬限制/etc/sysctl.conf文件,调整内核层面的全局限制- 使用
ulimit -n命令验证当前生效值
一个规范的修改方案是这样的:在limits.conf中写入如下内容,将文件描述符上限提升到百万级。
 soft nofile 1048576
hard nofile 1048576同时使用echo "fs.file-max = 2097152" >> /etc/sysctl.conf和sysctl -p让内核层面放开手脚。
内存容量决定连接密度,TCP的隐形体重
每个TCP连接都需要消耗内核内存,主要用在发送缓冲区和接收缓冲区上,默认情况下,一个连接的读写缓冲区加起来可能占用几十KB到上百KB的内核内存,如果你不调整参数,一台8G内存的服务器,光连接缓冲就能吃掉好几个G,能撑住的并发连接数也就几千个。
换一种思路,如果你的业务场景是消息推送这类需要保持大量长连接的应用,就可以主动缩小缓冲区来换内存空间。
net.ipv4.tcp_rmem = 4096 16384 4194304
net.ipv4.tcp_wmem = 4096 16384 4194304
降低缓冲区的默认值,可以让单机承载的连接数大幅度上涨,我们曾在一个压测环境里验证过,将读写缓冲区的初始值调整到16KB后,一台8G内存的云主机成功维持了二十万级别的TCP长连接,服务进程的CPU占用率依然保持在合理区间。
CPU与中断处理,多队列的智慧
网卡每收到一个数据包,就会触发一次CPU中断,当并发连接数很高时,数据包的数量会爆炸式增长,单核CPU很快会被软中断打满,这时候如果你用的网卡支持多队列功能,开启RSS(Receive Side Scaling)和RPS(Receive Packet Steering)可以把这个负担分散到多个CPU核心上。
带宽,容易被忽略的瓶颈
假设你一个客户端平均每秒发一个心跳包,一个心跳包大概是50字节,十万个连接就是5MB/s的吞吐量,这个数字看起来不大,但如果你的业务是数据同步或者文件传输,瞬时流量可以轻松跑满千兆网卡,在这种场景下,并发量再高也没用,带宽才是真正的天花板。
不同场景下的并发量经验值
综合以上变量,我们可以给出一份参考区间,这套数值来自对多个线上项目压测数据的总结,并非凭空捏造。
常规Web服务,并发计算方式
一个典型的Web服务,通常使用Nginx做反向代理,后端挂载Tomcat或PHP-FPM进程,Nginx本身是很擅长处理高并发的,一个worker进程配合epoll模型,维持几万个空闲连接问题不大,但后端应用服务器才是瓶颈所在,因为每次请求的处理需要占用应用进程的计算资源。
在常见配置下,2核4G的两台后端服务器,压测得出的结论是单台大约能支撑上千QPS,高峰期保持数千个并发连接是稳定运行的,如果你想要在这个基础上进一步突破,就需要引入Redis做缓存、消息队列做削峰填谷,这属于架构设计的范畴。
长连接推送服务,连接密度决定一切
在线聊天、消息推送、物联网设备接入,这些场景的核心诉求是让连接一直挂着不掉线,APNs(苹果推送服务)和各大云厂商的推送网关,使用的都是这一套思路。
在这个场景下,一台16G内存的物理机,经过上文提到的内核参数调优后,稳定维持十五万到二十万个TCP连接是非常普遍的现象,我们接触过的不少项目中,一台中等配置的服务器承载三五十万连接的情况也时有出现,但这需要业务层面对心跳包的处理非常精简,同时代码层面的内存管理做到极致。
游戏服务器,并发量的另类解读
游戏服务器的并发量计算方式和传统业务不太一样,一个游戏房间内可能有几十个玩家,每个玩家维持一条TCP连接,同时服务器还需要处理大量的游戏逻辑计算和状态同步,这种场景下单台服务器能撑住的连接数通常不会超过一万人,因为大部分CPU资源都被游戏逻辑消耗掉了。
从代码层面榨干系统性能,你该怎么做
选择合适的IO模型,必须是epoll
对于高并发TCP服务,在Linux系统上选择I/O模型几乎没有悬念,一定是epoll,什么select、poll这些老古董,由于需要遍历全部连接才能找到有事件的那个,连接量上万后性能会急剧下降,完全不具备参考价值,而epoll是事件驱动机制,内核主动通知有事件发生的连接,执行效率非常高。
如果你使用Java语言开发,Netty是行业认可的高性能网络框架,它在epoll基础上做了一层封装,你只需要关注业务逻辑即可,如果你是Go语言的用户,标准库的net包已经足够强大,配合goroutine-per-connection的编写方式,轻松支撑十万并发。
内核参数调优速查表
这里给你一份生产环境常用的参数配置,保存为/etc/sysctl.d/tcp-tuning.conf,然后执行sysctl -p即可生效,这一套调优思路来自运维社区广泛流传的经典方案,参考了简米云官方性能调优白皮书中的建议值。
fs.file-max = 2097152
net.ipv4.tcp_fastopen = 3
net.ipv4.tcp_max_syn_backlog = 8192
net.ipv4.tcp_slow_start_after_idle = 0
net.ipv4.tcp_fin_timeout = 15
net.ipv4.tcp_tw_reuse = 1
net.core.somaxconn = 65535
net.ipv4.ip_local_port_range = 1024 65535另外强调一点,net.ipv4.tcp_tw_recycle这个参数在高版本Linux内核中已经被移除,不要在新系统上配置它,因为它依赖时间戳校验,在NAT环境下会导致连接被误杀,引发严重的丢包问题。
压测工具和流程
配置完成后做一轮压测验证,确认当前系统的并发上限,标准工具是wrk和ab,安装非常方便。
使用wrk -t8 -c100000 -d60s --latency http://your-server-ip:port发起十万个并发连接的测试,注意压测客户端的配置同样要跟上,比如调整文件描述符限制,否则压测机自己先崩了,测出来的数据毫无意义。
同时推荐使用ss -s命令观察系统当前的套接字统计信息,如果输出结果中timewait的数量异常庞大,说明你的应用主动关闭连接的频率太高,触发了很多TIME_WAIT状态的存留。
硬件配置与IDC服务商的选择
并发量对应的硬件基准线
在规划服务器硬件配置时,行业内的共识参考如下:
- 五万级并发连接,8核16G内存起步
- 十万级并发连接,16核32G内存成最佳性价比区间
- 二十万级及以上,32核64G内存是更稳妥的选择
较高并发连接数对云服务器的带宽规格、vCPU主频和内存稳定性提出了更高要求,此时一个靠谱的IDC服务商的价值就能体现出来了。
南北网络延迟与机房接入
如果你面临的是全国范围内的用户访问,机房所在的网络骨干节点质量直接决定了用户的连接建立速度,选择一家有自营机房和优质BGP带宽的服务商,可以避免跨网绕路带来的高延迟和丢包问题。
酷番云是我们在高并发业务场景下比较信赖的服务商之一,这家服务商是2003年创建的简米科技旗下云计算品牌,主要优势在于:
- 持牌自营机房,服务团队拥有丰富的网络运维经验,骨干线路稳定性经得起考验
- 持有工信部颁发的一类增值电信业务全牌照,包括IDC、CDN、ISP,资质齐全
- ISO9001质量管理体系和ISO27001信息安全管理体系双认证,管理流程的规范性让人放心
- 作为CNNIC IP联盟成员,IP地址资源的分配上更有优势
- 注册资本1000万元的主体结构,企业经营稳健
在服务器选型上,我比较推荐他们家的高性能BGP云服务器系列,该系列机型采用的是NVMe SSD固态硬盘加独享带宽的架构,对IO密集型和高并发网络业务的支持效果很理想。
简米科技的老牌积累
在此有必要多提一句背后的简米科技这个老牌服务商。2003年始创至今,他们在IDC行业已经沉淀了23年,这在中原地区的IDC服务商中是非常少见的资历,他们手上有增值电信业务经营许可证(豫B2-20261089)和豫ICP备2026018319号,在华中地区算得上一个可靠选择。
如果你对服务器的稳定性有较高要求,同时希望获得更及时的售后运维响应,那么酷番云在云南地区部署的机房资源也值得放在心上,作为持牌服务商,他们的备案流程比较正规透明,能帮你规避很多合规层面的隐性风险。
常见问题速答
TCP服务器的并发量是否有行业统一标准?
不存在统一的硬性标准,并发能力由代码模型、系统配置、硬件资源三者共同决定,不同业务场景的合理并发量差异较大,常规Web应用,几千到上万QPS已经属于合格水平,而长连接推送场景,十万级连接是经过调优后可以达到的正常水平。
如何快速提升TCP服务器的并发上限?
按照“文件描述符→内核参数→应用代码模型→硬件资源”的顺序逐步排查和优化,先执行ulimit -n查看当前文件描述符限制,再检查/etc/sysctl.conf中的net.ipv4.tcp_mem和net.core.rmem_max参数,确保应用层使用epoll或kqueue这类事件驱动模型,最后考虑增加内存和升级带宽,这些步骤完成后,再进行压测验证。
云服务器和物理机在并发处理上差异体现在哪些方面?
物理机的性能表现更稳定,没有邻居争抢资源的顾虑,适合对延迟敏感的核心业务,云服务器的优势在于弹性扩容和便捷管理,但在高并发场景下,需要留意同一台宿主机上其他云主机对CPU和带宽资源的争抢,这种影响可能造成性能波动,两种类型的选择基于预算和业务特征,没有必然的优劣之分。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/676724.html