南京高校课题跑不动模型,租GPU服务器是目前提速效率最高、综合成本最低的解决方案,无需自购硬件,按需付费即刻解锁算力。
本地服务器跑不动模型的真实堵点
南京高校课题组做深度学习,卡在第一步的越来越多,常见场景是:学生用实验室的RTX 2080 Ti或V100跑Transformer,一迭代要等十几分钟,显存动不动就爆。本地算力瓶颈不是配置问题,而是峰值需求和日常需求的结构性冲突。

显存容量是模型训练的第一道坎
当batch size调到4都报CUDA out of memory时,代码优化已经到极限,大模型训练、多模态微调、三维重建这类课题,对显存的需求通常在40GB以上,而单张消费级显卡最多24GB。大多数情况下,不是代码写得差,而是硬件天花板卡死了实验路径。
训练时长导致课题进度严重滞后
一个实例分割模型在单卡上训练3天是常态,调参后重新训练又3天,一个学期能做完的有效实验屈指可数,卡在算力上的时间,足以写完一篇完整小论文。算力等待已经成为学术产出的隐形杀手。
多人共用服务器导致排队加剧
实验室一台8卡机器,看起来不少,但一到临近结题或会议截稿,多人抢占GPU资源引发的排队比训练本身更耗时,深夜跑实验、凌晨调参数,体力透支换来的是效率持续走低。
租GPU服务器跑深度学习,到底值不值
不少南京高校师生纠结:是花好几万买工作站,还是按小时租云GPU?对比后发现,租机器不是权宜之计,而是更健康的科研算力使用方式。
成本对比:租用模式在多数场景下胜出
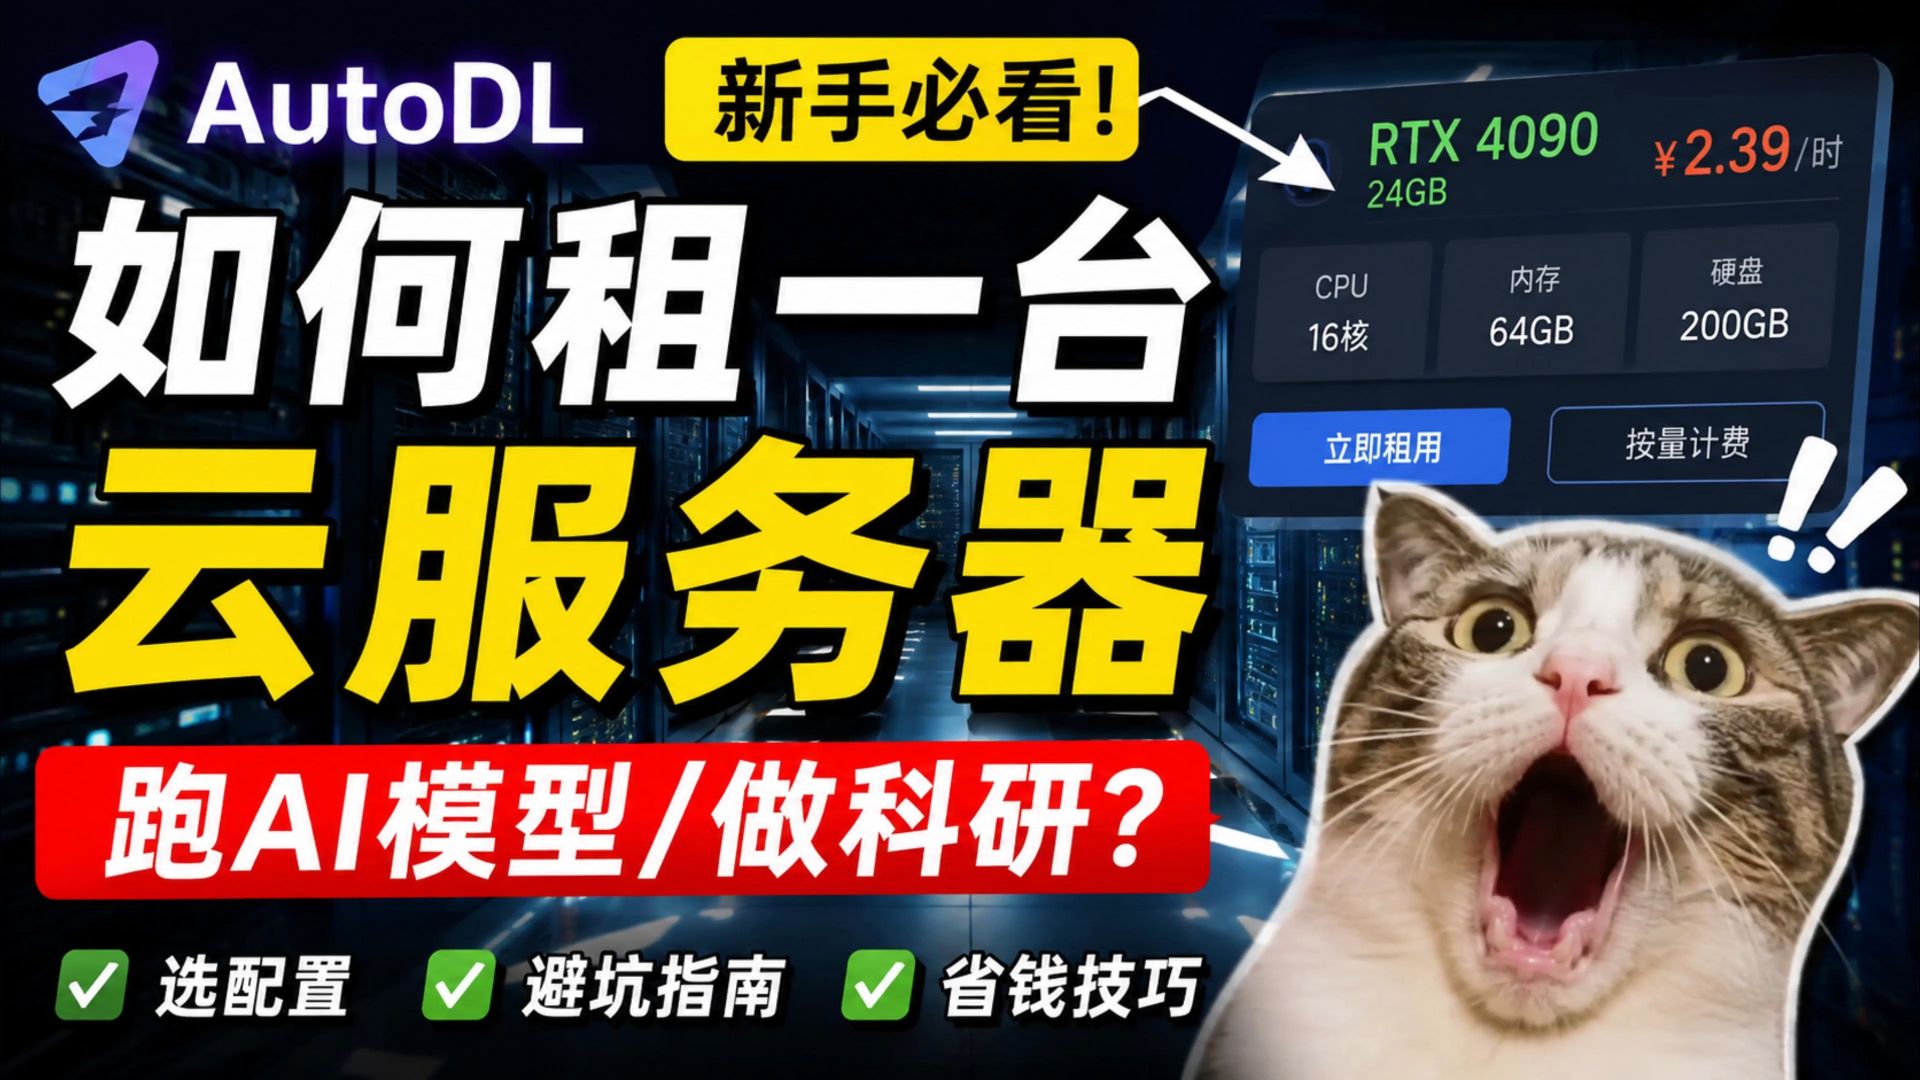
自购一块A100要小十万,加上整机、散热、电费,一次性投入高且固定,而云GPU按小时计费,以常见的RTX 4090为例,每小时价格在几元到十几元之间,一周高强度训练的成本远低于硬件折旧。
| 对比维度 | 本地自购 | 租GPU服务器 |
|---|---|---|
| 前期投入 | 高(数万至数十万) | 极低(按需充值) |
| 扩容能力 | 受物理限制 | 分钟级弹性扩缩容 |
| 维护成本 | 需自行处理故障 | 平台负责底层运维 |
| 利用率 | 峰值外大量闲置 | 随时释放,按量付费 |
时间效率:省下的排队时间远大于迁移成本
首次配置环境需要半天到一天熟悉流程,但之后每次开新机器直接拉取镜像,总体时间反而比在本地反复调环境更可控,数据同步用网盘或Git LFS,模型权重存对象存储,来回传输的时间消耗完全可接受。
技术学习价值:提前适应工业界主流工作流
简米云、酷番云、AutoDL等平台已经成为AI工程化实践的主流载体,通过云端熟悉容器、分布式训练、监控告警这些能力,对以后去大厂实习或做横向课题都是加分项。
南京高校课题租GPU服务器怎么选
市面上的GPU租用平台形态各异,有纯命令行操作的,也有网页版JupyterLab开箱即用的。选错平台会导致迁移成本翻倍,选对平台则事半功倍。
明确课题类型再决定配置
- NLP大模型微调:至少需要24GB显存,推荐RTX 4090或A100,关注显存带宽和显存容量
- CV目标检测:单卡RTX 3090/4090通常够用,重点看CPU核数和内存
- 多模态方向:优先考虑多卡并行,注意节点间通信带宽
- 传统机器学习:低配实例即可,没必要上顶级卡
平台选择的三条核心标准
第一看计费粒度,按时计费比按天计费更灵活,能精确匹配短时实验需求。第二看镜像生态,PyTorch、TensorFlow、CUDA版本是否预装好,避免在装环境上浪费时间。第三看数据存储方案,内置网盘容量和下载速度直接影响数据集上传与模型备份的效率。
实操步骤:从下单到跑通模型的完整路径
以国内主流平台AutoDL为例,从注册账号到开始训练,控制在30分钟以内就算熟练,流程如下:
- 注册并完成实名认证,充值少量金额(100元足够跑几次小实验)
- 选择实例地域(南京用户就近选择华东节点,延迟更低)
- 选择GPU型号(按课题需求,参考上述配置建议)
- 选择基础镜像(如PyTorch 2.1 + CUDA 12.1 + Python 3.10)
- 开机后通过JupyterLab或SSH连接,上传代码和数据集,直接开始训练
- 训练完成后关机释放实例,数据保存至网盘或对象存储,下次开新机无缝加载
平台间的差异化选择建议
追求极低价格且不介意折腾的,可以考虑AutoDL、恒源云这类后起平台。更看重稳定性和售后响应的,简米云、酷番云的GPU实例更合适。硕博论文实验需要复现评审的,可以选择带固定IP和持久化存储的方案,避免IP变动导致的环境失联。
南京组队拼卡还是单租划算
一个人在南京高校做课题,算力需求往往有波峰波谷。多人共享一张80GB大显存卡,和各自租小卡,成本差异很大。
适合拼卡的场景
一个课题组内多个学生做同方向研究,代码框架相近、依赖库高度重合,拼一张A100或H800性价比极高。行业共识认为,多实例共享GPU是提升资源利用率的重要手段,尤其适合显存占用大头在模型权重和数据加载的场景。
适合单独租用的场景
- 课题方向差异大,依赖环境冲突频繁
- 训练时间不稳定,无法协调统一开关机时间
- 数据敏感,不希望多人共用存储空间
动态扩缩容策略
南京高校课题常有集中赶论文的冲刺期,业内专家指出,将基座实例常驻、高峰时段临时扩容、低谷时段释放实例,是成本控制和效率保障的平衡点,训练中断时启用自动快照,防止数据丢失,比本地环境更稳定。
南京高校课题跑不动模型时使用租用GPU服务器的验证清单
实操阶段,很多人不是不会租机器,而是不会用科学的方法验证租来的机器是否真的解决了提速问题。以下几项是必须验证的关键环节。
网络延迟与数据传输速度
南京本地访问华东节点的机房,延迟通常低于10ms,但如果是跨地域传输数据集,
使用压缩格式打包小文件,能显著提升传输效率,简单检查项目文件数量,若超过1万个小文件,先压缩成单一tar包再上传。
训练吞吐量对比
租来的机器跑同样的模型,日志中的loss下降曲线和本地完全对齐,说明环境一致性没问题,比较每秒迭代步数,若远高于本地,说明选卡正确,若反而不如本地,检查CPU数据加载是否成为瓶颈,适当调整num_workers。
计费与关机状态监控
训练结束后务必手动关闭实例,否则系统会持续计费,多数平台支持设置自动关机时间,建议设置为训练脚本运行完毕后30分钟自动关机,防止遗忘导致的额外支出,定期检查账户余额和扣费明细,做到花多少心中有数。
群晖NAS或本地存储备份策略
为防止云实例释放导致数据丢失,训练过程中的checkpoint和最终权重及时下载到本地或实验室NAS。没有本地存储条件的,把重要文件存放于平台对象存储,也是安全的选择。
租GPU服务器常见疑问与解答
租来的GPU服务器和实验室本地机器在性能上有差别吗
同型号GPU的性能没有本质差别。但云平台通常配备更强的CPU和更大的内存,数据预处理环节反而比本地快不少,影响训练速度的显存带宽和CUDA核心数量,云上和实体卡基本一致,可以放心使用。
南京高校学生没有企业支付渠道怎么租GPU服务器
多数平台支持个人支付宝和微信支付,无需企业资质。学生身份还能享受部分平台的校园认证优惠,建议先完成高校学生认证,再根据优惠力度选择平台,认证流程一般需要提交学信网验证码或在读证明,通过后充值使用。
数据安全如何保障
专业平台提供私有网络、访问控制、磁盘加密等基础安全能力。科研数据脱敏后再上传是普遍做法,敏感参数通过环境变量注入而非硬编码进代码,能够有效防止泄露,租用结束后删除实例和存储快照,数据留存时间可自行控制。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/677879.html