非人类服务器,通俗讲就是不需要人天天守在跟前、能自己运行自己恢复的那类服务器,行业里更常叫无人值守服务器,目前市面上主流形态包含物理服务器托管、云服务器、边缘计算节点、容器化集群四大类,它们各自解决不同场景下的“省人”需求。
非人类服务器有哪些类型
要理解非人类服务器,先得明白传统服务器的痛点:占地方、吵、发热大、要定期重启、要人盯着硬件状态,非人类服务器的核心思路就一个把“人”从日常运维里摘出去。


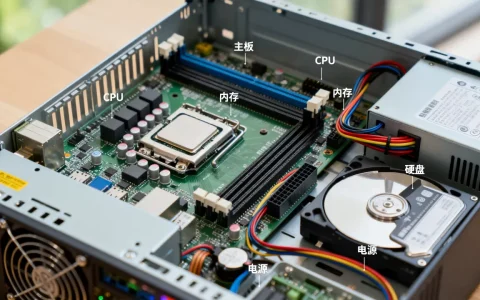
无人值守物理服务器:把机器寄养在专业机房
这是最接近“传统服务器”的形态,区别在于你不直接碰硬件,服务器买好或租好后,直接托管到IDC机房,机房提供电力、带宽、散热和安保,你通过远程管理卡(比如IPMI、iLO)完成开机、重启、装系统等操作。
- 适合场景:对硬件有特殊要求(比如需要GPU卡、需要超大内存)、数据不想上公有云的团队
- 关键能力:带外管理、远程开关机、硬件告警通知
- 常见问题:服务器托管哪个机房更稳定主要看网络质量、电力冗余和响应速度,不同城市机房价格差异较大,北上广深明显更贵
这种模式下,一年到头你可能都见不到服务器真机一面,机房里发生了什么全靠监控面板告诉你。
云服务器:连硬件都替你把关的“真·非人类”
云服务器是目前最典型的非人类服务器,你不需要买任何物理设备,通过网页控制台就能在几分钟内创建一台服务器,底层硬件坏了?云厂商直接迁移,你无感知。
- 适合场景:绝大多数Web应用、小程序后端、数据库、测试环境
- 核心优势:弹性扩缩容、快照备份、自动迁移
- 价格逻辑:按量计费适合短期突发场景,包年包月在长期稳定使用下更划算
云服务器和物理服务器区别不仅体现在硬件归属上,更体现在运维边界,云服务器连硬件告警都归云厂商管,用户只需要关心操作系统内的状态。
边缘计算服务器:偏远位置的自助工作者
边缘计算节点更像一个“下沉式”的非人类服务器,它被部署在靠近用户的地方,可能是某个小区的弱电井、某家工厂的车间角落、某个偏远地区的基站旁边,这些位置没人愿意长期值守
,所以对无人化要求极高。
一台边缘服务器通常要具备:自动断电恢复、自检自愈、远程批量升级能力,比如某工厂部署了一组边缘节点做质检数据处理,机器突然断电,来电后要能自己起来继续干活,不能等人过去按开机键。
容器化集群:用软件定义出的“服务器群”
容器化集群(如K8s集群)算是一种“虚拟的非人类服务器”,它把多台物理机或虚拟机资源池化,由调度系统统一管理,某台节点挂了,系统自动把POD调度到其他节点,这个过程完全不经过人手。
- 适合场景:微服务架构、持续交付、弹性伸缩明显的业务
- 运维状态:平时不需要逐台登录服务器操作,都是用命令批量控制
- 行业共识认为,容器化是服务器“去人工化”最彻底的一种形态
无人值守服务器怎么选才靠谱
了解完类型,接下来的问题就是自己该选哪一种,是租台物理机器扔机房,还是直接买个云服务器?
先看你的业务对“绝对性能”的需求
如果你的业务跑着训练模型、视频渲染、大规模数据库这类吃硬件性能的活儿,云服务器的性价比优势会被稀释,此时租用或购入物理服务器托管到机房更划算,托管模式下,机器配置完全自定义,没有虚拟化损耗,性能发挥更充分。
再看团队有没有“三更半夜爬起来重启”的准备
云服务器的核心价值不在硬件配置多高,而在于故障自愈能力,设备宕机、磁盘损坏、网络抖动,这些事在云上大概率不用你操心,但物理托管不同,虽然机房会帮你重启、插拔网线,但复杂硬件故障仍需厂商或你自己处理。
业内专家指出,在业务起步或流量波动明显阶段,优先选择云服务器能显著降低试错成本。
| 维度 | 无人值守物理服务器 | 云服务器 | 边缘计算节点 |
|---|---|---|---|
| 硬件归属 | 自有或租用 | 云厂商所有 | 自有或租用 |
| 故障处理 | 机房代劳,复杂故障需人工介入 | 自动迁移,用户基本无感 | 自愈优先,远程介入 |
| 初始成本 | 较高 | 较低,按需付费 | 中等 |
| 运维门槛 | 需要熟悉带外管理和ILO | 只需要熟悉控制台 | 需要掌握批量部署工具 |
| 适用地域 | 城市机房 | 不限 | 偏远、分散位置 |
看预算时别只盯着“月付”数字
按量计费的云服务器平时看着挺便宜,但长期跑满24小时后价格可能比包年包月贵不少,如果你打算长期运行一个稳定的业务,年付或包年包月通常更划算,而物理托管除了服务器本身的成本,还要加上机位费和带宽费,综合算下来单手价格未必比云服务器低。
考虑团队“有没有人会写自动化脚本”
非人类服务器的终极形态是“不需要人”,如果你团队里有人懂Ansible、Shell、K8s,那么不管选哪类服务器,都能把人工介入频率降到极低,反之,如果不懂自动化运维,就算选了无人值守物理服务器,遇到问题还是得自己跑机房。
非人类服务器的运维实操要点
选了非人类服务器只是第一步,真正让它“非人类”的是你的运维方式。
远程管理通道必须备两条
物理服务器一定要配置带外管理(IPMI/iLO),同时开启SSH密钥登录,密码登录直接禁掉,这样即使系统崩溃、网络中断,你还能通过带外管理卡看控制台、强制重启,不用联系机房代操作。
监控告警要覆盖到“硬件层”
很多团队只监控CPU和内存,硬盘SMART信息、电源状态、温度传感器往往被忽略,非人类服务器出问题,最先报警的往往是硬件层,配置好SNMP或Agent采集,把磁盘坏道预测、风扇转速异常、内存ECC报错都纳入告警范围,才能做到“人没到现场,问题已经定位”。
定期演练“失联恢复”
选个周末,把服务器从网络里断开,模拟一次彻底失联,看你要花多久才发现、多久能恢复,如果这个过程超过半小时,说明运维自动化水平还不够,需要补充更完善的拨测和自愈脚本。
日志集中管理别省
非人类服务器分散在不同机房,不可能每台都登上去看日志,把日志统一收集到集中平台(比如ELK或Loki),当某台机器出问题时,直接检索,快速定位原因,这一点尤其适合那些边缘计算服务器是不是无人值守的场景位置越偏,越需要远程排查能力。
无人值守服务器最容易踩的坑
非人类服务器听着省心,但有些坑必须提前知道。
硬件“亚健康”拖成大故障
无人值守服务器的硬件指示灯平时不看,出了问题只看监控曲线难以判断,建议每半年做一次硬件自检,通过带外日志查看历史报错,别等硬盘彻底损坏才发现数据没备份。
忽略“无人化”不等于“无备份”
有些团队把服务器托管出去,以为机房靠谱,就不用做异地备份,事实是机房只能保证电力和网络,你数据的安全还得自己兜底。至少做一份异地或云上快照,这是所有非人类服务器的保命底线。
续费和资费问题没人提醒
物理托管到期没续费,机房可能直接断网关机;云服务器欠费,数据可能被释放,设置好到期提醒和自动续费,别让一台跑得好好的服务器因为“忘了交钱”而消失。
把“非人类”理解成“没人管”
一个常见的误区是:非人类服务器就不用管了,实际上它只是减少了重复性人工操作,架构设计、容量规划、安全补丁更新,该做的还是得做,只是这些操作从“跑机房”变成了“远程执行”,从“月度巡检”变成了“自动定时任务”。
非人类服务器相关Q&A
非人类服务器能完全替代运维工程师吗?
不能,它可以替代重复性、机械性的运维动作,但架构设计、故障根因分析、安全策略制定、业务性能优化这些环节仍依赖人的判断和决策,非人类服务器降低了运维门槛,但没有消灭运维岗位本身。
个人开发者选非人类服务器,云服务器和物理服务器选哪个更合适?
大多数情况下选云服务器更合适,个人开发者流量有限,云服务器按量计费或低配包年包月成本可控,且能获得快照、安全组、自动告警等基础能力,无需处理硬件故障,若开发者有闲置物理机且机房托管费用可接受,无人值守物理托管也能实现类似效果。
边缘计算服务器是无人值守的吗?
业内专家指出,边缘计算部署场景大多距离远、环境复杂,天然要求无人值守能力,边缘节点通常具备断电自恢复、远程升级、失败自动回滚等特性,本质上就是为“非人类”运行场景设计的。
非人类服务器不是一种噱头,而是基础设施演进的方向。物理托管解决所有权与空间问题,云服务器解决运维与弹性问题,边缘节点解决距离与延迟问题,容器集群解决规模与调度问题,根据自身业务形态选对类型,配合完善的自动化监控和备份策略,就能让服务器回归“工具”属性,而不是团队24小时的累赘。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/682805.html