服务器异常并非毫无征兆,多数情况下在彻底宕机前数小时甚至数天,CPU、内存、磁盘、网络、进程和日志就会发出可量化的预警信号。 这些信号单独看可能不起眼,但组合起来就是一套提前干预的窗口期。
服务器异常前兆有哪些表现?从资源指标看第一层信号
CPU使用率持续高位或忽高忽低
- 用
top看%us和%sy,如果%sy长期偏高,可能内核或驱动有问题。 load average超过CPU核心数1.5倍,且持续15分钟以上,说明排队严重。vmstat 1中r列大于核心数,b列非零,代表进程阻塞。- 忽高忽低伴随
%wa升高,通常是I/O等待拖累。
内存与交换分区异常
free -m显示available持续下降,swap使用量增加。dmesg -T | grep -i oom出现OOM killer记录,说明内存已不足。- 缓存命中率下降,应用响应变慢,数据库查询延迟上升。
磁盘空间与I/O延迟
df -h看分区使用率,根分区超过80%就要警惕,超过90%随时可能写满。iostat -x 1中%util接近100%,await超过10ms(机械盘)或1ms(SSD),说明磁盘饱和。smartctl -a /dev/sda查看SMART告警,如Reallocated_Sector_Ct增长。
网络流量与连接数波动
ss -s看TIME_WAIT数量,异常增多可能是短连接风暴。netstat -i看丢包和错误计数。- 带宽跑满但业务量未增加,可能是被攻击或异常外联。
- 据工信部相关公开信息,数据中心运维强调预防性维护,网络指标是重点监测对象。
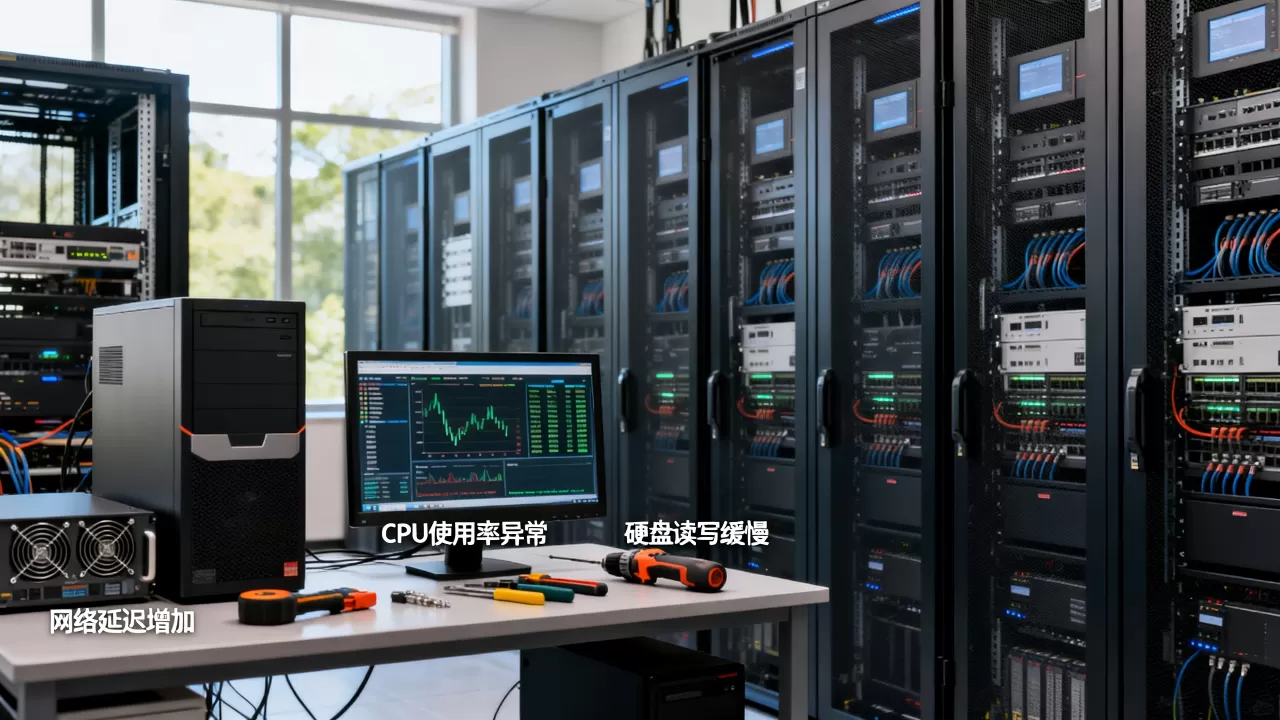
云服务器异常预兆和物理服务器对比:监控重点有何不同
云服务器:更依赖宿主机告警与弹性事件
- 云监控中的“实例不可用”“CPU积分耗尽”“突发带宽超限”是独有预兆。
- 系统盘IOPS突降,可能宿主机存储抖动。
- 收到“实例迁移”“底层硬件维护”通知时,要提前备份。
物理服务器:盯紧硬件传感器与RAID
- IPMI、iDRAC、iLO带外管理中的温度、风扇、电源告警。
- RAID卡日志中
Media Error、Predictive Failure。 - 内存ECC错误计数增加,
edac-util可查。
| 监控维度 | 云服务器 | 物理服务器 |
|---|---|---|
| CPU异常 | 积分耗尽、vCPU争抢 | 温度过高、降频 |
| 磁盘异常 | 云盘IOPS限制、宿主机抖动 | SMART、RAID降级 |
| 网络异常 | 安全组、弹性IP、带宽峰值 | 网卡丢包、光模块告警 |
| 硬件告警 | 较少直接可见 | IPMI、传感器丰富 |
服务器异常怎么提前发现?运维老手的实操检查清单
系统日志中的高频关键词
journalctl -p err -b查看本次启动的错误。dmesg -T | tail -50看内核环形缓冲。/var/log/messages或/var/log/syslog中搜索:OOM、I/O error、segfault、link down、smartd。- Nginx/Apache错误日志中
upstream timed out、502增多。
应用层响应时间与错误率
- 用APM工具或

curl -o /dev/null -s -w "%{time_total}n"
- 数据库慢查询日志突然增多。
- 消息队列堆积量持续上涨。
定时巡检命令与脚本
- 写一个
check.sh,定时采集top -b -n 1、free -m、df -h、ss -s。 - 用
sar -n DEV 1 5看历史网络趋势。 - 配置
crontab每5分钟记录一次关键指标到文件,便于回溯。
设置合理的报警阈值
- 不要只设90%硬阈值,用趋势报警:如磁盘使用率连续3小时增长超过1%。
- 报警分级:警告、严重、致命。
- 报警通道:短信、电话、钉钉或飞书,避免只发邮件。
不同场景下的服务器异常预兆:高并发、数据库与容器
高并发Web服务
- 连接数突增,
ss -lnt的Send-Q堆积。 - 后端响应时间P99升高。
- 负载均衡健康检查失败次数增加。
数据库服务器
- 慢查询增多,锁等待时间变长。
- 主从延迟增大。
- 磁盘I/O等待高,
iostat中%util饱和。
容器与Kubernetes
- Pod频繁重启,
kubectl get pods看RESTARTS。 - 节点
NotReady,kubectl describe node看内存压力。 - 容器OOMKilled事件。
北京服务器异常监控有什么特殊考量?
- 北京地区机房带宽成本较高,异常外联或DDoS更容易触发流量告警。
- 部分企业采用混合云,北京本地IDC与云上VPC打通,需关注专线延迟抖动。
- 北京地区对数据合规要求严格,日志留存和监控数据存储要符合当地规范。
服务器异常报警价格一般多少钱?自建与SaaS对比
- 自建Prometheus+Alertmanager:软件免费,但需要服务器和人力,成本主要在运维。
- 云厂商监控:按实例数或自定义指标收费,通常每月每实例几元到几十元。
- 第三方SaaS监控:按探针数或告警条数计费,价格差异较大。
- 小团队可先用云监控免费额度,规模大了再考虑自建。
服务器异常预兆的核心是“指标偏离基线”。 业内专家指出,服务器故障中相当一部分在发生前都有可观测指标异常,建立基线、持续采集、分级报警,就能在用户感知之前发现问题。
关于服务器异常预兆的常见问题解答
服务器异常前兆出现后,第一步应该做什么?
先确认影响范围,用uptime、free -m、df -h快速判断是资源问题还是服务问题,若CPU或内存异常,用top定位进程;若磁盘满,清理日志或扩容;若网络异常,检查ss -s和安全组,同时保留现场日志。
没有监控工具,怎么靠命令行发现服务器异常预兆?
可以定时手动执行:top -b -n 1 | head -20、free -m、df -h、iostat -x 1 3、ss -s、journalctl -p err -b | tail -50,记录输出,对比历史数值,异常往往体现在趋势变化,而非单次绝对值。
服务器异常预兆和故障报警有什么区别?
预兆是故障发生前的指标偏离,比如磁盘使用率从60%涨到85%、内存可用量持续下降,报警是预设规则触发的通知,预兆范围更广,需要人工分析趋势;报警更直接,但依赖阈值设置,两者结合,才能提前介入,行业共识认为,监控指标应结合历史基线判断,而非只看瞬时值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/683074.html