Spark服务器端口主要分为三组:Master和Worker的通信与Web UI端口(默认7077、8080、8081)、运行中应用的UI端口(默认4040)、历史日志服务端口(默认18080),修改这些端口需要在spark-env.sh和spark-defaults.conf里分别配置。
很多朋友第一次搭Spark集群,启动时看着满屏日志挺兴奋,但一访问Web界面就傻眼,要么打不开,要么打开之后发现根本不是自己想要的页面,这背后基本都是端口没弄明白,这篇文章就把Spark里那些“默认端口”一次说清楚。


Spark核心端口全景:从7077到8080的分工
Spark集群跑起来之后,各个角色各管一摊,端口就是它们之间沟通的门牌号,搞混了门牌号,消息自然送不到,先看一张总表,心里有个整体概念。
| 端口号 | 默认用途 | 对应配置项 | 使用场景 |
|---|---|---|---|
| 7077 | Master与Worker通信 | spark.master.port | 集群内部心跳、任务分配 |
| 8080 | Master Web UI | spark.master.ui.port | 浏览器查看集群状态 |
| 8081 | Worker Web UI | spark.worker.ui.port | 浏览器查看单个Worker状态 |
| 4040 | 运行中应用UI | spark.ui.port | 查看任务执行进度和日志 |
| 18080 | 历史服务器UI | spark.history.ui.port | 应用跑完后复盘日志 |
| 6066 | REST提交端口 | spark.rest.port | 通过HTTP方式提交任务 |
spark 7077端口配置:Master与Worker的通信枢纽
7077是Spark集群的“内线电话”,专门负责Master和Worker之间的心跳通信和任务调度,默认情况下,Worker会主动去连Master的7077端口,报告自己还剩多少内存和CPU,如果这个端口被占用或者防火墙拦了,你会看到Worker节点一直提示“Application ID”为空,或者压根连不上Master。
修改方式很简单,打开spark-env.sh文件,在底部加一行:
export SPARK_MASTER_PORT=7078
注意,这里有个容易踩的坑:spark-env.sh里设置的是Master的监听端口,但Worker那边也要知道新的端口号才能连过来,如果Worker和Master在同一个集群,start-all.sh脚本会读取同一份conf目录配置,通常没问题,但如果你在Worker机器上单独改了Master的IP,却忘了同步端口,就会出现“能ping通IP但连不上服务”的诡异情况。
spark 8080端口无法访问?先检查Master和Worker的Web UI
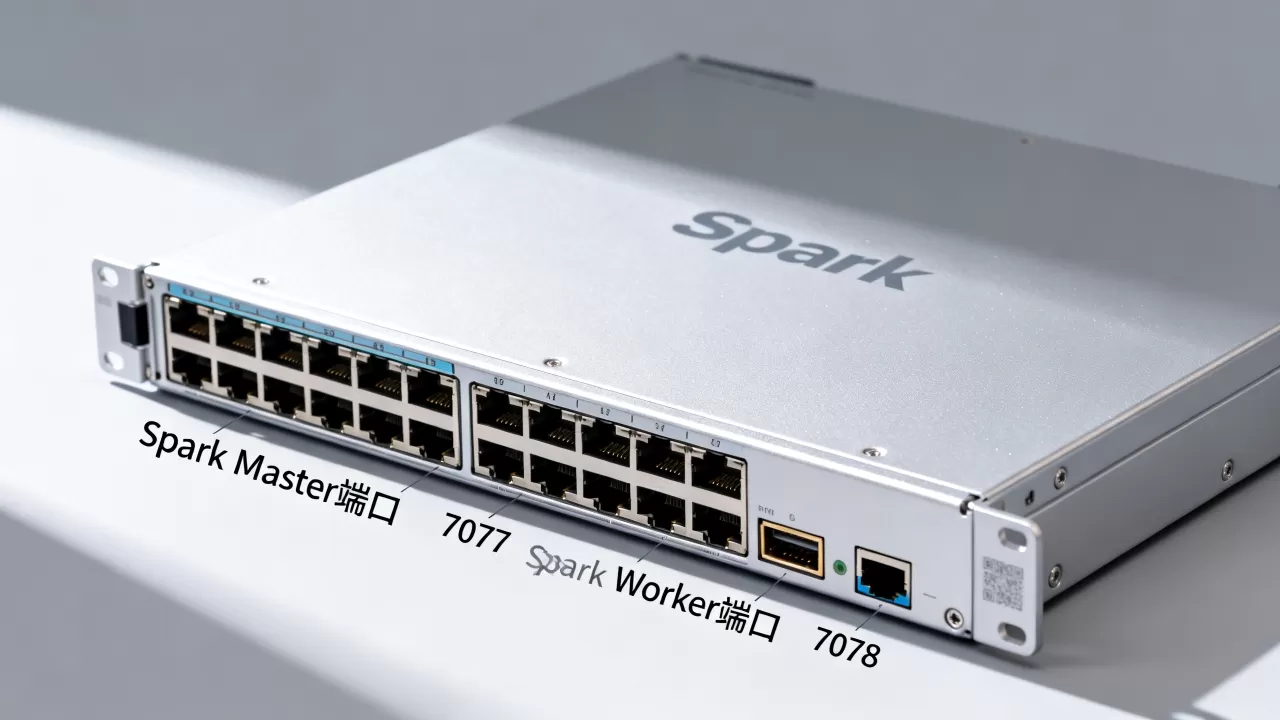
8080是Master的“展示橱窗”,浏览器打开http://master-ip:8080就能看到集群总览,包括挂载了多少Worker、每个Worker还剩多少资源、当前跑了哪些应用,排查思路如下:
- 先确认进程在不在:执行
jps命令,看有没有Master进程。 - 再确认监听地址:执行
netstat -tlnp | grep 8080,看是不是监听在0.0.0上,如果只监听了0.0.1,那别的机器当然访问不了,这时候去spark-env.sh里检查SPARK_MASTER_HOST或SPARK_LOCAL_IP有没有误设成localhost。 - 最后确认防火墙:关闭firewalld或者放行端口,CentOS里通常执行
systemctl stop firewalld测试,或者用firewall-cmd --add-port=8080/tcp --permanent精确放行。
Worker的Web UI端口是8081,逻辑完全一样,值得一提的一点是,8080端口有时候会被其他软件占用,比如Tomcat,如果发现Master进程起来了,但8080就是打不开,大概率是端口被抢了,改一下spark-env.sh里的SPARK_MASTER_WEBUI_PORT就好。
集群模式下需要重点关注的端口
除了Master和Worker,真正跑任务的时候还会涉及其他端口,这些端口往往被忽略,但恰恰是报错的根源。
spark web ui 4040端口:每个应用独占的监控窗口
4040是个特殊端口,它不像7077和8080那样是“常驻”的,而是每启动一个SparkContext就会占用一个4040端口。
比如说你在YARN集群上跑Spark,或者本地用spark-submit提交任务,日志里通常会打印一行INFO SparkUI: Bound SparkUI to 0.0.0.0, and started at http://node1:4040,这就是当前这个应用的专属监控页面,能看到Stage划分、每个Executor的内存使用曲线、SQL执行计划等细节。
这个端口的特点是“用完即走”,应用结束,4040端口就释放了,如果你连续提交了多个应用,第一个占4040,第二个自动分配4041,以此类推,如果找不到4040页面,看看是不是运行时的Driver跑在了别的机器上,需要去那台机器访问,而不是在提交任务的客户端上看。
18080与历史服务器端口:复盘任务的入口
默认情况下,Spark应用跑完,监控数据就没了,想回看某个任务为什么慢,就得靠History Server,它的默认端口是18080,配置项在spark-defaults.conf里:
spark.history.ui.port=18080
spark.history.fs.logDirectory=hdfs://node1:9000/spark-logs
启动方式是你自己执行sbin/start-history-server.sh
,而不是随Master自动启动,启动完之后,再打开http://master-ip:18080,就能看到所有历史应用的列表,点进去之后,页面长相和4040几乎一模一样,区别在于数据来自HDFS或本地目录里的eventLog文件。
这里有个实用建议:在spark-defaults.conf里务必开启spark.eventLog.enabled=true,否则History Server会显示空白,什么都看不到。
修改端口与排查冲突的实操方法
端口冲突是Spark运维里最常碰到的头疼问题,典型场景是这样的:你跑了两个Spark集群共用一台机器,第二个集群的Master想启动,结果发现7077被第一个集群占了,解决办法只有两个方向:改配置,或者杀进程,改配置是正道。
修改端口后重启才生效的完整流程
- 编辑
${SPARK_HOME}/conf/spark-env.sh,加入所需端口配置。 - 编辑
${SPARK_HOME}/conf/spark-defaults.conf,加入UI相关端口配置。 - 重启集群:先
stop-all.sh,再start-all.sh。 - 验证结果:
netstat -tlnp | grep 7077,确认新端口已监听。
有个很容易忽略的细节:spark-defaults.conf里的配置项,如果同时在spark-submit命令行里用--conf指定了,命令行的优先生效,所以改了文件但没生效的时候,先想想启动命令里是不是加了覆盖参数。
排查端口占用时,推荐三连命令:
lsof -i:8080
netstat -tlnp | grep 8080
ps -ef | grep spark
这三个命令分别看文件占用、网络监听和进程归属,基本能定位绝大多数冲突问题,业内专家指出,80%的端口问题都不是配置写错,而是防火墙规则或进程残留导致的,优先检查这两块,比反复改配置更高效。
散落在不同角色下的端口一览
| 配置项 | 默认值 | 作用对象 |
|---|---|---|
| spark.driver.port | 随机 | Driver通信端口,可固定以避免冲突 |
| spark.blockManager.port | 随机 | 跨节点数据块传输,BlockManager上报端口 |
| spark.fileserver.port | 随机 | 文件服务端口,用于分发Jar包 |
| spark.replClassServer.port | 随机 | Spark-shell交互式解析用 |
| spark.executor.port | 随机 | Executor与Driver的后台连接 |
这些“随机”端口在跨云部署或安全要求高的环境里特别容易出问题,比如公司只开放了指定几个端口给服务器之间互通,那随机端口就全被拦死了,解决办法是在
spark-defaults.conf里显式指定它们,
spark.driver.port=7079
spark.blockManager.port=7080
spark.executor.port=7081
固定下来之后,安全组规则也好配,防火墙策略也好写。
云端部署时的端口与安全组设置
不管是简米云还是酷番云,你在控制台改了安全组放行端口,但Spark页面还是打不开,这时候就得看服务器内部防火墙和Spark监听地址了,云服务器的安全组相当于小区的门禁,但机房内部防火墙(firewalld/iptables)才是房间的锁,两者都要放行。
| 云平台 | 安全组操作入口 | 需要放行的端口 |
|---|---|---|
| 简米云ECS | 实例→安全组→入方向 | 7077、8080、8081、18080、4040 |
| 酷番云CVM | 实例→防火墙→添加规则 | 同上,注意区分TCP/UDP |
| AWS EC2 | Security Groups→Inbound Rules | 同上,需自定义TCP规则 |
对于部署在云上的Spark集群,子网隔离也需要留意,如果Master和Worker在不同的子网,跨子网通信的ACL规则漏配了,日志里会反复出现”Unable to connect to Master”之类的报错。
行业共识认为,端口规划这件事,在搭建集群之前就应当画一张表出来,写清楚哪个角色用哪个端口,IP和端口一一对应,毕竟Spark本身设计得足够灵活,端口随意换都能跑,但运维成本会跟着配置复杂度上升,提前规划好,后面排查问题会省掉大量时间。
Spark端口常见问题解答
Spark 4040页面可以同时看多个应用吗?
不可以,4040端口是跟随SparkContext的,每个应用独占一个端口,第一个应用占4040,第二个自动递增到4041,想集中看所有应用,必须依赖History Server的18080端口。
改了spark-env.sh里的SPARK_MASTER_PORT,Worker连接时报错Address already in use,什么原因?
通常是端口没释放干净,旧Master进程可能还在占用原端口,新配置的端口又被别的服务占了,执行jps查看Master进程PID,用kill -9杀掉后再重启。
Spark的端口体系理解透了,排查集群故障的思路就清晰了一半,记住一句话:7077管通信,8080管展示,4040管现场,18080管复盘,下次再遇到连不上的问题,按这个思路去核对,十有八九能定位到症结。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/691079.html