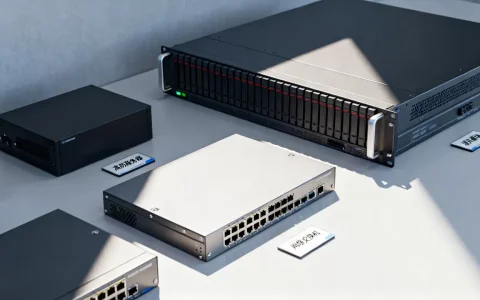
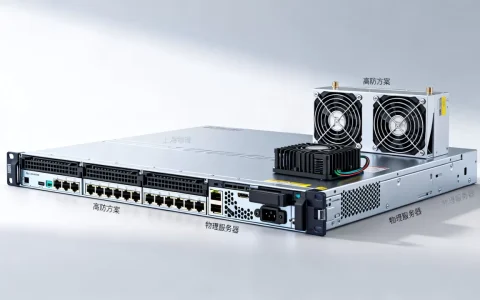
算力服务器的种类,按主流分类方式来看,主要分为通用CPU服务器、GPU加速服务器、NPU/FPGA专用服务器和边缘计算服务器四大类,其中GPU服务器是当前大模型训练与AI推理的绝对主力。这是目前行业内的共识性分类框架,很多朋友在咨询时,往往会混淆“云服务器”和“物理算力服务器”的概念,或者搞不清训练和推理该买哪种,这篇文章就从实际选购和使用的视角,把这几种类型的家底给你抖搂清楚。
按计算形态划分:四大核心算力类型
算力服务器的本质区别,在于内部搭载的“计算核心”不同,这直接决定了它擅长干什么活,以及价格差距能有多大,行业内通常根据加速芯片的类型来划分。
CPU服务器:通用计算的“万金油”
这是最传统的服务器形态,依靠高性能的x86或ARM架构处理器提供计算能力,它不擅长庞大规模的并行计算,但胜在逻辑处理能力强、生态兼容性最好。
- 适用场景:网站托管、数据库处理、企业ERP系统、简单的文件存储。
- 核心优势:稳定、兼容性强、软件生态最丰富,几乎所有企业级软件都能直接跑。
- 性能瓶颈:面对海量数据的矩阵运算(比如AI训练),CPU的算力显得力不从心,核心数量再多也难以高效完成。
GPU服务器:AI时代的“算力发动机”
这是目前热度最高、也是价格最贵的品类,GPU拥有数千个计算核心,特别适合做并行计算,业内专家指出,在大模型训练场景下,GPU服务器的效率是传统CPU服务器的数十倍以上。
- 硬件构成:通常采用“CPU+GPU”异构架构,最核心的部件是加速卡,如NVIDIA的H100、A100、L40S,以及AMD的MI300系列。
- 必须明白的:GPU服务器不只是用来训练的,推理场景同样离不开它,像ChatGPT这类应用,每次回答你的问题,后台都需要GPU服务器做一次“推理”计算。
NPU与FPGA服务器:特定领域的“偏科专家”
这两类服务器属于专用计算设备,虽然不如GPU通用,但在特定场景下能效比极高。
- NPU服务器:专为神经网络算法设计的处理器,擅长处理视频、图像等多媒体数据,常用于安防监控的人脸识别、智慧城市的视频流分析,功耗比GPU低不少。
- FPGA服务器:硬件可编程的芯片,出厂后可根据业务需求“定制”电路,在需要超低延迟的网络数据包处理、金融高频交易场景有独特优势。
按部署场景划分:云上和云下的博弈
除了芯片类型,你还得考虑服务器放在哪儿,这不仅是技术问题,更是成本问题。
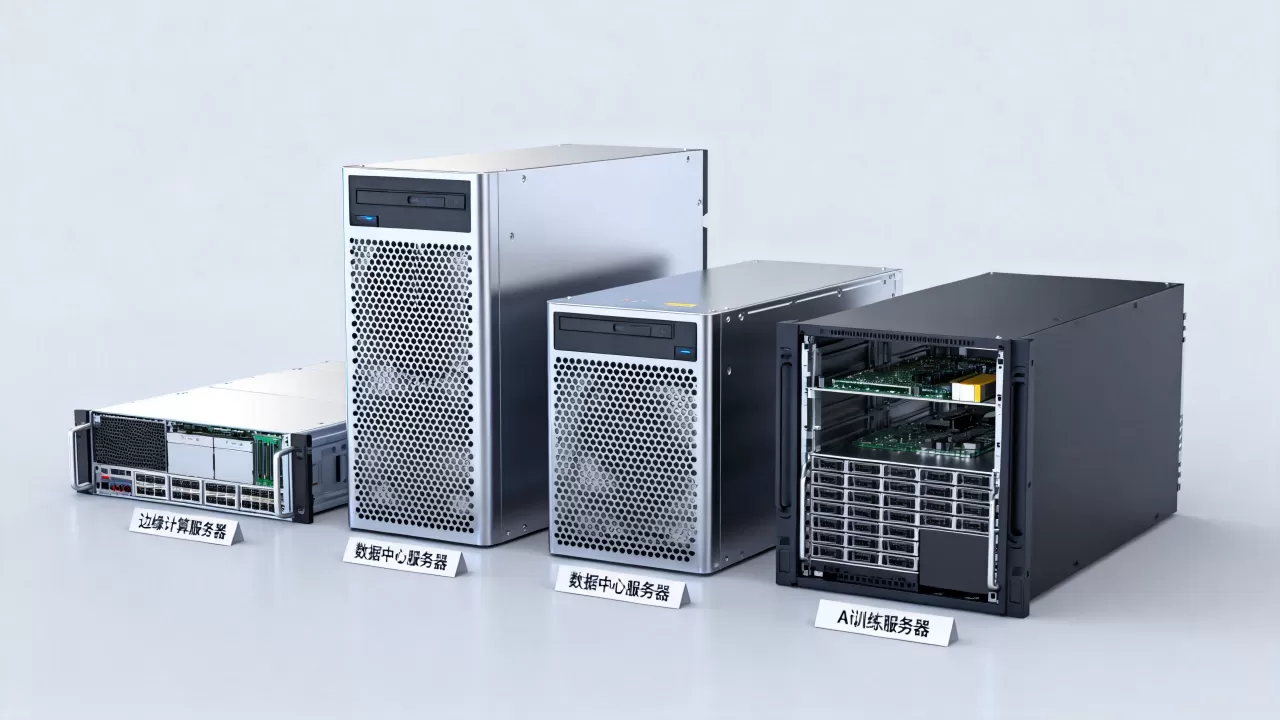
数据中心级裸金属服务器
这就是你租用或托管的物理机,企业买几台GPU服务器放在机房托管,还是直接租用云上的裸金属算力服务器,是很多团队纠结的问题。
- 自建托管:前期投入大,需要机房环境(电力、散热、带宽),适合预算充足、对数据私密性要求极高的金融、政务客户。
- 租用裸金属:按周期付费,弹性好,比如做短期的渲染项目,租一个月就行,不需要承担硬件折旧成本。
边缘计算服务器
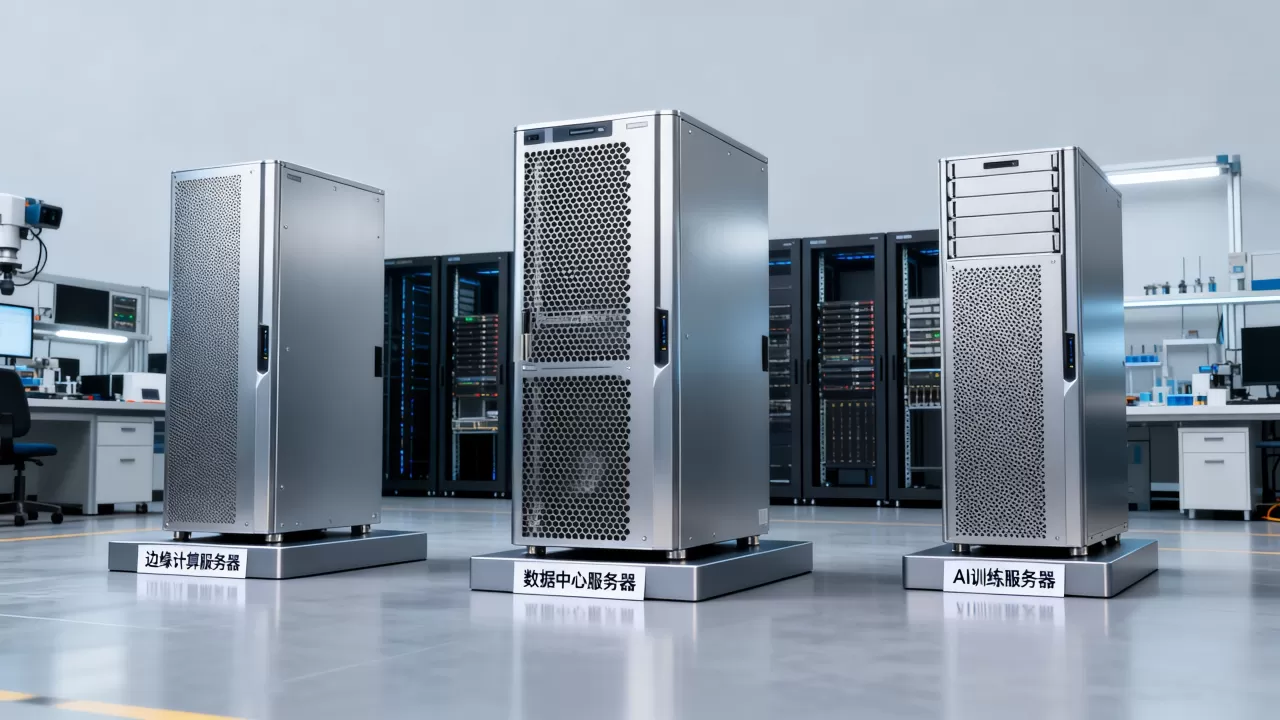
这是近两年非常火的概念,算力不再集中部署在大型数据中心,而是下沉到距离用户更近的基站或机房。
- 典型场景:自动驾驶汽车需要毫秒级响应,车路协同系统必须在路边部署边缘算力服务器,把数据就地处理,不能等回传云端再算。
- 形态差异:边缘服务器通常比数据中心服务器体积小,且要适应高温、高湿等恶劣物理环境。
按应用场景细分的差异化配置
同样是GPU服务器,训练和推理的配置逻辑完全不同,搞清楚你的业务主线,才能不花冤枉钱。
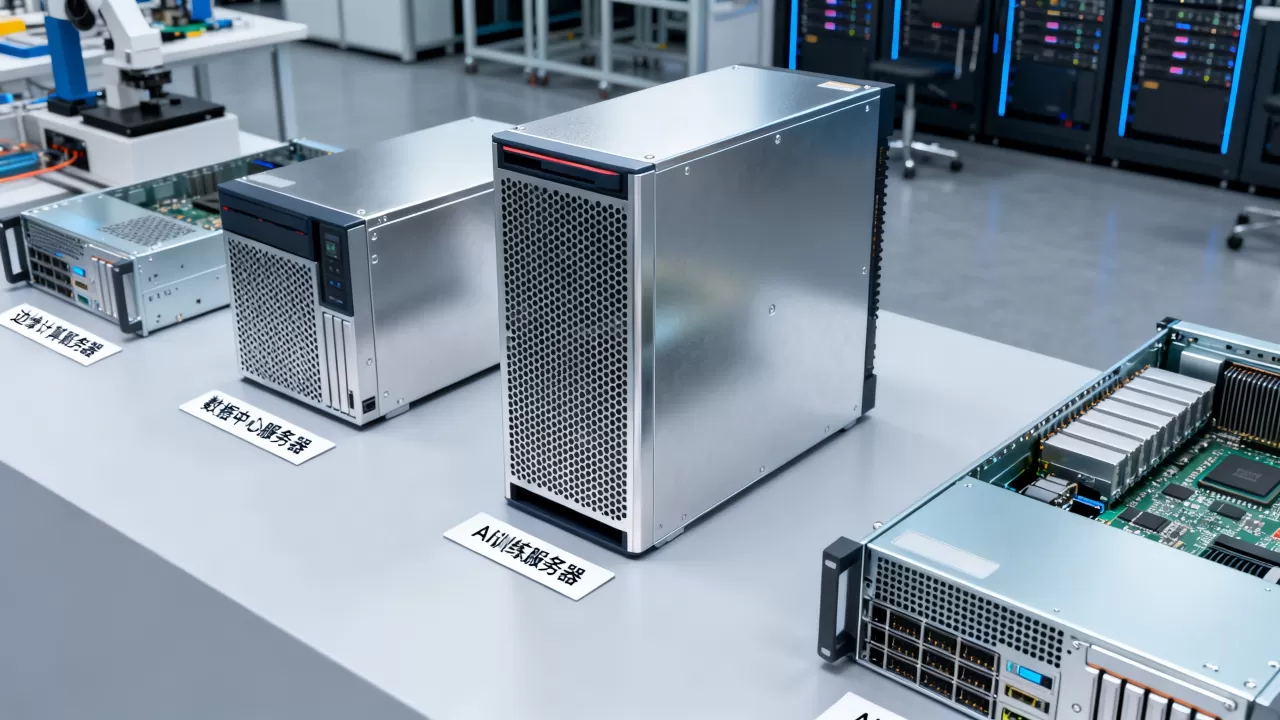
AI训练型算力服务器
这类服务器的特点是“蛮力输出”,追求极致的浮点运算能力,硬件配置上的典型特征是:
- 采用NVLink高速互联技术连接多张GPU卡(如8卡H800服务器)。
- 配备超大容量的高带宽内存(HBM)。
- 需要高功率电源和强劲的液冷散热系统。
AI推理型算力服务器
推理服务器更看重“吞吐量”和“延迟”,它不需要像训练那样计算海量梯度,但要求并发处理能力极强。
- 配置侧重:通常对GPU卡的要求是中端性能、低功耗(如L20、T4),甚至会使用专门优化过的TensorRT框架来加速。
- 成本差异:一台训练服务器的价格可能足以购买三到四台同等配置的推理服务器。
大模型训练算力服务器怎么选?
这里给出一个核心的实操建议:先看显存,再看算力,最后看互联带宽,如果你准备做千亿参数的模型预训练,单卡显存低于80GB的配置基本不用考虑。
| 关键指标 | 训练型首选 | 推理型首选 | 通用型可选 |
|---|---|---|---|
| 核心芯片 | NVIDIA H系列 | NVIDIA L系列 / A10 | 国产昇腾 / 寒武纪 |
| 卡间互联 | NVLink + InfiniBand | PCIe 5.0 | 千兆以太网 |
| 主要瓶颈 | 显存容量与带宽 | 并发处理能力 | 能耗比 |
国产算力服务器与采购决策
近年来,随着信创产业的推进,国产算力服务器的占比正在持续提升,以华为昇腾、海光、寒武纪为代表的国产芯片,虽然在通用软件生态上还有差距,但在特定垂直领域的表现已相当成熟。
价格与成本因素
算力服务器的价格浮动极大,是整个IT硬件市场里最不透明的领域之一,价格主要受芯片供货量影响。
- 低端入门

(主要用于图像处理或轻推理):单台价格在几万元区间。
- 主流配置(可用于微调或中型推理):价格在数十万元级别。
- 高端训练集群(8卡H系列):单台采购成本通常在一百万元以上,且需要预付款排队。
对于中小企业,如果不是长期高强度使用,实际情况是:租用云GPU实例的灵活性远高于自建机房,但如果是长期月付且满负荷跑,租用的费用半年左右就能超过自购硬件成本。
地域选择:算力服务器托管哪家好?
这是一个很现实的考虑因素,选择机房不能只看价格,需要关注区域电力政策和网络延迟。
- 一线城市(北上广深):带宽资源优质,但机柜费用极其昂贵,适合对延迟敏感的金融交易、实时音视频业务。
- 西部枢纽(贵州、内蒙古、甘肃):利用气候优势降低散热成本,电费便宜,适合大规模离线训练和冷数据存储,但网络延迟相对较高。
常见问题速答
训练和推理能共用一台算力服务器吗?
不建议混用,训练场景会持续让GPU芯片处于高负载状态,显存需求巨大;而推理场景属于突发性高并发,如果强行共用,会出现训练任务挤占推理资源,导致线上服务响应变慢,成本分摊计算会比较困难,通常建议生产环境物理隔离。
算力服务器的操作系统必须装Linux吗?
绝大多数情况下是的,目前主流的AI计算框架(PyTorch、TensorFlow)对Linux的支持最完善,NVIDIA的驱动和CUDA工具链在Linux环境下性能发挥最好,虽然Windows也能安装部分GPU驱动,但遇到集群部署时会遇到大量兼容性问题。
算力服务器的使用寿命是多久?
通常以GPU芯片的更新换代周期为参考,一般在3-5年,服务器本身的硬件(主板、电源)可以运行更久,但算力性能会跟不上软件迭代的速度,对于追求极致性能的训练任务,硬件折旧速度会加快,导致需要提前退役。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/694359.html