分布式渲染队列的负载均衡,单靠轮询不够,把节点资源权重、队列深度、任务亲和性和动态背压组合起来,才能让渲染农场在高峰时不空转、不雪崩。
分布式渲染队列负载均衡策略怎么选?云渲染农场与本地集群对比
先看一个场景,某动画团队有 40 台本地节点,同时接了云上抢占实例,周五下午提交 3000 帧,如果调度器只按轮询发任务,A 节点还在解压 20GB 资产,B 节点 GPU 空闲却被忽略,结果就是等待时间拉长,交付延期。

调度器要盯住的五个指标
- GPU/CPU 空闲率:渲染任务对 GPU 显存、CPU 核心数敏感。
- 内存与显存余量:显存不足会直接导致任务失败重排。
- 磁盘 IO 与缓存命中:资产读取慢,节点再空也快不起来。
- 队列深度与等待时间:队列长说明调度入口拥堵。
- 网络延迟与地域:跨地域拉取资产会拖慢首帧。
行业共识认为,队列深度比瞬时 CPU 更能反映真实压力,因为渲染任务启动时会有资源爬坡,瞬时指标容易骗人。
三类负载均衡策略对比
| 策略 | 适合场景 | 优点 | 常见坑 |
|---|---|---|---|
| 轮询/加权轮询 | 节点同构、任务短小 | 实现简单 | 忽略实时压力 |
| 最少连接/最少队列 | Web API、短任务 | 快速分流 | 长渲染任务会误判 |
| 资源感知+队列深度 | 异构 GPU、混合云 | 贴近真实负载 | 指标采集要准 |
| 一致性哈希 | 资产强亲和 | 减少重复拉取 | 热点节点难疏散 |
多数情况下,渲染队列适合“资源感知+队列深度+任务亲和”的组合,而不是单点策略。
动态权重公式怎么落地
可用一个简单评分:
score = 空闲GPU数 10 + 空闲CPU核数 2 + 空闲内存GB / 10 - 队列等待任务数 5 - 地域延迟惩罚
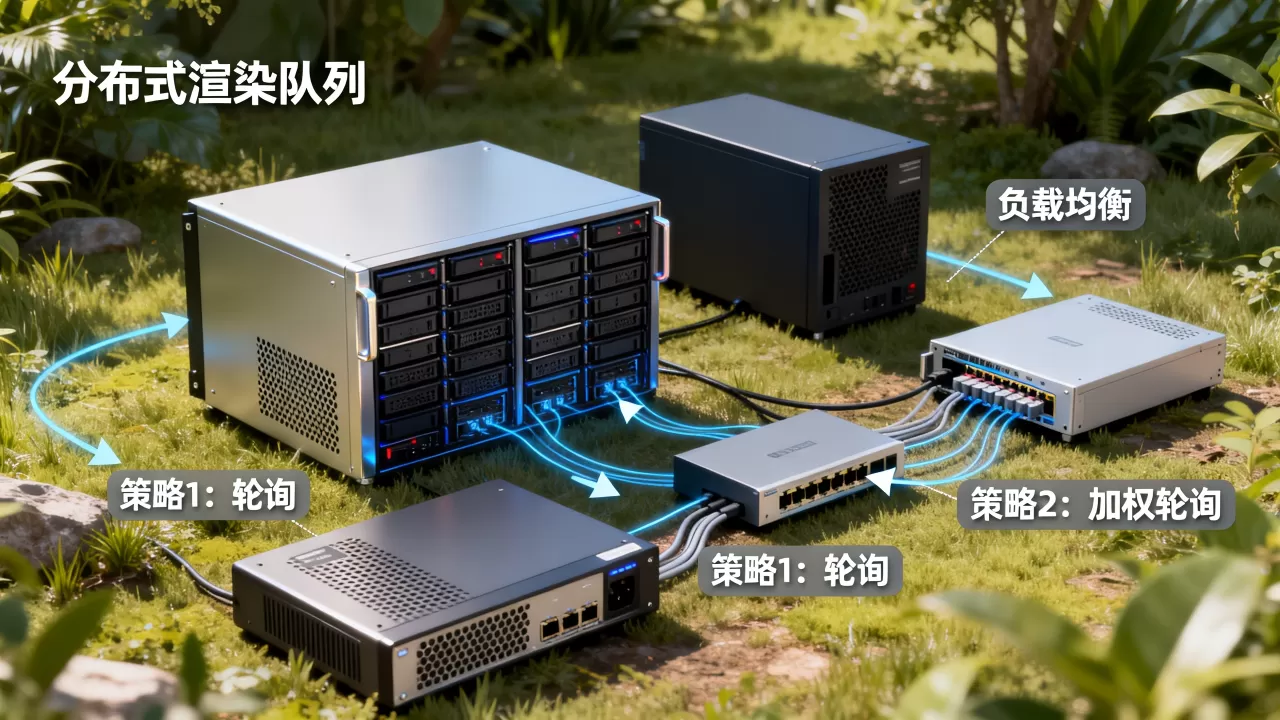
调度器每次取 score 最高的节点,权重不要写死,每隔 10 到 30 秒刷新一次,节点标签建议统一:
gpu=a100region=huadongtier=spotproject=film_a
分布式渲染队列负载均衡策略在不同场景下的落地方法
本地渲染集群:Slurm 与 OpenCue 实操
Slurm 常见于 CPU 渲染,OpenCue 适合帧渲染,可以按以下路径操作:
- 给节点打标签:
gpu=a100、region=shanghai、tier=local。 - 设置节点权重:
scontrol update NodeName=render01 Weight=100。 - 查看状态:
scontrol show node render01。 - 在 OpenCue 的 CueGUI 里给主机设置 tags 和 weight。
- 提交任务时指定依赖:
--dependency=afterok:jobid。 - 用 Prometheus 抓取队列等待时间,告警线设为团队可接受阈值。
关键点:不要让一个节点同时接太多高显存任务,显存碎片比 CPU 排队更难恢复。
云渲染农场:Kubernetes + KEDA + 消息队列
云上节点弹性强,但价格波动大,推荐路径:
- 给节点打标:
kubectl label nodes node-1 gpu=a100 region=huadong - 给渲染 Pod 设置资源请求和限制:
resources.requests.nvidia.com/gpu: 1resources.limits.nvidia.com/gpu: 1
- 用 KEDA 监听 RabbitMQ 或 Kafka 队列长度。
- 当队列深度超过阈值,自动扩容渲染节点。
- 当队列清空且空闲时间达到设定值,缩容到最小节点数。
- 用
topologySpreadConstraints把 Pod 分散到不同可用区。
命令示例:
kubectl get pods -o wide | grep renderrabbitmqctl list_queues name messages consumerskubectl describe node node-1 | grep -A5 Allocatable
华东云渲染节点与华北节点怎么选?网络延迟和成本权衡
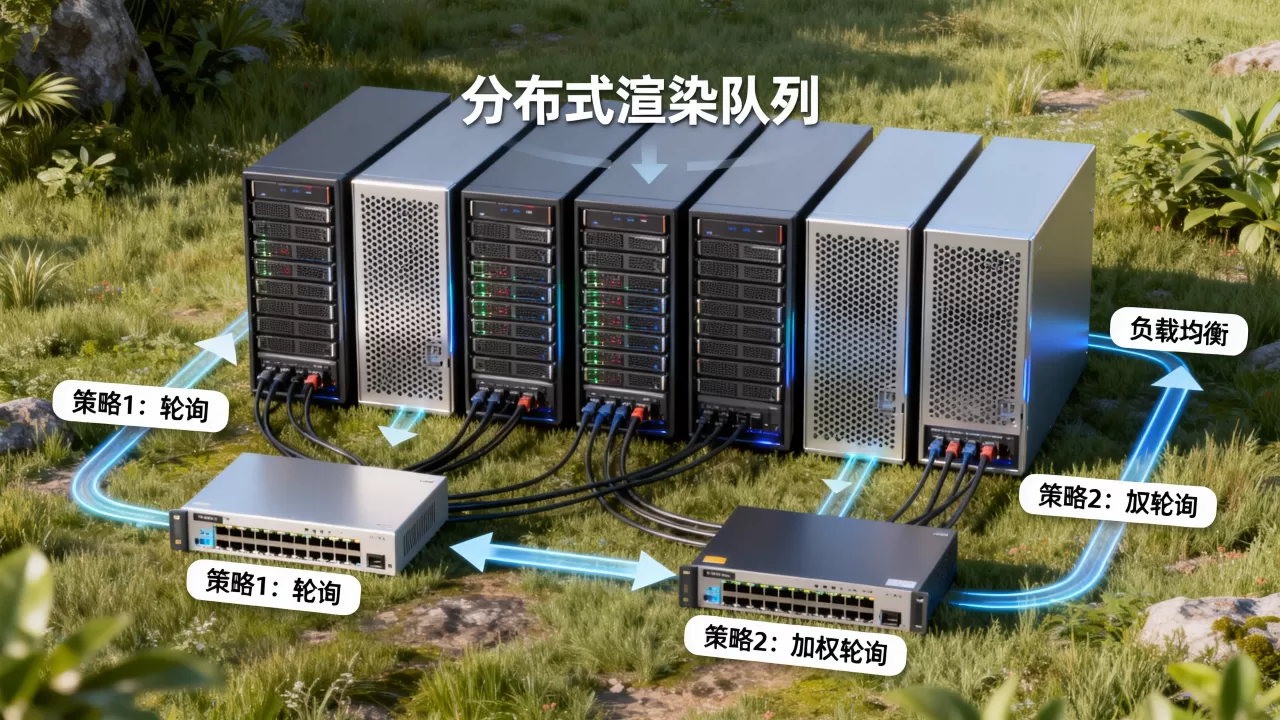
地域选择要看三点:
- 资产位置:资产在华东,优先华东节点,跨地域拉取会放大首帧时间。
- 用户提交端:北京团队提交到华北节点,控制台响应更快。
- 实例价格:不同地域电价、带宽和供需不同,抢占实例价格更低,但回收风险更高。
如果项目允许重试,可以把非紧急帧放到低价地域,紧急帧留在低延迟地域,据公开云厂商文档,抢占实例可能被回收,调度器要支持自动重排。
混合云:一致性哈希与数据亲和
混合云最怕资产反复传输,做法:
- 按项目 ID 或镜头 ID 做一致性哈希。
- 相同项目的帧尽量落到同一批节点。
- 节点本地缓存资产,命中后减少 NAS 或对象存储压力。
- 热点项目单独开队列,避免拖垮公共队列。
背压水位线怎么设置
队列不能无限增长,可以设两级水位线:
- 软阈值:队列深度达到节点数乘以并发帧数时,暂停普通队列,优先紧急帧。
- 硬阈值:继续增长时,拒绝新任务并返回重试时间。
- 同时监控失败率,失败重排过多时,先降并发,再查资产和驱动。
分布式渲染队列负载均衡策略价格怎么算?地域节点与实例类型影响
成本构成
- 计算实例:GPU 机型通常占大头。
- 存储与流量:资产上传、下载、跨地域复制。
- 调度器与中间件:Redis、RabbitMQ、Kafka 的托管费用。
- 失败重试:任务失败重排会浪费节点时间。
- 闲置成本:扩容后没任务,节点空转。
省钱的三个操作
- 队列分级:紧急队列用按需实例,普通队列用抢占实例。
- 资产预缓存:在低峰期把常用资产推到节点本地。
- 背压限流:当队列超过阈值,暂停接收新任务,避免无限扩容。
业内专家指出,渲染农场的成本优化,往往不是砍单价,而是减少失败重试和空转。
价格对比思路
| 实例类型 | 成本特点 | 适合任务 |
|---|---|---|
| 按需实例 | 稳定、单价高 | 紧急帧、交付前 |
| 抢占实例 | 单价低、可能回收 | 可重试的批量帧 |
| 预留实例 | 长期便宜 | 稳定基线负载 |
| 本地节点 | 沉没成本低 | 日常中等负载 |
分布式渲染队列负载均衡策略常见问题解答
分布式渲染队列负载均衡策略一定要用一致性哈希吗?
不一定,一致性哈希适合资产强亲和场景,如果任务是短小、无状态、资产已缓存,用最少队列或资源感知更简单,强上一致性哈希,反而可能让热点节点难疏散。
小团队没有 Kubernetes,怎么实现负载均衡?
可以用 Redis 加简单调度脚本,步骤:
- 每个节点定时上报
cpu_idle、gpu_free、queue_len。 - 调度器用
ZADD render_queue score job_id入队。 - 工作节点用
ZPOPMIN取分数最高的任务。 - 调度器按节点分数分配,分数低时暂停派发。
- 用
rabbitmqctl list_queues或 Prometheus 做基础监控。
分布式渲染队列负载均衡策略和普通 Web 负载均衡有什么区别?
普通 Web 请求通常短、无状态、超时要求高,渲染任务耗时长、吃 GPU、依赖资产、失败成本高,Web 负载均衡可用最少连接,渲染队列更适合资源感知、队列深度、任务亲和和背压组合,渲染任务一旦启动,中途迁移代价很高,所以调度时要预留资源余量。
分布式渲染队列的负载均衡,本质是把合适帧放到合适节点,先打标签、采指标、设动态权重,再用背压保护集群,通常比换更贵的机器更有效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/697897.html