实时渲染预览对网络延迟的敏感度极高,核心答案:当交互延迟超过100ms,用户就能清晰感知到“画面跟不上操作”,而在VR头显等强交互场景中,延迟超过50ms就可能引发晕眩。
实时渲染预览对网络延迟的敏感度到底有多高?
实时渲染预览和普通视频播放有本质区别,视频可以缓冲、可以快进,但渲染预览的每一帧都是“根据你当前的操作现场算出来的”你转了一下视角,服务端要把这个指令收回去,重新渲染一帧,再通过网络传回来,这个过程走完的时长,就是你能感知到的延迟。
人类对交互延迟的感知阈值,行业共识认为在100ms左右,也就是说,从你按下鼠标到画面出现反应,这个间隔一旦超过0.1秒,大脑就会开始意识到“不对劲”,这和平常看网页等待2秒不一样那是等待,而实时渲染预览是“对话”,你一开口对方就接了话茬才是正常,对方沉默三秒再回复,这对话就进行不下去了。
具体到实时渲染预览,延迟敏感度还被进一步放大,原因有二:
- 渲染是逐帧计算而非流式播放,服务器必须等你的操作指令到达后才生成下一帧,没法提前预判你的动作。
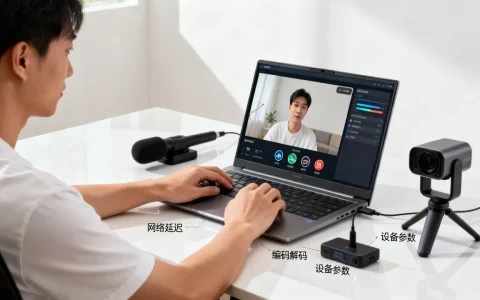
- 交互闭环里有三段延迟在叠加,指令上行传输、服务器渲染计算、画面下行回传,任何一段波动都会直接体现在预览体验上。
所以很多人误以为“网络延迟高一点没关系,顶多多等一秒”,这个认知在实时渲染预览场景下完全行不通。
实时渲染预览多少延迟算正常?分场景谈标准
不同交互强度对延迟的要求差距很大,业内专家指出,实时渲染预览的延迟指标不能一刀切,要看用户操作频率和反馈实时性。
| 场景 | 可接受延迟参考 | 超过多少会明显感知 |
|---|---|---|
| 本地局域网渲染预览 | 20-40ms | 超过80ms拖拽感明显 |
| 跨地域云渲染(轻度查看) | 50-80ms | 超过100ms操作脱节 |
| 云端VR/AR强交互 | 低于30ms | 超过50ms晕眩感加剧 |
| 协同设计评审(多人连线) | 80-100ms | 超过150ms语音与画面不同步 |
上表的数值不是拍脑袋,而是基于交互设计与实时渲染领域的通用测试经验,近年来,随着云渲染服务商把节点下沉到边缘,跨地域方案已经能稳定压到30ms以内,但前提是选对节点和网络线路。
如果你正在用实时渲染预览且感觉卡,先别急着怪显卡多数情况下,网络延迟才是那个“看不见的瓶颈”。
实时渲染预览卡顿原因定位:网络还是渲染?
要解决问题,先分清卡顿来源,方法其实很简单:盯住服务端的渲染帧率(FPS),同时用命令测网络延迟。
操作路径如下:
- 在服务端渲染软件里打开帧率监控面板(如UE5的
stat fps、Unity的Profiler),记录空闲时的渲染帧率。 - 在同一局域网内用另一台设备远程预览,记录体验。
- 再换到公网环境,用
ping和mtr命令测同一条链路的延迟与丢包。
对比三组数据就能定位:如果局域网流畅、公网卡顿,问题在网络;如果局域网也卡,问题在渲染性能。
渲染侧性能不足
云服务器GPU规格不够,或者场景模型面数太高、光照烘焙没做好,渲染一帧就需要200ms以上,延迟自然爆表,这种情况和网络无关,优化重点在模型减面、LOD(细节层次)、预烘焙光照。
网络链路质量差
公网传输存在“最后一公里”问题,你的云渲染服务部署在北京,用户在广州,物理距离就决定了基础延迟在几十毫秒量级,再加上跨运营商互访(电信到联通)、国际链路绕路,延迟轻松翻倍。
编码与传输协议开销
画面回传需要编码压缩,如果用的是软编码或者编码参数设太高,解码耗时不可忽略,据公开测试数据,H.265编码在部分低端设备上会产生比H.264更明显的解码耗时,多出十几毫秒不算罕见。
云渲染延迟高怎么解决?实操级优化路径
先把结论摆出来:云渲染延迟高怎么解决,核心策略是“就近部署+链路优化+协议升级”三管齐下,以下步骤可以直接照着操作:
- 检查当前延迟基线,在本地终端执行
ping目标渲染服务器IP,连续测30包,确认平均延迟和抖动。 - 用路由追踪定位丢包节点,执行
mtr查看每一跳的延迟变化,找到抖动异常的路由节点,反馈给网络运维或云服务商。 - 把渲染节点迁到离用户最近的地域,国内常见的云渲染部署地域选华东或华南,华北用户选华北节点,目标是把物理距离压到500公里以内。
- 开通BGP多线网络,避免单一运营商线路,BGP会自动优化跨网路由,对电信、联通、移动三网用户都能给出最优路径。
- 升级到QUIC或WebRTC低延迟传输,基于TCP的传输存在队头阻塞,一丢包就触发重传,延迟飙升,换成UDP家族协议能显著缓解这个问题。
- 调整编码参数,分辨率降到1080p以下、码率选用动态档位、预览用H.264替代H.265(低端设备解码快),帧生成时间能缩短不少。
VR看房延迟高体验差,问题卡在头显和服务器之间
把上面的原则套进真实场景,VR看房延迟高体验差是典型的延迟敏感案例,用户在虚拟样板间里每走一步、每转一次头,头显的陀螺仪都在高速采样,画面必须在一帧内跟上视线方向,体验层面的硬指标是,VR交互延迟一旦超过50ms,视觉和前庭感知就会打架,用户十几秒内就会头晕。
看房场景的特殊性在于:用户分布在全国各地,而渲染服务经常集中部署在特定机房,这就出现一个尴尬局面北京的机房渲染得很好,但广州的用户戴着头显走一圈,转头动作和画面更新之间隔了相当长的延迟,头晕得厉害。
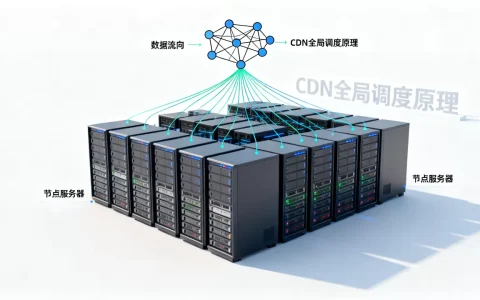
解决这类问题不只有换服务器一条路,业界通用做法是边缘云渲染:在目标用户所在城市部署轻量渲染节点,把基础延迟压到20ms以内,再配合预测渲染技术(根据用户头部动势预生成画面帧),整体体验就和本地跑差不多了。
实时渲染预览的底层逻辑决定了它比任何网络应用都更在意延迟:能用和好用之间的分水岭,就在那几十毫秒里,把延迟从120ms压到60ms,体验提升远超把渲染帧率从30提到60用户不一定看得懂帧率,但手眼是否同步,一秒就能感知。
实时渲染预览延迟问题,看这几个高频疑问就够了
实时渲染预览网络延迟多少算正常?
分场景回答更准确,局域网内的远程预览正常基线在20-40ms;跨地域云渲染在50-80ms能满足轻度查看需求;VR头显和实时联动这类强交互场景必须低于30ms,一旦超过100ms,任何形式的预览都会明显脱节,基本不可用。
实时渲染预览卡顿,为什么换了好显卡还是卡?
换显卡解决的是渲染帧率问题,但很多卡顿的根因在网络,服务端GPU算得再快,渲染出的画面也要通过网络传到你的屏幕,用局域网和公网做A/B对比测试,如果局域网流畅而公网卡,瓶颈就不在显卡上,而在网络链路的延迟和丢包。
云渲染延迟高,是选便宜节点还是加带宽?
都不是,云渲染延迟高主要受物理距离和路由质量影响,加带宽解决不了延迟问题,选离用户近的节点、用BGP网络、切QUIC传输协议,是三个最有效的方向,带宽只影响并发流畅度,不影响单帧响应时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/700104.html