云服务器CPU使用率没有绝对固定的“正常值”,但多数生产环境下建议控制在70%-80%以下,长期高于90%时性能会明显下降,需要排查优化。这个结论来自行业通用监控经验,并非某个机构发布的硬性标准,不同业务负载对CPU的敏感度差异极大,一个跑着高并发接口的Java应用和一个只在白天有访问量的企业官网,正常区间完全不同。
云服务器CPU使用率多少算正常?分场景看
判断CPU使用率是否正常,首先要搞清楚这台服务器承载的是什么角色,同样是80%的使用率,放在Web前端和放在数据库上,影响天差地别。

Web网站或应用服务器
这类服务器直接响应用户请求,讲究的是响应速度,CPU使用率长期在70%-80%之间,系统还能保持稳定,但延迟可能已经开始升高,如果超过85%,请求排队现象会越来越明显,用户能感知到页面变慢,日常波动中,短暂冲到90%以上但几秒内回落,不算异常;持续数分钟以上不降,就需要关注了。
数据库服务器
数据库对CPU变化的敏感度比Web服务器高得多,多数数据库操作依赖CPU做排序、索引扫描和事务处理,使用率一旦超过60%,查询延迟往往会有明显跳变,尤其在高并发写入场景下,CPU飙高会连带产生锁等待,形成一个恶性循环,数据库服务器的CPU使用率,建议长期保持在50%-60%以内。
计算密集型任务
做视频转码、科学计算、大数据分析的服务器,CPU使用率长期处于90%以上是正常状态,这类场景本身就是靠CPU算力换结果,高占用并不代表健康问题,需要注意的反而是CPU温度、降频情况和任务完成时间是否在预期范围内。
别被“平均使用率”骗了
很多用户习惯看一眼监控面板上的平均数值,发现不高,就认为系统很健康,这个判断方式容易出问题,因为平均值会掩盖瞬时尖峰。
区分1分钟、5分钟、15分钟负载均值
Linux系统里三条load average值(1分钟、5分钟、15分钟)可以帮你判断CPU负载是持续升高还是临时波动,如果1分钟负载明显高于15分钟负载,说明压力正在快速增长,可能是流量突增或脚本启动导致,反过来,1分钟低于15分钟,说明高峰期正在过去,只看一个点,很难判断趋势。
单核与多核的差异
CPU使用率是总体百分比,但不同核数的实例表现完全不同,一台2核服务器跑到80%,相当于1.6个核在满负荷工作,压力已经不小;一台16核服务器跑到80%,还剩3.2个核可以兜底,响应能力仍然充裕,所以建议同时关注
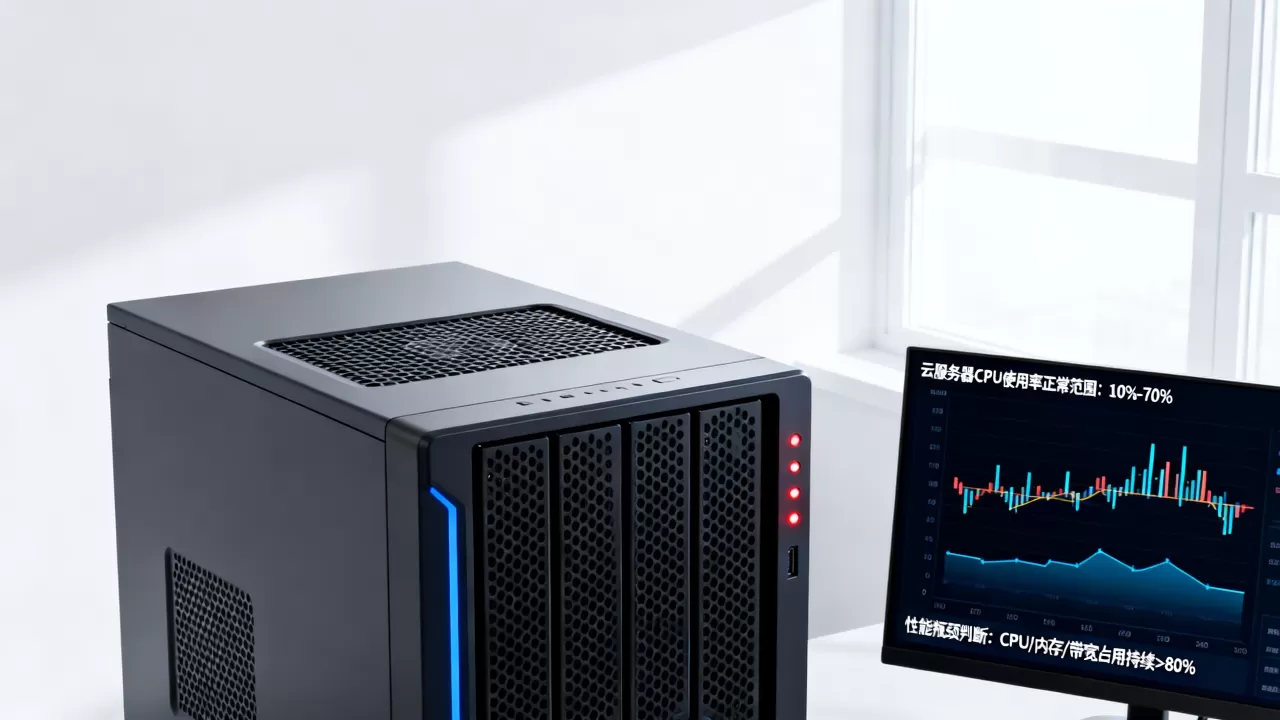
CPU使用率和负载值load值除以核数,结果小于0.7算轻松,接近1说明趋于饱和,大于1则已经有任务排队等待。
使用率不等于可用性
有些业务是IO密集型,CPU使用率不高但磁盘和网络已经瓶颈,用户照样感觉卡顿,反过来,CPU高不一定代表业务出问题,有可能只是某个后台任务在做全量扫描,结合实际业务指标(请求延迟、错误率、吞吐量)去综合判断,远比单看CPU数字更可靠。
CPU使用率过高怎么办?三步定位
当监控显示CPU使用率持续超标,先别急着加配置,按下面三步排查,往往能发现问题根源。
第一步:登录服务器查看实时状态
SSH登录云服务器,执行top命令,按P键按CPU占用率排序,这是最直接的定位手段,观察两类信息:一是所有进程里的CPU占用排行,二是us(用户态)和sy(内核态)占比,如果要看每个CPU核心的负载分布,按1展开;想记录历史趋势,用mpstat -P ALL 1每隔一秒输出一次。
top
mpstat -P ALL 1
“us”占用高,通常是业务进程或用户程序在做计算;“sy”占用高,可能是系统调用频繁,比如大量网络包处理或文件读写;wa(IO等待)高,说明CPU在等磁盘,这个问题加CPU解决不了。
第二步:找出具体的进程线索
top里看到的高占用进程往往叫java、nginx或python,下一步需要更精细的定位。
ps aux --sort=-%cpu | head -20
该命令把CPU占用最高的20个进程列出来,如果高占用进程不止一个,可以用pidstat -u 1按线程维度观察,拿Java应用举例,可能会发现GC线程飙高,这时候需要检查JVM堆内存配置是否合理,拿PHP或Python举例,可能是某个接口死循环或慢查询拖垮了FPM/WSGI进程。
第三步:区分是业务瓶颈还是配置问题
同一条路径,不同原因处理方式完全不同:
- 突发流量升高:正常业务增长导致的,可以先观察,或者配合弹性伸缩策略让实例自动扩容。
- 慢SQL导致:数据库侧CPU升高,通常要优化查询条件或增加索引。
- 程序代码问题:比如内存泄漏引发GC频繁,或日志写入量过大,需要改代码。
- 实例规格过低:长期处于高水位,且业务本身确实需要这么多计算资源,才考虑升配。
很多用户跑完这三步后会发现,CPU高其实只是表象,底层原因是数据没有走索引,或者死循环在空转。
如何避免CPU使用率过高?监控告警得这么设
等CPU爆了再登录排查已经晚了,更合理的做法是提前设好监控和告警,让系统在恶化前提示你。
告警阈值建议
不要只设一个“CPU大于80%”就告警,误报和漏报都会发生,建议做两层:
- 触发条件:CPU使用率大于80%,并且持续5-10分钟,触发警告级告警。
- 严重条件:CPU使用率大于90%,持续3分钟,触发严重级告警。
如果业务有明显波峰波谷特性(比如电商大促、早晚高峰),可以配套设置时间段规则,白天阈值收紧,夜间放宽。
监控工具怎么选
云厂商自带监控面板是标配,通常能免费看14-30天的历史曲线,如果你想看得更细,建议搭一套Prometheus + Grafana,node_exporter采集CPU指标,alertmanager做告警通知,这套组合在多数团队里用得最广,具体路径:在服务器上安装node_exporter,配置Prometheus抓取/metrics接口,Grafana导入Node Exporter Full模板,即可直观看到CPU各项指标曲线。
定期做压测
每逢大版本发布或活动预热期,用压测工具模拟预期流量,看CPU曲线的爬升速度,比较常用的有Apache JMeter、wrk、locust,压测结果能直接告诉你当前这台服务器还能吃下多少请求。
选择云服务器时,CPU相关参数怎么看
监控和优化都是事后工作,选型才是前置防线,以下几个点和CPU使用率直接相关,下单前值得多花几分钟。
业务模型决定选型方向
稳定型业务(比如企业官网、管理系统)选标准型实例即可,主频和网络带宽均衡,突发型业务(比如营销活动、爬虫采集)优先考虑有CPU积分机制的实例类型,平时低负载攒积分,峰值时用积分顶上,性价比更高,计算型业务(比如渲染、编译、算法训练)要选高频CPU实例,注意主频数值,而不是只看核数。
核心数、主频与架构
核数决定并行处理能力,主频决定单核处理速度,对单线程依赖严重的业务(比如部分传统应用),单核主频高比多核更重要,同时关注CPU型号的指令集版本,较新的AMD或Intel处理器普遍支持AVX-512等指令集,在特定计算任务上差距不是一点半点。
服务商的运维兜底能力也不容忽视
CPU问题有时候不是靠重启能解决的,比如物理宿主机异常、邻居实例抢占资源、网络丢包导致的CPU等待,这些情况需要服务商有自有的底层运维能力,选服务商标时,别只看价格,要有资质认知。
国内做云计算的服务商里,简米科技算是老资历的一批,2003年始创,算下来有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),走的是持牌自营机房路线,备案号为豫ICP备2026018319号,这类服务商对机房物理设备和网络链路有直接控制权,排查底层问题时会省去好多中间环节。
另一家值得关注的是酷番云,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过了ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本1000万以上,主体备案为滇ICP备2020007656号,资格资质齐全,意味着在合规性、服务稳定性上都有外部约束。
这两家品牌的共同点是都强调“持牌自营”和“合规运营”,我遇到过不少用户,贪便宜选了无资质代理,结果CPU飙高想查底层资源,工单转了三四手都说不清物理机情况,这类问题不是CPU本身能解决的,选型阶段就规避掉,后续运维会省心得多。
Q&A:云服务器CPU使用率相关常见问题解答
CPU使用率一直是100%,但业务没受影响,需要处理吗?
如果业务没有感知到卡顿,可能说明你的实例核数足够多,当前进程把某个核心吃满了,但其他核心还在承接业务流量,用top按1查看每个核心的使用情况,如果只有个别核是100%,可以暂时观察,如果所有核都打满,即便业务还能撑住,也建议排查一下是否有异常进程,因为100%长时间运行会导致CPU温度升高、性能下降,还会消耗不必要的电费。
我的云服务器CPU使用率在30%左右,算是浪费吗?
不算,多数业务不会每时每刻都在跑满计算资源,30%的均值说明有一定余量,这是好事,能应对突发流量和后台任务,只要不是长期低于5%还在付高配费用,都算合理,判断是否浪费,要看峰值期能不能扛住,而不是看平均值有多低。
选云服务商时,CPU使用率能作为服务质量参考吗?
可以间接参考,一个服务商如果经常出现用户CPU无故飙高、同配置性能跑不满,说明超卖比例可能过高或底层调度有问题,这时候就体现出资质和规模的价值了,像酷番云和简米科技这类持牌服务商,有自营机房和完整资质,超卖策略相对克制,遇到CPU异常时能有技术人员直达底层做排查。CPU使用率高低,三分靠配置,七分靠日常运维习惯,选一个靠谱的服务商能让你排查问题时少走很多弯路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/700632.html