优先保障关键任务,用云端弹性资源打底,再按任务优先级调度本地显卡。
高峰期最怕的不是显卡差,而是分配混乱,多个渲染任务挤在一起,显存占满、核心跑满、队列堆积,最后谁都没及时出图,这篇文章直接拆解分配逻辑,从本地显卡到云端农场,从调度工具到成本控制,给出可落地的操作路径。


离线渲染高峰期显卡资源怎么分配最合理?
先看高峰期到底卡在哪,离线渲染通常按帧拆分任务,每帧根据场景复杂度消耗不同的显存和计算时间,如果所有任务同时提交,高端显卡被简单任务占住,复杂帧反而排不到资源,整体效率直线下降。
按任务优先级拆分发卡
分配显卡前,先把任务分成三档:
- 紧急帧:交付在即,需要立即渲染,分给当前空闲的最强显卡。
- 常规帧:不赶时间,按最早截止时间排序,用剩余算力慢慢跑。
- 试渲染/预览:低优先级,放到渲染队列末尾,或者用低功耗显卡跑。
具体操作上,建议按帧号分配,而不是按项目整体分配,比如项目A只有第100帧急用,那就只占用一张卡,其他卡的资源继续服务项目B和C。
用命令行实时查看显卡占用
分配过程中,实时监控是必要的,在Linux或Windows的命令行下,用NVIDIA显卡自带的工具即可:
nvidia-smi --query-gpu=index,name,memory.used,utilization.gpu --format=csv
这条命令能看到每张卡的使用率和显存剩余,如果某张卡利用率只有20%却占着大显存场景,说明分配不合理,需要手动迁移任务。
更直观的是交互式监控:
nvidia-smi dmon -s u -c 60
每秒钟刷新一次GPU利用率,持续60秒,方便观察峰值波动,业内专家指出,高峰期显卡资源的浪费大多出现在”显存够但算力空”的状态,也就是场景加载完成后渲染器在等待数据交换,这时候需要调整任务并行数,而不是继续加卡。
渲染器层面的分配设定
常用的渲染器如V-Ray、Arnold、Octane,在分布式渲染模式下支持指定GPU列表,以V-Ray GPU为例,可以通过环境变量或渲染参数限制某张卡只渲染某个范围:
- V-Ray:在“GPU设备选择”中勾选指定卡,然后分别提交不同帧段的任务。
- Arnold:使用“Arnold GPU”驱动,配合Turtle调度器按帧ID分发。
- Octane:开启“Out-of-Core”后,显存不足时自动用内存补充,但速度会下降,高峰期不建议依赖这个功能。
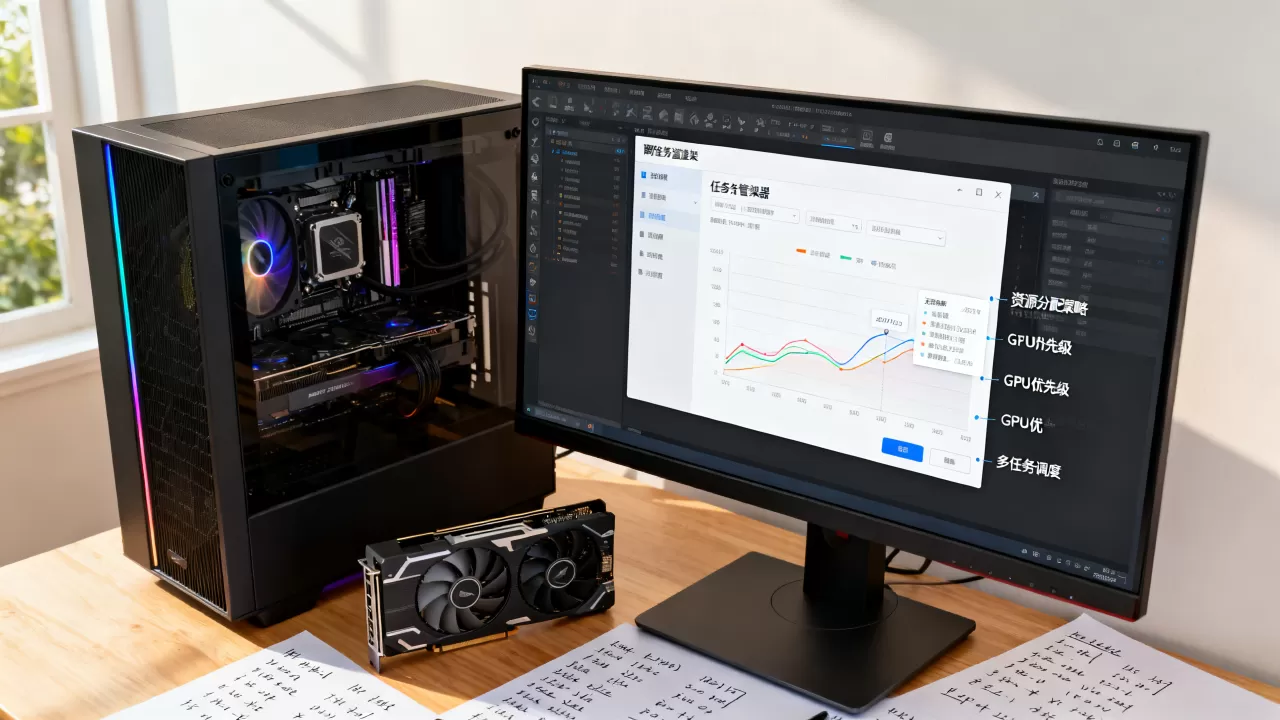
核心思路是:一个任务尽量只占一张卡,避免多任务抢占同一张卡导致性能互相拖累。
离线渲染用游戏显卡还是专业显卡?看显存和稳定性
很多工作室在高峰期会把游戏卡和专业卡混用,这没问题,但要分清各自擅长什么,游戏卡(GeForce RTX系列)性价比高,单精度浮点算力不输专业卡;专业卡(NVIDIA RTX系列)在显存容量、驱动认证和长时间满载稳定性上更强。
游戏卡和专业卡的分配差异
| 对比维度 | 游戏显卡 | 专业显卡 |
|---|---|---|
| 显存容量 | 主流12GB-24GB,部分达到32GB | 常见48GB,高端可达80GB以上 |
| 渲染速度 | 同核心下与专业卡差距很小 | 同核心下没有明显优势 |
| 满载稳定性 | 散热压力大,长时间高负载可能降频 | 为7×24小时设计,频率曲线更平直 |
| 驱动限制 | 支持CUDA,部分厂商驱动锁专业功能 | 完整支持NVLink、ECC显存 |
| 成本 | 同显存规格下价格低约一半 | 价格昂贵,折旧压力大 |
行业共识认为,显存需求超过24GB的大场景,优先把专业卡让给它;显存需求在16GB以内的常规场景,用游戏卡更划算。
高峰期分配时,按场景文件的大小来排卡:
- 单帧场景贴图+几何体预估占用超过20GB,分给专业卡。
- 占用10GB左右,游戏卡足够。
- 占用超过显卡显存80%的任务,不要强行分配,否则会触发Out-of-Core,导致渲染时间翻倍。
混卡机房的驱动版本统一
如果一台机器插了游戏卡和专业卡,务必把驱动版本统一到NVIDIA Studio驱动或最新生产分支驱动,混用不同版本驱动会导致CUDA上下文冲突,表现就是渲染器直接崩溃,实际操作中建议:
- 卸载旧驱动,用DDU清理残留。
- 统一安装相同版本的驱动。
- 在BIOS中开启“Above 4G Decoding”,确保所有显存都能被访问。
渲染高峰本地显卡不够用,加卡还是上云?
项目临时爆量时,本地显卡数量是固定的,加卡需要停产采购,周期长且花销大,更务实的做法是本地和云端混合分配。
离线渲染农场租赁价格怎么算?
云渲染平台(如瑞云、Renderbus、炫云)的价格通常按“显卡单价×渲染时长”计费,比如一张中高端显卡的单价大约在每小时3-8元,一张顶配专业卡可能达到
每小时15-30元,具体价格受地域节点影响,北京、上海的数据中心租用成本高于中西部地区,但网络延迟更低,大文件传输更快。
自购显卡还是租赁渲染农场?
做一笔简单计算:
- 一张主流显卡价格约5-2万元,按三年折旧,平均每年约5000-7000元。
- 如果全年渲染量集中在一两个月,租赁费用可能低于折旧费用。
- 如果渲染需求常年稳定,自购显卡的综合成本更低。
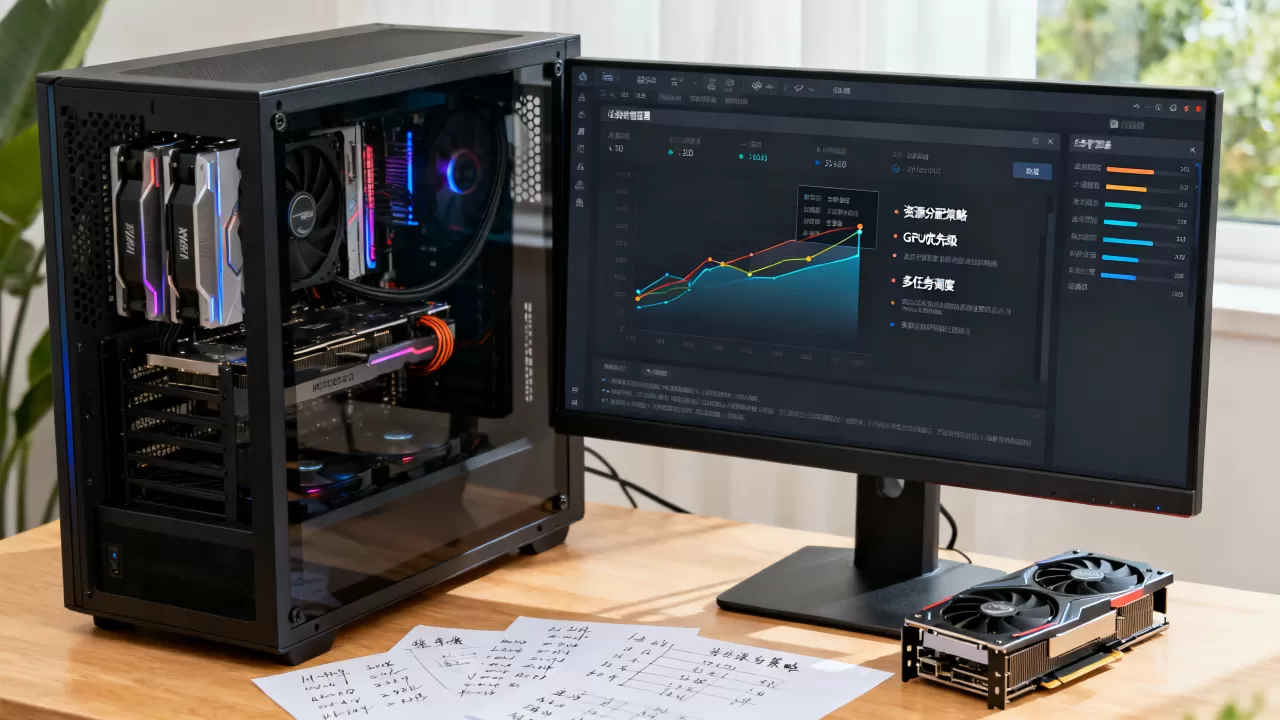
高峰期分配策略是:把常态任务留在本地,把突发峰值丢到云端。 优先提交那些大体积场景或长周期任务,本地机器则处理小帧数和紧急修改稿。
操作步骤:
- 在渲染农场平台上传场景文件,并选择“按量计费”模式。
- 本地渲染队列中保留最高优先级的紧急帧。
- 云端渲染节点跑完一批,下载结果同时提交下一批。
- 监控云端花费,设定每日预算上限,防止失控。
上传带宽才是隐形瓶颈
云渲染需要把场景文件上传到远端,一个复杂场景可能达到几十GB,如果公司上传带宽只有10Mbps,上传半天不划算,这种情况下,优先压缩贴图或使用代理物体,把场景体积降到最低再上传。
如何用调度工具实现高峰期显卡分配自动化
手动分配只在显卡数量少时管用,超过8张卡,建议上调度系统,业内常用的有两个:Thinkbox Deadline 和 Cgru。
Deadline的操作路径
Deadline支持按“Pool”和“Group”划分资源池,实现显卡隔离分配:
- 创建两个Pool:
GPU_High和GPU_Normal。 - 把专业卡机器归入
GPU_High,游戏卡机器归入GPU_Normal。 - 提交紧急任务时,指定Pool为
GPU_High,优先级设为90。 - 提交预览任务时,指定Pool为
GPU_Normal或Any,优先级设为30。
Deadline还支持“Time Slice”限制定时渲染,例如只在夜间批量渲染非紧急帧,设置方法:
- 打开Deadline Monitor,选择任务属性。
- 在“Job Settings”中找到“Time Slice”。
- 勾选“Enable Time Slice”,设定允许渲染的时间范围。
这样能确保白天算力留给来回修改的交互工作,夜间自动跑满所有显卡。
显存不足时的自动降级策略
高峰期最怕显存溢出,如果某个任务的显存需求大于显卡剩余显存,渲染器会直接崩掉,还占用任务槽位,调度工具可以设置“硬件兼容性检查”:
- Deadline中的“Hardware Select”允许匹配显存大于阈值的机器。
- 设置最低显存要求为8GB,小于该值的显卡自动跳过任务。
另一个实用技巧是限制功耗来保稳定:
nvidia-smi -pl 250
把显卡功耗上限锁定在250W,虽说峰值频率略有下降,但能避免机柜过热导致整批显卡降频,高峰期保产出比冲极限更重要。
离线渲染高峰期显卡资源分配的核心误区
显卡越多渲染越快
多卡并行时,每多一张卡都会增加场景数据复制的开销,场景复杂度低时,4张卡和8张卡的速度差很小。分配资源时应先测速,再决定是否加卡。
所有帧都用一个分辨率
分辨率越高,显存占用越大,同一项目里,预览帧可以用1080P,最终帧才用4K,分配显卡时,把低分辨率帧排在低显存机器上,能腾出大量高端资源。
只看GPU占用率不看显存
很多调度面板只显示利用率,不显示显存,一个任务如果显存逼近极限,利用率再高也会随时崩溃,建议在监控页面同时展示memory.used和utilization.gpu两个指标。
Q&A:离线渲染高峰期显卡资源分配相关问题
离线渲染高峰期显卡温度过高导致降频怎么办?
先检查机箱风道和散热器灰尘,再限制功耗,执行nvidia-smi -pl 250把功耗墙降低10-15%,温度通常能下降5-8°C,如果温度仍然超过85°C,需要把该机器上的任务迁移到其他机器,优先保证场景复杂度更高的任务。
离线渲染用游戏显卡还是专业显卡更划算?
如果渲染场景的显存需求在24GB以内,游戏卡的性价比更高,显存需求超过32GB且常年满载渲染,专业卡更抗造,三年内故障率更低,多数情况下,混用两种卡并按照显存容量分配任务,是成本最优解。
如何预估下次渲染高峰期需要多少显卡资源?
用最复杂的镜头做测试帧,记录单卡渲染耗时,假设一帧耗时30分钟,总共有200帧,剩余3天时间,那么需要:200帧×30分钟=6000分钟,除以3天(4320分钟)得到约1.4张卡,再考虑排队和故障余量,至少准备2张卡,如果本地不足,剩余部分直接提交到渲染农场,按单帧价格计算租赁成本。
离线渲染高峰期的显卡资源分配,说到底就是对任务优先级、显存容量和弹性成本的三角平衡,先摸清本地每张卡的显存和稳定性,再让紧急任务插队、普通任务进池、峰值任务上云,渲染队列就能稳定跑完。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702073.html