成都渲染任务积压时,与其排队等本地渲染农场,不如直接租GPU服务器分担压力,按小时计费、即开即用,是目前性价比最高的应急方案。渲染任务积压不只是等多久的问题,它意味着项目节点可能延期、加班成本直线上升、客户信任开始动摇,尤其在成都设计公司和影视后期团队里,一台机器跑一帧动画要几十分钟,几百帧堆在一起直接卡死整个流程,下边这套租GPU服务器的思路,来自我处理过的大量真实案例,照着做能让你在半天内把积压任务分流出去。
成都渲染任务积压怎么办?租GPU服务器是最直接的解法
积压的本质是算力需求瞬间超过本地供给,成都本地的渲染农场虽然存在,但繁忙时段同样要排队,而租用云端GPU服务器相当于临时租借一块“算力电池”,不占用采购预算,也不需要等物流。


关键动作是“先分析积压类型,再选对应算力”,如果你是单帧渲染极慢,比如打光复杂、材质反射次数高,那需要更高主频的GPU;如果你是帧数太多、任务清单排到三天后,那需要增加GPU数量并行渲染。
成都渲染任务积压怎么解决?先分清算力瓶颈
打开你的渲染日志,看一眼任务队列:
- 如果单个文件渲染时间异常长,优先提升单卡性能,比如从RTX 3060升级到RTX 4090或A6000。
- 如果每个文件渲染时间正常,但总文件数量巨大,优先增加机器数量,用多台机器同时渲染不同帧。
- 如果本地网络上传慢,优先用支持内网传输的云方案,或者用数据快递方式上传素材。
摸清瓶颈之后,租GPU服务器的方向就清楚了,不要盲目租最贵的卡,浪费钱。
租GPU服务器的实操步骤:从上传到出片全流程
这里以最常见的Blender Cycles渲染为例,其他软件类似:
- 选择支持GPU渲染的云平台,注册账号并完成实名认证。
- 创建渲染节点,选择显卡型号,优先选带足够显存的卡,比如24GB以上,因为复杂场景容易出现“爆显存”。
- 配置渲染软件环境,多数云平台提供预装镜像,选“Blender 3.6 + RTX 4090”这类组合即可,没有现成镜像就手动安装驱动和插件。
- 上传项目文件,用平台自带的上传工具,或者挂载对象存储,这里提醒一句:大文件压缩成zip上传能节省一半时间。
- 启动渲染节点,把渲染引擎切换到GPU,设置输出格式,点“渲染动画”。
- 渲染完成后,直接从存储桶取回成品,或者让平台生成下载链接。
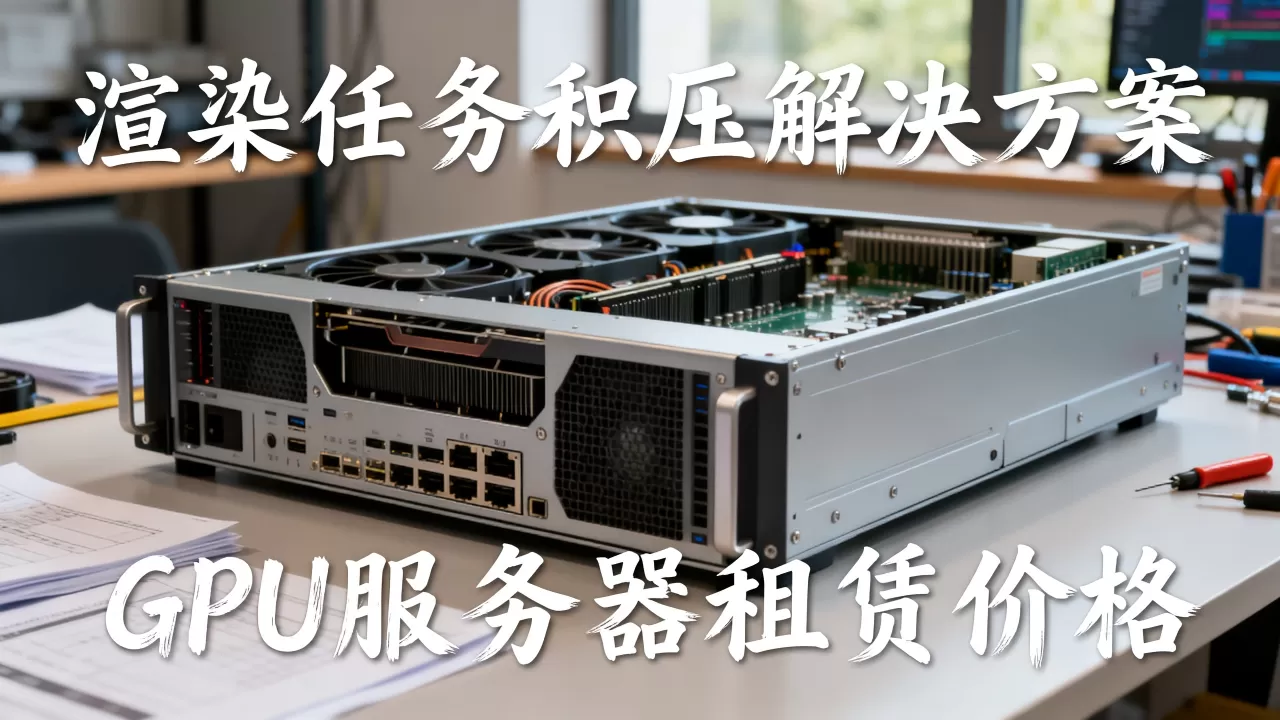
这套流程走完,你不需要改项目文件里的任何东西,只把输出路径换成云端路径就行,实操经验是:先在云端渲染一帧,确认效果没问题再批量丢进去。我见过不少人一上来跑全片,结果材质贴图路径错误,整批白渲,浪费了几小时租金。
成都渲染农场GPU服务器价格对比:按小时租和包月哪个划算
这是所有成都团队最关心的问题,我的观点很直接:积压救急用按小时租,长期固定项目用包月。
成都本地渲染农场GPU服务器价格受显卡型号、租赁时长和带宽影响,没有统一标准,按小时价格通常比包月折算价高,但胜在按量付费,不用时随时释放,包月适合已经稳定有渲染需求的团队,相当于请一个公用“渲染力”回来。
| 计费方式 | 适合场景 | 优点 | 缺点 |
|---|---|---|---|
| 按小时租 | 突发积压、项目冲刺、临时补帧 | 灵活释放,资金占用低 | 单价偏高,长时间用不划算 |
| 包月租 | 持续渲染、固定出片节奏 | 折算下来成本更低,随时有机器 | 闲置时也付费,管理要求高 |
| 竞价实例 | 对时间不敏感的海量渲染 | 价格极低,能省不少钱 | 可能被中断,需要任务断点续跑 |
如果你手上有明显淡旺季,建议旺季租几台按小时的机器,配合本地机器一起出图,不用改变原有工作习惯。
成都本地渲染服务器租赁的隐藏成本:别忽略这三项
价格不只是租GPU服务器本身的花销,还有三个容易踩的坑:
- 上传下载流量费:几十GB的序列帧传回本地,流量费可能超过机器租金,下单前看云平台是否免流量,或者内网传输是否免费。
- 存储费:渲染中间文件、临时缓存、输出文件都占空间,建议设置自动清理,或者只保留最终结果。
- 调度损耗:多台机器同时渲染时,任务分配不均会导致部分机器空闲,用带渲染管理器的平台(比如Deadline或自研调度)能减少这种损耗。
成都GPU服务器租用哪家好?关键看这三项指标
“哪家好”没有标准答案,但有一个行业共识可以参考:渲染任务的可控性比绝对性能更重要。平台响应速度、故障恢复能力和售后支持,直接决定你能否在截止日前交片。
成都GPU服务器租用哪家好?先看显卡型号和显存
渲染最怕显存不够,同样一颗GPU,显存版本不同,能处理的场景复杂度差别很大,在成都本地找租赁服务时,主动跟客服要“具体显卡型号+显存大小”,不要只看“高性能GPU”这类模糊描述。
再测网络和调度系统:用一条命令验证
租到机器后,先跑一条命令确认显卡状态:
nvidia-smi
这条命令能显示GPU型号、温度、显存占用,如果显存显示只有几GB,说明机器跟你预期不符,马上退款或换机。
然后做一分钟渲染测试:用你项目里最复杂的一个场景,设置渲染单帧,记录时间,如果测试帧耗时是本地机器的1.5倍以内,说明性能正常;超过2倍就要检查驱动或者换机器。
服务商的本地化支持:成都团队别忽略时差问题
租GPU服务器时,优先找客服响应快的平台,成都很多团队喜欢晚上渲染、白天改片,如果后半夜机器出故障,联系不上人就麻烦了,据行业经验,事故发生时能不能在半小时内重启节点,决定了你的项目会不会延期。
成都渲染任务积压租GPU服务器常见问题
问:租GPU服务器渲染跟自己买显卡比,哪个更省事?
如果只看那一两个月的积压任务,租机器贵不了多少,但省了装机、调试、维护的精力,自己买卡要等货、要改电源、要装驱动,一旦任务结束显卡就闲置了,租GPU服务器把“拥有”变成“使用”,算力用完就还回去,不留折旧包袱。
问:用云GPU渲染会不会导致文件泄露?
正规平台有隔离权限和网络隔离,你上传的场景文件只有你的账号能访问,渲染完毕后,删除节点和存储桶里的数据即可,选择平台时看有没有“数据删除确认”机制,或者用支持私有部署的方案,多数情况下,泄露风险跟你用移动硬盘传递文件时差不多。
问:成都本地有没有可以快速上门的渲染农场?
成都确实有不少本地渲染工作室,但高峰期同样需要排单,而且物理机数量固定,临时加单很难,租云GPU服务器的意义是突破物理限制,让算力弹性扩展,你不需要等本地机器空闲,只要网络带宽允许,云端随时能开工,最终结论很简单:任务积压不是等出来的,把任务拆开,租几台云GPU并行跑,今晚就能看着进度条往前走,成都的设计团队和后期公司,只要把第一次云端渲染流程跑通,后面再遇到高峰就会很自然地去按小时租机器,而不是干着急。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702294.html