渲染农场批量出图时,规划GPU算力的核心不是堆卡数,而是算清“单帧耗时、并发任务量和工期预算”三者之间的关系,再决定租多少卡、租什么卡、怎么排队。
批量出图为什么比单帧渲染更吃算力规划
单帧渲染看的是单卡性能,一块RTX 4090渲染一张4K效果图可能只要十几分钟,换一块老显卡就得磨蹭一晚上,但批量出图完全是另一套逻辑你手里有300帧要出,一帧快两分钟和一帧快三十秒,最终的总耗时差距被放大到了几小时甚至几天。


行业共识认为,批量渲染的成本瓶颈往往不在硬件本身,而在算力闲置,GPU在排队等任务的时候不产生任何价值,但租金照付,规划批量出图的GPU算力,本质上是回答一个问题:在工期允许的范围内,怎样让每一张卡尽可能满负荷运转,同时不花冤枉钱。
很多团队一上来就按“总渲染量”去估算机器数量,结果发现几十台机器同时开工,存储带宽和调度系统反而先崩了,GPU算力规划从来不是单纯的硬件题,而是按项目量级、帧分辨率、渲染器特性、时间节点倒推出来的组合方案。
先分清本地渲染农场和云渲染农场的算力差异
本地渲染农场的算力天花板
本地渲染农场是很多工作室最早接触的批量出图方案,几台高配主机加一个局域网调度软件,白天做灯光、调材质,晚上全部切到渲染模式,这样做的优势是机器复用率高,设备折旧成本摊薄后单帧价格比较低。
但本地农场的算力天花板也很明显,机器数量受场地和电力限制,扩到二三十台已经是极限,遇到大型建筑动画项目,动不动几千帧的工程量,本地机器连续跑一周也未必赶得上交付节点,而且GPU长期满载运行,散热和稳定性都是隐患,一块显卡中途温度过高崩掉,会拖累整个批处理队列。
行业里不少团队在做“渲染农场和本地渲染的区别”评估时,都会算一笔综合成本账,包括电费、维护、人工盯机的时间成本,把这几项加进去以后,本地农场的单帧成本并没有想象中那么便宜。
云渲染农场的弹性算力调度
云渲染农场的思路刚好解决的是算力弹性的问题,需要2000张卡跑一晚上,机器数量可以随时扩;项目结束以后释放资源,零闲置成本,按需付费的模式让很多中小型工作室不用再负担几十万的一次性硬件投入。
不同云渲染平台对GPU的调度策略不太一样,有些平台走的是“抢单模式”,你上传任务以后自动分配机器,按渲染时长计费;有些平台允许指定机型、指定排队优先级,适合工期特别紧的项目,规划云渲染算力时,要重点确认的是:平台有没有批量提交功能、能不能支持单帧超时自动重派、中断任务能不能从缓存续跑。
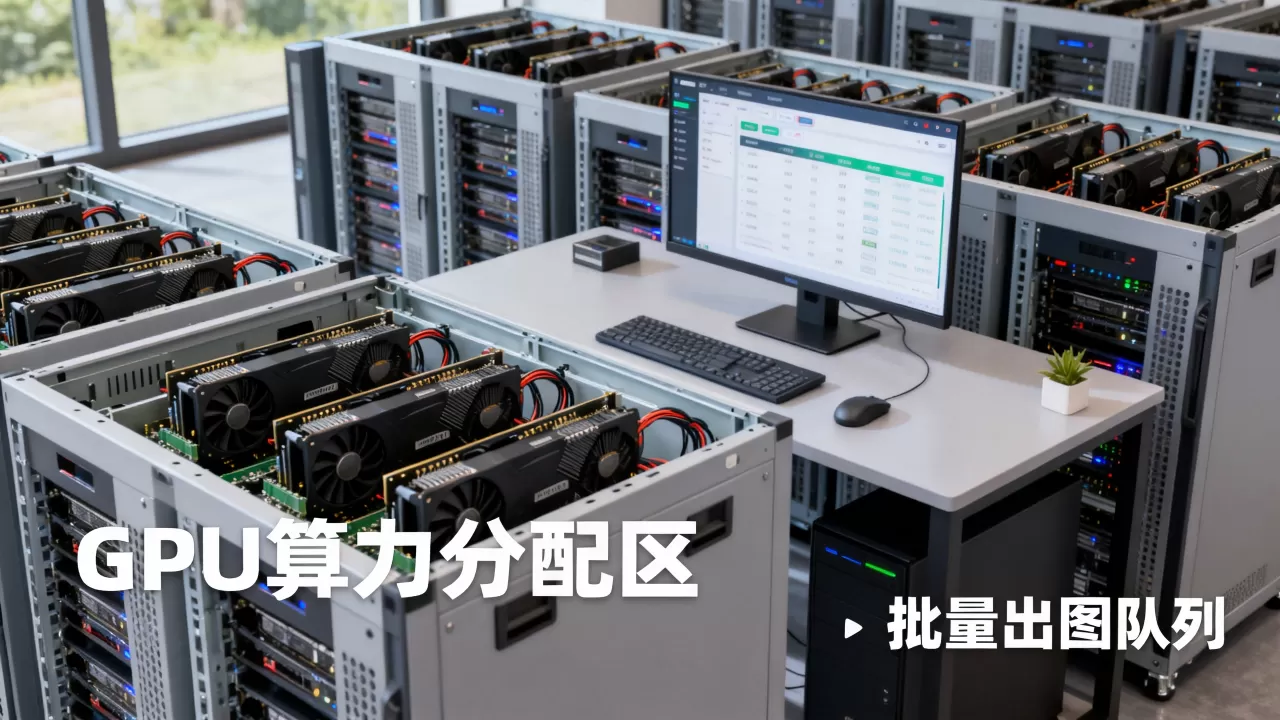
批量出图时怎样规划GPU算力的核心计算逻辑
用帧数、单帧时长和工期倒推并发卡数
最实用的算力规划方法不是问平台“你有多大算力”,而是先算清楚并发量,设项目有800帧,单帧用当前主力显卡测试渲染需要约12分钟,那就是总渲染时长9600分钟,如果交付工期只有3天,满打满算4320分钟,就需要至少3张卡并发才能跑完这还没有算上排队、上传、异常重渲的损耗。
业内专家指出,批量项目建议预留15%-20%的算力余量,因为排队等待、存储读写瓶颈、个别帧因为材质或灯光问题渲染失败需要重渲,这些隐性损耗在长跑项目中几乎必然出现,按这个余量算下来,上面那个800帧的项目,实际上最好租4-5张卡。
不同渲染器的GPU利用率差异要单独测算
GPU渲染器的算力消耗模式差异很大,以V-Ray GPU和Octane为代表的无偏渲染器,对CUDA核心数量敏感,多卡并行效率较高;Redshift这类偏向混合渲染的工具,对显存带宽和CPU辅助计算也有要求,批量出图规划算力时,不要只盯着“多少张卡”,还要看每张卡的显存是否装得下场景。
常见的一个坑是:场景贴图超大,8GB显存的显卡加载出来直接爆显存,就算有100张卡并发,也全都跑不动,规划阶段应该先用项目里最复杂的场景做单帧测试,确认显存占用量,再决定显卡型号和数量。
分辨率与输出规格影响显存占用率和渲染时间
分辨率翻倍,像素量变成原来的4倍,渲染时间并不是简单的线性增长,4K输出和2K输出对显存的需求差异很大,应用到批量出图中,直接决定了单张卡能同时跑几个任务,部分云平台支持一卡多任务并发,但显存不够的情况下强行并发,会频繁触发内存换页,渲染速度反而更慢。
批量出图任务拆分的实操策略
按帧号拆分,让每张卡专注干活
最稳定的批量任务分配方式是按帧号拆分,1-100帧由第一组机器处理,101-200帧由第二组处理,这样做好处是出错的帧可以直接定位到具体机器和场景文件,排查问题不需要翻遍整个渲染日志,拆分的粒度不宜过细,每张卡单次分配20-30帧比较合理,避免频繁的任务调度消耗时间。
分块渲染适合高分辨率大图
单帧分辨率超过8K的项目,建议打开渲染器的分块渲染功能,把一张完整画面切成若干区域分别渲染,再合成输出,这样做能有效降低单张卡的内存压力,对偏建筑可视化方向的项目来说,超高清鸟瞰图和立面大图的批量输出,分块渲染是绕不开的方案。
开启自动续跑和缓存机制防止“白渲”
批量渲染最怕的是渲染到第80%的时候机器断电,或者某个帧因为缓存不足导致引擎崩溃,所有主流渲染器都支持某种形式的缓存或恢复机制,提交任务前务必要确认这一点,云渲染平台有自动重派机制的优先选择,能在任务异常退出后从最近的有效帧或缓存位置继续,不用整帧重来,这能省下很可观的算力。
云渲染农场怎么收费?按项目量级匹配算力方案
三种主流计费模式的成本对比
云渲染农场平台的收费模式目前主要有三种:按时长计费、按帧计费、包机计费,三者的适用场景差异明显:
- 按时长计费:适合帧数多、单帧耗时差异大的动画项目,用多少算力付多少钱,弹性最大。
- 按帧计费:适合效果图、静帧这类单帧工作量相对均匀的任务,价格一目了然,方便给客户报价。
- 包机计费:适合工期非常紧、需要独占机器的项目,批量提交后不排队,但价格也最贵。
| 模式 | 适合项目 | 成本可控性 | 备注 |
|---|---|---|---|
| 按时长计费 | 动画长片、批量序列 | 中 | 闲时单价更低 |
| 按帧计费 | 效果图、室内外静帧 | 高 | 价格透明 |
| 包机计费 | 紧急交付、大项目 | 低 | 有最低时长限制 |
云渲染农场哪家便宜?看隐性成本
价格不能只看单价,还要算上排队时间和平台稳定性,有些平台单价低,但高峰期要排队等机器,等一两个小时是常事,批量出图是最怕等的,机器闲置和人工等待的时间成本,往往比那点单价差异高得多。
另一个隐性成本是存储和下载费用,部分平台在渲染结束后会收取一定的存储占用费或下载流量费,大项目几千帧渲染结果下载下来,这笔开销不算小,选平台时最好把这项也计入整体预算。
地域节点的选择也会影响算力成本
国内主要的云渲染平台都在中西部地区部署了大规模算力中心,电力和气候条件让硬件成本更低,这些成本优势会反映在终端价格上,如果你是面向华北、华东地区的客户,优先选择有本地化节点的平台,任务排队速度和文件上传效率都会高一些。云渲染农场怎么收费这个问题,不同地域平台的报价差异可以达到20%-30%,批量项目值得花时间比价。
高峰期与闲时段的价差策略
多数云平台都有明显的闲时折扣,凌晨到上午的算力价格通常比下午和晚上低不少,批量出图项目如果工期有弹性空间,把任务安排在夜间或周末自动提交,能节省相当一部分预算,有些平台还有“闲时包”的套餐,提前预定更划算,规划项目时不妨把渲染计划表和价格表放在一起排,错峰出图也是一种算力规划。
算力规划的落地清单:从测试到交付的完整路径
批量出图的算力规划不算复杂,按下面这个顺序走一遍,基本不会出大问题:
- 用项目里最复杂的场景跑一次单帧渲染测试,记录耗时时长和显存峰值占用。
- 用总帧数乘以单帧耗时,算出总渲染时长,再除以可用工期天数,得到最低并发卡数。
- 加上15%-20%的余量,得到实际需要租赁的GPU数量。
- 对比云平台的按时计费、包机计费和闲时折扣,选出成本最低的方案。
- 提交前检查渲染器的缓存、续跑和自动重派功能是否开启。
- 小批量试渲5-10帧,确认输出分辨率和材质效果正确,再批量提交全部任务。
渲染农场批量出图时怎样规划GPU算力:常见问题解答
Q1:渲染农场批量出图时怎样规划GPU算力才能兼顾成本和效率?
先做小规模测试,拿到单帧渲染耗时的基准数据,再按工期倒推并发卡数,批量出图项目中,机器类型的选择比机器数量更重要,显存不足导致的重试成本远超那点差价,错峰提交任务、利用闲时折扣,是控制成本最直接的手段。
Q2:渲染农场和本地渲染的区别有多大,什么情况下必须租云渲染农场?
本地渲染在机器数量、稳定性、后期维护上都有天然上限,遇到交付工期极短、帧数规模极大、场景文件特别复杂这三种情况,云渲染农场的弹性算力几乎是唯一选择,项目量级不大、时间充裕时,本地农场仍然有成本优势。
Q3:批量出图时GPU显存不够导致渲染失败,怎样从算力规划角度规避?
在测试阶段就用最复杂场景确认显存占用率,然后预留20%的显存余量,场景显存占用超过单卡显存容量的,选择更高显存的机器,或者开启分块渲染、纹理优化和代理对象功能,批量提交前先跑几张异常复杂帧验证稳定性,能避免大面积渲染失败的情况。
算力规划的最终目标不是算得越细越好,而是在可控成本和稳定交付之间找到平衡点,把GPU当做一个可伸缩的资源池,按需取用、动态调整,批量出图这件事就成功了一大半。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702360.html