诺瓦服务器eg1s用AI的核心方式是先安装轻量级Linux系统,再通过Docker部署大语言模型或调用云端API,整个流程大约需要1小时。
诺瓦服务器eg1s运行AI需要什么环境
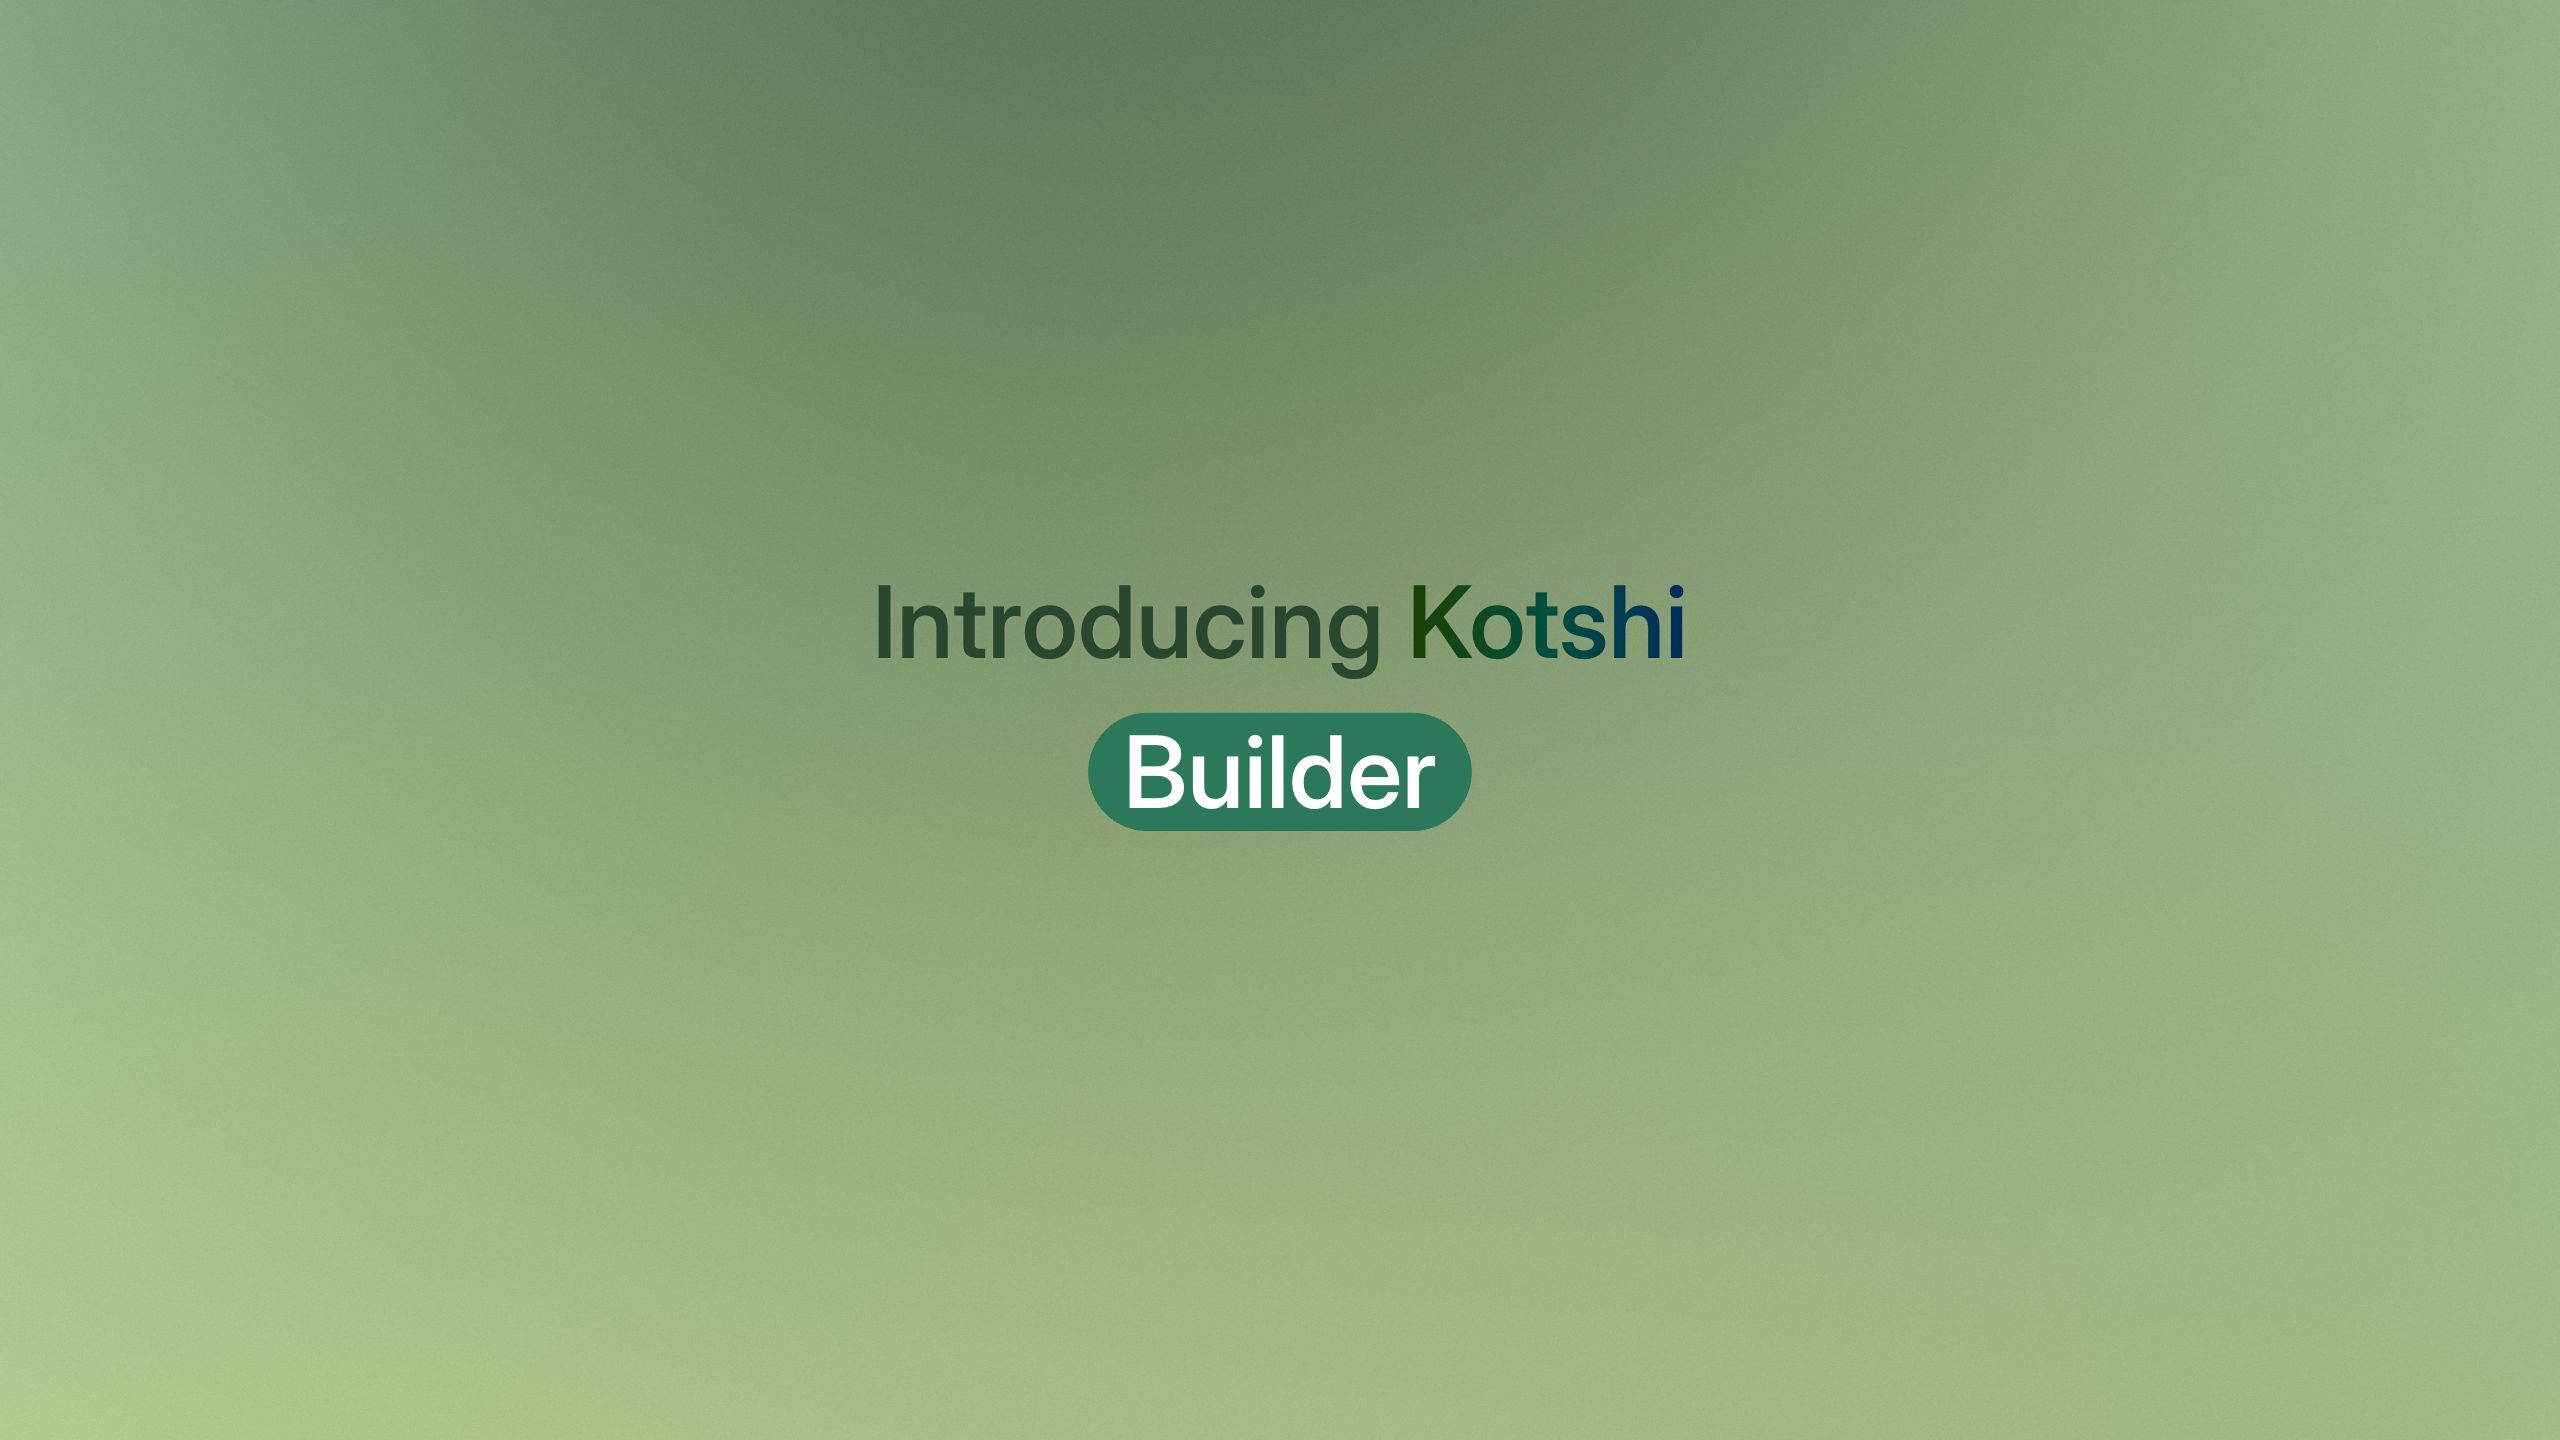
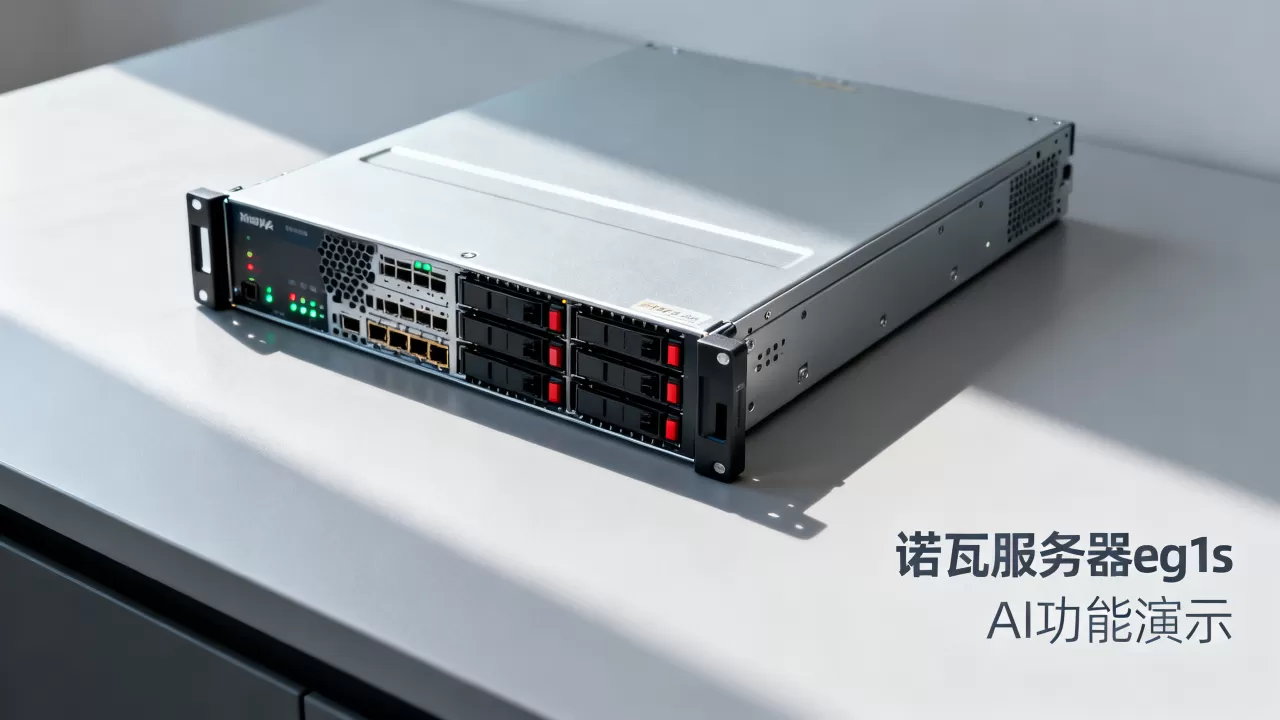
很多朋友拿到诺瓦服务器eg1s后,第一反应是这巴掌大的盒子能干点啥,从硬件定位看,它属于边缘计算网关类设备,CPU采用ARM架构,内存从4GB到16GB可选,存储支持NVMe固态硬盘,这类配置跑不了云端那种千亿参数大模型,但部署7B参数以内的量化模型或者做AI推理转发完全够用。

硬件瓶颈和扩容建议
开工前先确认你的具体型号,eg1s有标准版和高配版,区别主要在内存和NPU算力,运行AI模型最低要求是8GB内存,如果只有4GB,建议先加装内存条,存储方面,模型文件动辄几个GB到十几个GB,最好准备128GB以上的NVMe固态。
多数情况下,用户到手的是预装OpenEuler系统的版本,检查系统是否正常,终端输入free -h看内存,输入df -h看磁盘空间,如果内存低于8GB,接下来的操作会非常卡顿。
系统初始化三步走
第一步,更新系统软件源,诺瓦官方镜像源有时候速度慢,可以换成华为云或清华源,命令如下:
sudo apt update && sudo apt upgrade -y第二步,安装基础工具,AI部署离不开Python、Git、Docker,一条命令装齐:
sudo apt install python3-pip git docker.io docker-compose第三步,设置Docker开机自启。
sudo systemctl enable docker && sudo systemctl start docker完成这三步,你的eg1s就变成一个标准的AI试验场了。
诺瓦服务器eg1s本地部署大模型实操
本地部署是体验AI最直观的方式,行业共识认为,ARM架构设备最适合跑
Qwen2.5-7B-Instruct这类中文优化模型,量化版本在8GB内存下可以流畅运行。
用Ollama一行命令运行模型
Ollama对ARM架构支持非常完善,安装只需要一条命令:
curl -fsSL https://ollama.com/install.sh | sh安装完成后,拉取量化模型:
ollama pull qwen2.5:7b-chat-q4_K_M拉取时间取决于网速,模型文件大约4.7GB,拉取完成后,运行:
ollama run qwen2.5:7b-chat-q4_K_M看到对话提示符,本地AI就正式上线了,这套方案的优点是内存占用控制在6GB以内,响应速度在每秒8到12个token之间,日常问问题、写代码都够用。
使用Docker部署FastGPT做知识库
如果不想只聊天,想给eg1s挂载私人知识库,那就用FastGPT方案,Docker拉取镜像:
docker pull fastgpt/fastgpt:latest然后编写docker-compose.yml,映射3000端口,配置MongoDB和PostgreSQL作为后端存储,启动后,浏览器访问http://eg1s的IP:3000,上传你的业务文档,AI就能基于这些内容回答,这个方案对内存要求稍高,建议16GB版本,否则多轮对话后容易出现内存溢出。
诺瓦服务器eg1s通过云端API调用AI的省钱玩法
本地部署不是唯一选择,对于只有4GB内存的低配版eg1s,更适合做AI请求转发网关,让eg1s统一接管各种API请求,局域网内所有设备都能共享AI能力。
配置One-API聚合接口
One-API是一个开源的API网关项目,支持OpenAI、Claude、Gemini等多家服务,在eg1s上部署后,你只需要一个统一入口,按需路由到不同大模型。
docker run -d --name one-api -p 3001:3000 -v /data/one-api:/data justsong/one-api
然后在管理后台配置你的各家API Key,设置转发策略,之后,内网里的电脑、手机调用AI,地址都填http://eg1s:3001,这个玩法不消耗eg1s本地算力,只做网络转发,几十元的月电费就能满足全屋设备使用AI。
应用场景:家庭智能终端
我就在eg1s上跑了一个Telegram机器人,用户发消息给机器人,机器人通过One-API把问题抛给云端大模型,再把回答转回来,整个过程eg1s的CPU占用率不到15%,性能绰绰有余。
诺瓦服务器eg1s调用AI性能优化技巧
使用过程中遇到卡顿是常态,掌握几个优化点能明显改善体验。
调整交换分区和系统参数
当内存吃紧时,系统会启用Swap,传统Swap在固态硬盘上效率偏低,建议改用ZRAM:
sudo apt install zram-tools
echo "ALGO=zstd" | sudo tee -a /etc/zramswap.conf
echo "SIZE=2048" | sudo tee -a /etc/zramswap.conf
sudo systemctl restart zramswap
压缩后的内存交换可以缓解模型加载时的爆内存问题。
启用GPU或NPU加速
如果你手里的eg1s带NPU模块,用npu-smi info查看算力状态,Ollama默认不调用NPU,需要修改服务参数,在/etc/systemd/system/ollama.service中添加:
Environment="OLLAMA_DEVICES=/dev/npu0"然后重启服务,根据诺瓦技术社区反馈,启用NPU后,7B模型的推理速度可以提升2到3倍。
关闭不必要后台服务
预装系统开了不少用不到的服务,检查并关闭它们:
sudo systemctl disable bluetooth
sudo systemctl disable cups
sudo systemctl disable alsa-restore.service
每关一个服务,就省下一部分内存给AI模型。
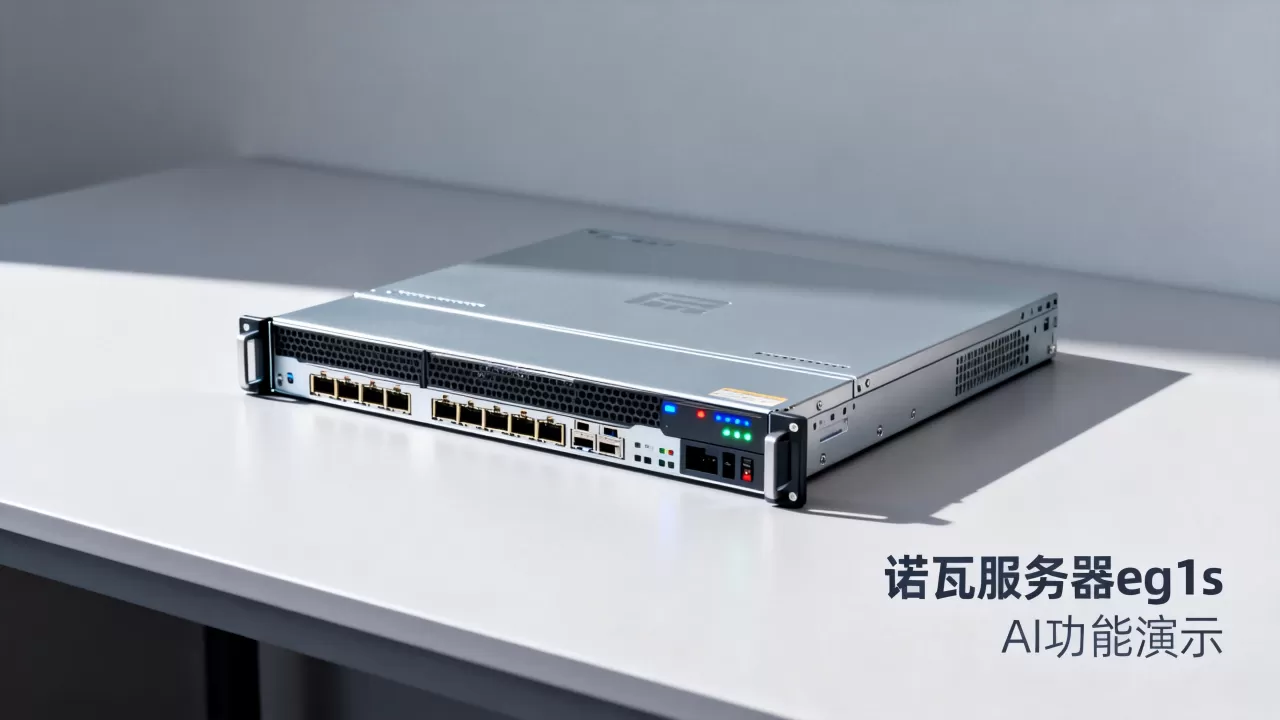
诺瓦服务器eg1s在办公场景下的AI典型玩法
除了技术发烧友,普通办公用户也能让eg1s变成生产力工具。
智能会议纪要生成器
连接USB麦克风到eg1s,部署开源的Whisper语音识别模型,开会时录下音频,扔给eg1s转成文字,再让本地Qwen模型生成摘要和待办事项,整个过程离线运行,不出内网,保密性比云端工具强得多。
定时数据报表助手
用Cron定时任务,每小时让eg1s调用AI分析日志文件,发现异常自动通过钉钉机器人推送,这个方案成本极低,却能把运维人员从重复劳动中解放出来。
诺瓦服务器eg1s部署AI的常见问题解答
诺瓦服务器eg1s能跑Stable Diffusion画图吗
可以,但速度不理想,eg1s的算力跑Stable Diffusion生成一张512×512图片大约需要3到5分钟,配合OpenVINO优化,速度能提升一倍,建议只处理简单图标和插画,复杂画面还是交给云端GPU。
诺瓦服务器eg1s部署AI一般需要花多少钱
本地部署零成本,只要付电费,云端API按量付费,以GPT-4o mini为例,每百万输入token约合人民币1元,日常聊天一个月花费在10元以内。
诺瓦服务器eg1s和树莓派5比哪个更适合AI
关键看内存和NPU,树莓派5最高8GB内存,无NPU,跑7B模型很吃力,eg1s高配版支持16GB内存和NPU,综合性能接近前者的2倍,但价格也高一些,预算有限选树莓派,追求本地AI体验选eg1s。
诺瓦服务器eg1s用AI的真谛在于把边缘算力玩到位,先评估自己的内存版本,8GB以上走本地部署,4GB就做API网关,无论哪条路,这套设备的稳定性和低功耗都让它成为家庭和中小企业最容易上手的AI硬件,去实践吧,你会发现小盒子也有大能量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702918.html