纳管服务器设备,简单说就是能被统一管理平台集中监控、配置、运维和调度的物理服务器、虚拟机和云主机,其核心价值在于消除信息孤岛,实现IT资源的自动化与可视化管控。
这里的“纳管”强调的是一种主动的、统一的管理能力,而不是单纯的“连接”,你问的这个问题,很多做运维和IT采购的朋友都关心,因为上不上纳管系统,直接关系到机房能不能睡得着觉,下面我直接按设备类型和场景给你拆开讲。
按硬件形态划分:哪些物理设备算“纳管对象”
x86机架式与塔式服务器
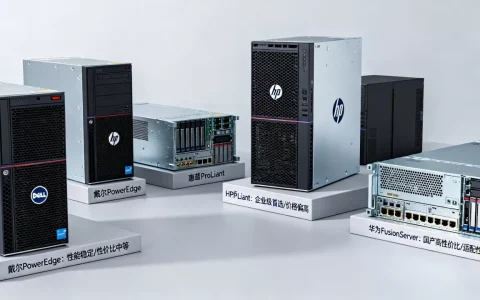
这是数据中心里的绝对主力,也是纳管系统最基础的“照顾对象”,无论是戴尔PowerEdge、惠普ProLiant还是浪潮NF系列,只要你的环境里超过个位数台,手动一台台登录去改IPMI或者iDRAC密码就成了一场灾难。
- 管理方式:通过带外管理网口(如iLO、iDRAC、BMC)实现电源开关、硬件健康监测、固件更新。
- 纳管重点:CPU利用率、内存占用、磁盘RAID状态、电源模块是否冗余。
- 实操:在Zabbix或Prometheus里添加主机时,务必用SNMP或Redfish协议连接,别只靠agent,带外管理IP要单独划VLAN,别和业务IP混在一起,否则断电断网时你连不上BMC,再牛的纳管平台也白搭。
刀片服务器与高密度计算节点
刀片服务器就像是“挤在一起住的合租公寓”,机箱(如华为E9000、HPE C7000)自带管理板,这类设备纳管的难点在于既要管刀片个体,又要管机箱整体。
- 关键点:机箱的散热风扇转速、冗余电源负载、背板互联带宽。
- 踩坑提醒:刀片服务器的虚拟KVM功能非常耗带宽,用网页控制台远程装系统时,建议把纳管平台的管理流量和业务存储流量做物理隔离。
ARM架构服务器与信创设备
近年来国产化替代趋势明显,飞腾、鲲鹏、海光这些芯片的服务器越来越多,纳管这类设备时,别只看CPU品牌,要重点看底层固件是否支持Redfish标准,行业共识认为,凡是支持Redfish协议的设备,不论架构,理论上都能被主流平台纳管,只是细节指标上有差异。
- 注意:部分信创服务器的BMC对标准IPMI命令兼容性一般,纳管时建议先做一轮POC测试,确认能读到CPU温度曲线和内存ECC纠错记录。
按系统类型划分:虚拟机与云主机怎么算“纳管”
虚拟化平台里的虚拟机
很多人只纳管物理机,不纳管VM,这是大忌,一台物理机上跑40个虚拟机,任何一个虚拟机磁盘打满都会拖垮宿主机。
- VMware vSphere:通过vCenter SDK直接纳管,能自动发现虚拟机迁移到哪台宿主机了,不用手动改映射。
- KVM/Proxmox VE:用libvirt API纳管,能拿到虚拟机CPU的 steal time 指标,这个数据能直接反映宿主机是否超分配严重。
- 操作建议:在纳管平台上给虚拟机打标签(核心业务”“测试环境”),配合自动告警,比看纯IP列表直观得多。
公有云与私有云的云主机
如果你的环境同时有简米云ECS、酷番云CVM和自建OpenStack,别忘了统一纳管,通过各云平台提供的OpenAPI,将云主机导入统一监控视图。
- 能管什么:实例规格变更记录、安全组变动、按量计费的费用趋势。
- 实用性:这更多是“资源合规纳管”,看的是有没有人偷偷创建了高配实例但没人认领。
按专业用途划分:自带“小电脑”的设备
存储设备与备份一体机
存储设备的“控制器”就是一台小小的服务器,纳管存储时,关注点从CPU转向读写延迟、缓存命中率、RAID重构进度。
- 常见对象:华为OceanStor、NetApp FAS、戴尔PowerVault。
- 注意:存储设备的SNMP OID各家私有化严重,用通用模板容易取不到数据,尽量用厂商提供的Storage Resource Management插件。
负载均衡器与应用交付控制器
F5 BIG-IP、深信服AD、Array这类设备,本质是专用服务器,纳管它们不是为了看CPU,而是为了看四层并发连接数和七层请求速率。
- 配置技巧:在纳管平台里用SSH协议轮询
tmsh show sys performance命令,能拿到最准确的吞吐数据,比SNMP更全。
工业控制服务器与边缘计算网关
在工厂车间或连锁门店,边缘服务器环境恶劣,纳管这类设备要优先考虑离线告警和本地缓存能力,网络断了也能存数据,恢复后自动补传。
哪些情况下“不该纳入”管理:纳管边界要划清
不是所有服务器都适合纳管,以下情况你最好先别动:
- 临时搭建的测试机:生命周期不超过72小时,纳管它只会污染监控基线。
- 已EOL且无人维护的老旧设备:比如Windows Server 2003老机器,纳管后补丁漏洞信息会持续告警,但你又没法处理,系统天天报警,值班同事会疯。
- 物理隔离的网络设备:比如电力监控系统的专用服务器,安全等级要求高,强制纳管可能违反等保要求。
纳管方式对比:Agent、Agentless还是带外管理
描述清楚不同纳管技术路径的适用场景,表格能让对比一目了然。
| 纳管方式 | 实现原理 | 优点 | 局限性 | 常见场景 |
|---|---|---|---|---|
| Agent方式 | 在系统内装软件客户端(如Zabbix agent) | 采集指标精细,支持业务层面自愈脚本 | 占用系统资源,有兼容性问题 | 规模较小、需进程级监控 |
| Agentless方式 | 用SSH/WinRM远程拉取数据 | 无需装软件,部署快,入侵面小 | 采集周期较长,无法抓取进程级细节 | 云主机、临时扩容设备 |
| 带外管理 | 通过BMC/iLO/iDRAC独立管理口 | 宕机时也能远程开关机、看蓝屏 | 需要配置独立管理网段,成本略高 | 核心数据库、关键业务物理机 |
决策建议:混合使用,核心物理机用带外管理+Agent双重纳管,云主机用Agentless,别全用同一种方式,一条路走到黑容易出盲区。
实操:从零开始把一台服务器纳入管理平台
这里以现在国内运维圈比较主流的开源平台为例,给你一个可验证的操作路径。
第一步:准备纳管环境
部署一台管理服务器,建议4核8GB内存起步,安装CentOS Stream或Ubuntu LTS系统,跑Zabbix或Prometheus+Grafana组合。
第二步:目标设备放行
在待纳管的服务器防火墙里放行管理服务器的IP,只放行必需端口,对Linux设备放行10050(Zabbix agent端口)和22端口。
第三步:添加主机
在Zabbix Web界面点“创建主机”,填入主机名和IP,链接“Template OS Linux by Zabbix agent”模板,等待30秒到1分钟,看到“ZBX”图标变绿就是纳管成功了。
第四步:验证纳管效果
看“Latest data”能不能拿到CPU、内存、磁盘IO数据,试着手动停掉机器上的一个服务,确认告警能不能在1分钟内触发。
纳管服务器设备的成本怎么算
- 软件成本:商用软件(如IBM Turbonomic、BMC TrueSight)按CPU socket或托管设备数量授权,一台低配服务器费用可能在几百到几千元不等,具体价格受地区渠道商影响较大,开源平台软件免费但需要算人力成本。
- 硬件成本:管理服务器本身的花费,以及为带外管理网口单独部署的交换机端口成本。
- 隐性成本:为满足纳管而做的网络改造(比如新增管理VLAN)、安全加固(比如改掉所有BMC的默认密码)所花费的时间。
纳管服务器设备时容易踩的坑
- 不收集历史基线:纳管后不保存历史数据,出故障时没有对比参考,容量规划全靠拍脑袋。
- 告警风暴:默认阈值设置太敏感,一有短暂波动就疯狂发短信,业内专家指出,先观察两周真实数据再调阈值,是避免告警疲劳的最有效方法。
- 忘了纳管监控平台自身:管理服务器挂了,整个监控就全黑了,你得给纳管平台自己也设个看门狗。
哪些品牌设备在纳管时需要特别处理
- 华为服务器:iBMC接口很规范,但默认SNMP团体字是“Huawei@123”,接入前务必改掉。
- 新华三/HPE服务器:新H3C机型同时兼容iLO和Redfish,接入时优先选Redfish对OpenStack环境友好。
- 超微/组装机:BMC管理固件版本混乱,低版本固件的IPMI接口容易掉线,建议先升级固件再纳管。
问答区:针对高频疑问的补充说明
纳管服务器和监控服务器是一回事吗?
不是完全等价,监控只是“看”,纳管还包括“动”,纳管平台不仅能告诉你CPU高了,还能按预设计划触发脚本关机、重启服务、迁移虚拟机,如果只是部署独立监控,那只是做到半个纳管。
公司只有三台服务器,有必要上纳管平台吗?
从这个问题的预算敏感度来看,如果三台机器跑的都是核心业务,且没有人专职盯着,搭建一个简单纳管平台是值得的,哪怕只用开源的Zabbix,也能让你在非工作时间不用亲自跑机房查看宕机状态。
纳管服务器设备对网络连通性有哪些硬性要求?
纳管平台与被纳管设备之间必须能建立稳定TCP连接,建议管理流量独立规划VLAN,带宽需求不高,但延迟必须稳定,超过300ms延迟会导致SSH类采集频繁超时,带外管理网口必须与业务网络隔离,这是合规底线。
最后想跟你强调,纳管服务器的本质是把“人盯着机器”变成“平台盯着机器”,不管规模大小,从第一台设备接入纳管平台开始,你才真正掌控了机房,别追求大而全的豪华方案,先把手头的设备管清楚,比什么都实在。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/703223.html