在成都安排大模型微调租GPU服务器,核心是“按模型规模和微调方法选卡,按训练周期选租期,优先本地IDC与云平台混合调度”。 先把显存、数据量、训练轮次算清楚,再决定租RTX 4090、A100还是H100,最后用按量或包月控制成本。
成都大模型微调租GPU服务器怎么安排:先算显存再选卡
大模型微调不是“显卡越贵越好”,而是“显存够不够、带宽稳不稳、租期划不划算”,在成都,本地IDC、天府新区机房、高新区云服务商都能提供GPU租用,但配置和价格差异不小,业内专家指出,微调阶段更吃显存容量和显存带宽,而不是单纯看算力峰值。
大模型微调租GPU服务器需要什么配置
先看模型参数量和微调方式,QLoRA、LoRA、全量微调对显存要求完全不同,下面是一份实用对照:
| 模型规模 | 微调方式 | 推荐显存 | 成都常见卡型 |
|---|---|---|---|
| 7B | QLoRA | 16GB-24GB | RTX 4090 24G |
| 7B | LoRA | 24GB-48GB | RTX 4090、A6000 |
| 13B | QLoRA | 24GB-48GB | A6000、A100 40G |
| 34B | QLoRA | 48GB-80GB | A100 40G/80G |
| 70B | QLoRA | 80GB×2或80GB×4 | A100 80G、H100 |
| 7B | 全量微调 | 80GB以上 | A100 80G、H100 |
如果只是做领域知识注入、指令跟随微调,QLoRA + 7B/13B模型是性价比最高的路线,24G显存的RTX 4090就能跑7B QLoRA,数据量在几万条以内时,单卡训练通常够用,若要做34B以上模型,优先选A100 80G,并确认机器支持NVLink,否则多卡通信会成为瓶颈。
显存估算可以记一个粗公式:模型权重 + 优化器状态 + 激活值 + 数据批次,QLoRA通过4bit量化把权重压下来,但激活值仍会随批次和序列长度上涨,序列长度从512拉到2048,显存占用可能翻倍,所以租服务器时,别只看卡型,还要看内存、CPU、系统盘和数据盘,数据盘建议至少500GB,模型权重和检查点很占空间。
成都租GPU服务器做微调多少钱一个月
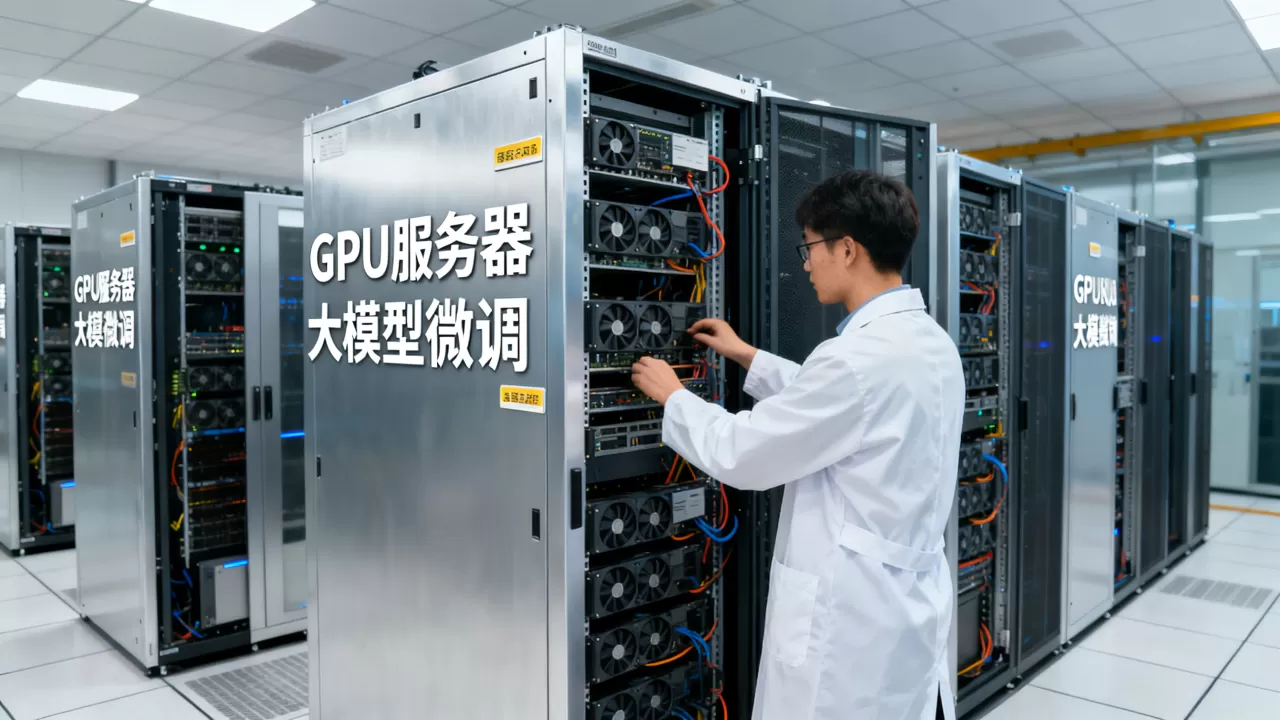
价格是成都用户最关心的部分,成都大模型微调GPU服务器租用价格通常受卡型、租期、带宽、是否独享影响,按当前市场常见区间,RTX 4090单卡月租在大几千元,A100 40G月租在数万元,A100 80G和H100更高,按量计费则每小时几十元到上百元不等,适合短周期实验。
如果训练任务在3天到2周内完成,按量计费更灵活,若连续跑一个月以上,包月通常比按量便宜,成都本地机房还会涉及带宽费、公网IP费、数据盘扩容费,有些服务商把GPU和存储打包,有些则分开计价,询价时直接问清楚:是否独享GPU、是否含公网带宽、是否支持快照、是否收取出流量费,这四点比单看GPU单价更重要。
成都本地GPU服务器租用与外地云服务对比
成都本地GPU服务器租用与外地云服务对比,不能只看价格,行业共识认为,成都本地IDC在数据合规和低延迟上更有优势,外地云平台在弹性扩缩容上更灵活,如果你的数据涉及政务、医疗、金融,优先考虑成都本地机房,减少数据跨省流动带来的合规解释成本。
成都本地IDC适合哪些微调场景
- 数据不出川、要求本地化存储的政企项目。
- 需要低延迟访问本地数据库、内部系统的微调任务。
- 长期稳定训练,且预算允许包月包年的团队。
- 需要现场运维、带外管理、快速换卡的场景。
成都天府新区、高新区、郫都区都有IDC资源,部分机房接入成渝枢纽节点,据工信部数据,近年来我国算力基础设施规模持续扩大,成渝地区智能算力供给也在增加,对成都团队来说,本地租卡可以减少网络抖动,传模型和数据集更快。
外地云平台适合哪些微调场景
- 短期实验、论文复现、多个配置并行对比。
- 需要按小时计费、随时释放的弹性任务。
- 使用云厂商预置镜像、自动扩缩容和托管训练服务。
- 团队不在成都,但需要统一调度多地算力。
外地云平台的优势是开箱即用,缺点是长期成本可能偏高,数据跨区域传输也可能增加延迟,混合方案更实用:
在成都本地IDC跑正式训练,在外地云平台做小规模消融实验。
成都大模型微调租GPU服务器实操安排
第一步:评估模型与数据
先确定模型名称、参数量、微调方法、序列长度、批次大小、训练轮次,把数据集整理成JSONL格式,每条样本包含instruction、input、output,数据量少时,几千条高质量样本也能见效;数据量多时,要提前做去重、清洗和格式校验。
第二步:租服务器与开环境
向成都本地服务商或云平台提交需求:GPU型号、数量、显存、内存、系统盘、数据盘、带宽、租期,拿到机器后,先用以下命令确认环境:
nvidia-smi
nvcc -V
free -h
df -h
如果驱动和CUDA版本不匹配,后续安装PyTorch会反复报错,建议选Ubuntu 22.04,CUDA 12.1,PyTorch 2.1以上,裸金属服务器需要自己装驱动,容器化平台可直接选预置镜像。
第三步:配置微调环境
以LLaMA-Factory为例,创建环境并安装依赖:
conda create -n llama-factory python=3.10 -y
conda activate llama-factory
pip install torch==2.1.2 torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
pip install transformers datasets peft accelerate bitsandbytes deepspeed
git clone https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
pip install -e .
如果使用vLLM或Axolotl,依赖组合不同,建议先锁定版本再批量安装。
第四步:准备数据与启动训练
数据注册到data/dataset_info.json,然后写YAML配置,示例:
model_name_or_path: /data/models/Qwen2.5-7B-Instruct
stage: sft
do_train: true
finetuning_type: lora
lora_target: q_proj,v_proj
dataset: my_data
template: qwen
output_dir: /data/output/qwen_lora
per_device_train_batch_size: 4
gradient_accumulation_steps: 4
learning_rate: 5e-5
num_train_epochs: 3
quantization_bit: 4
fp16: true
启动命令:
llamafactory-cli train qwen_lora_sft.yaml
训练时用watch -n 1 nvidia-smi
看显存和利用率,若显存溢出,先降per_device_train_batch_size,再升gradient_accumulation_steps,若GPU利用率低,检查数据加载是否卡在CPU或磁盘。
第五步:监控、保存与合并权重
保存检查点后,用merge_lora合并权重,导出完整模型,合并后可用vLLM或TGI部署推理,验证微调效果,别忘了把日志、配置、数据版本一起归档,方便复现。
成都地域选择与合规注意
成都本地租GPU服务器,优先看机房是否在成渝枢纽节点、是否支持数据不出省、是否有等保资质,据中国信通院,智能算力需求持续增长,企业对数据安全和训练效率的要求同步提高,如果数据含个人信息,要遵守个人信息保护法,做好脱敏和访问控制,训练完及时删除临时数据盘,避免残留。
成本优化与常见坑
- 短任务用按量计费,长任务转包月,别让机器空转。
- 竞价实例便宜,但可能被回收,适合可断点续训的任务。
- 数据盘选SSD,模型加载和检查点写入更快。
- 别忽略出流量费,下载模型和上传数据可能单独计费。
- 多卡训练先确认NVLink和PCIe拓扑,否则加卡不提速。
- 租前问清是否支持自定义镜像,避免换机重装环境。
Q&A:成都大模型微调租GPU服务器怎么安排更稳妥
成都大模型微调租GPU服务器怎么选配置?
7B QLoRA选RTX 4090 24G即可;13B QLoRA选A6000或A100 40G;34B以上选A100 80G;70B QLoRA至少两张A100 80G,全量微调显存需求更高,7B全量也建议80G卡,序列长度、批次大小、优化器状态都会影响实际占用。
成都租GPU服务器做微调多少钱一个月?
RTX 4090单卡月租通常在大几千元,A100 40G在数万元,A100 80G和H100更高,按量计费每小时几十元到上百元,包月有折扣,最终价格取决于显存、CPU、内存、带宽、存储和租期。
大模型微调租GPU服务器需要自己装环境吗?
裸金属服务器通常需要自己装驱动、CUDA和Python环境;容器化平台提供预置镜像,开箱即用,选择支持自定义镜像和持久化存储的成都本地IDC,能减少环境迁移成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/703523.html