做实验用的服务器,按用途和规模可粗分为通用计算服务器、GPU加速服务器、高性能计算集群、云服务器四大类,若是个人小规模验证,一台塔式工作站或云服务器足矣;若是深度学习或大规模仿真,则必须配置搭载NVIDIA A100/H800等加速卡的GPU服务器或由计算节点、管理节点和高速网络组成的集群。
通用计算服务器:科研实验室的“万金油”
这是实验室中最常见的机型,负责跑数据处理、分子动力学模拟(如GROMACS)、有限元分析等CPU密集型的任务,它们不追求极致算力,但强调稳定性和内存带宽。


- 处理器:通常采用双路Intel Xeon Platinum或AMD EPYC架构,以EPYC 9004系列为例,单颗最高96核心,多线程性能是普通PC的8-10倍。
- 内存:计算节点的标配是512GB到2TB DDR5 ECC内存,ECC纠错能力在长跑数天的仿真中至关重要,一旦发生比特翻转,结果全废。
- 存储:需要组RAID磁盘阵列,常见为RAID 5或RAID 6,避免单块硬盘物理损坏导致数据丢失,系统盘用NVMe固态,数据盘用大容量HDD。
- 典型机型:戴尔PowerEdge R750、浪潮NF5280M6、联想ThinkSystem SR650。实际购买时,处理器建议买“基础款”,但内存一定要配足,许多计算任务瓶颈不在CPU,而在内存控制器。
GPU加速服务器:深度学习与AI训练的“主力军”
只要涉及神经网络训练、大模型微调或分子对接(如AutoDock GPU版),就必须上带独立显卡的服务器,这类服务器的研发优先级是显卡 > CPU > 内存。
- 核心配置:针对英伟达的计算卡,如A100 80GB、H100或消费级的RTX 4090,实验室预算有限时,主流做法是先买一两张RTX 4090 24GB用来跑通代码,验证算法可行性。
- 硬件格局:一台4U机箱内通常容纳

4到8张GPU卡
,配合PCIe 4.0/5.0通道,此时需要改水冷散热,否则机房会变成“恒温桑拿房”。 - 行业共识:如果是做千亿参数大模型预训练,单机8卡H100只是入门,在对等网络(IB网络)落后的情况下,卡多反而互相拖慢,训练效率呈断崖式下降。
- 固资预算:业内专家指出,一台8卡A100服务器(含管理节点)的市场报价通常在80万至120万元之间,这个价格不含机房改造费。
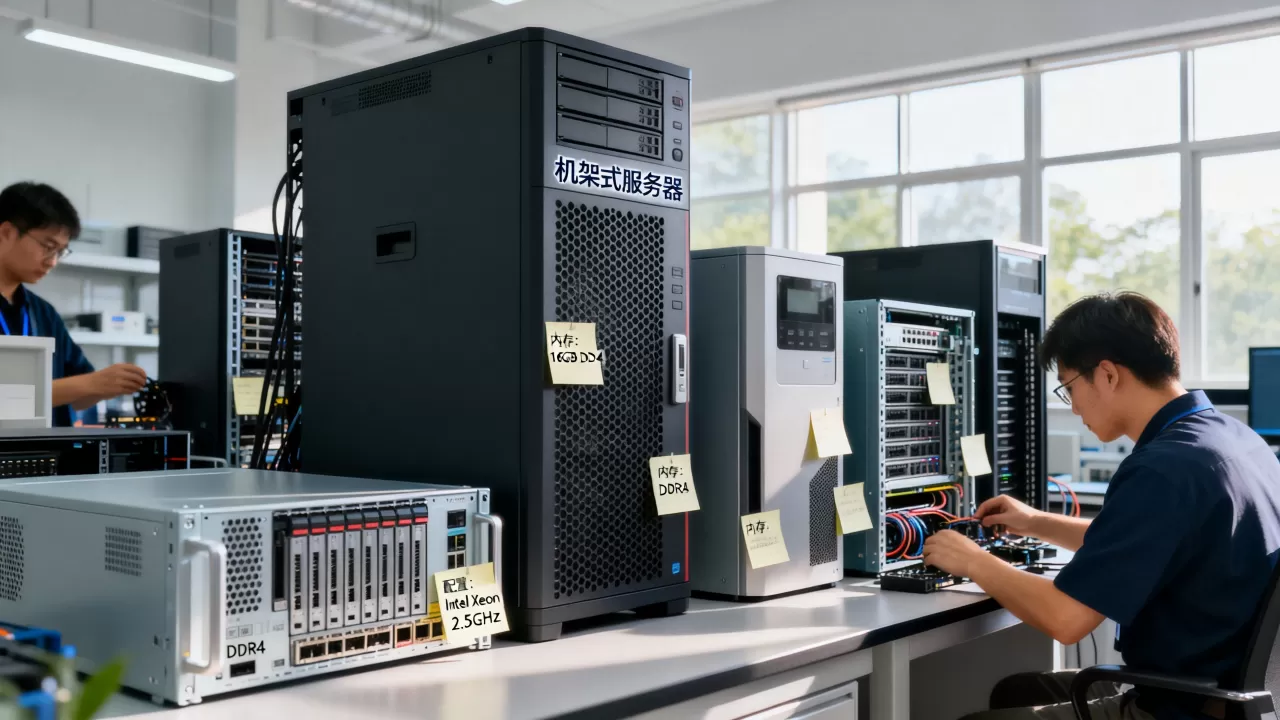
高性能计算集群:大兵团协同作战
当单台服务器的资源不足以支撑计算任务时,就需要把多台机器“拧成一股绳”,集群不是什么神秘设备,它就是一堆服务器加上高速交换机组合成的整体。
- 逻辑架构:分为登录节点、计算节点和存储节点,用户通过登录节点提交任务,调度系统(如Slurm)负责把任务分发给空闲计算节点。
- 组网方案:核心是InfiniBand(IB)网络,延迟低至0.6微秒,吞吐量达200Gbps以上,普通千兆以太网在集群里不顶用,会成为数据传输的死穴。
- 适用场景:涉及大规模并行计算(如天气预测、流体力学)的实验室,必须用集群方案,单机跑需要三个月,集群80个核心并行只需三天。
- 部署复杂度:搭建集群并非只靠堆硬件,需要配置共享存储(如Lustre文件系统)、环境调度模块(Environment Modules)以及Slurm作业调度策略,许多课题组会选择向超算中心租用算力,本地只保留小规模调试机器,这反而是性价比最高的路径。
云服务器与廉价实验方案
对于预算紧张、起步较晚的课题组或个人,云服务是个随用随走的“临时工”,简米云、酷番云、AWS都提供按量计费的GPU实例。
- 价格优势:轻量级实验(如Kaggle竞赛、课程作业)租用
短期竞价实例
更为划算,以常见配置(4核16G)为例,包月约在200元至500元之间,而带T4显卡的实例包月通常1500元起。 - 弹性扩容:不需要为几个月一次的峰值需求购买数百万硬件,通过API一键扩展到100张卡,跑完释放,是当下企业级实验的普遍玩法。
- 数据门禁:需要注意,科研数据如果涉密(医疗影像、军工项目),严禁上传公有云,此时只能私有化部署或购买国家队认证的政务云专区。
搭建实验服务器的实操避坑指南
很多新手采购时只盯着CPU主频和显卡,忽略了很多决定成败的细节。
- 电源与配电:一台4卡GPU服务器满载功率约3000W,需要C19/C20工业电源接口,普通家用插座是16A的,插上去轻则跳闸,重则烧毁电线,必须为机柜单独拉380V三相电或至少6平方毫米的独立线路。
- 防火墙与端口:不要直接暴露在公网,实验节点通常内网隔离,通过堡垒机跳板登录,如必须远程SSH,务必修改默认22端口并配置密钥登录。
- 系统与软件:实验室环境不建议安装Windows Server,Ubuntu Server LTS(22.04或20.04)是行业默认选项,CUDA与显卡驱动版本需严格匹配,装错版本会浪费两三天调试时间。
- 验收测试:新机器到手后,先后跑
gcc编译测试CPU与内存,再跑nvidia-smi及dcgmi诊断GPU健康状态,最后用HPL(Linpack)测试浮点峰值,确认没有“虚标”。 - 噪音管理:高负载时服务器噪音可达80分贝,相当于马路边的嘈杂声,若放在办公区,必须带去机房托管或加装隔音柜。
按专业场景的服务器配置偏好
不同学科对硬件的依赖天差地别,买成“一刀切”配置必然后悔。
生物信息学与基因组学
重点在内存容量与IO吞吐
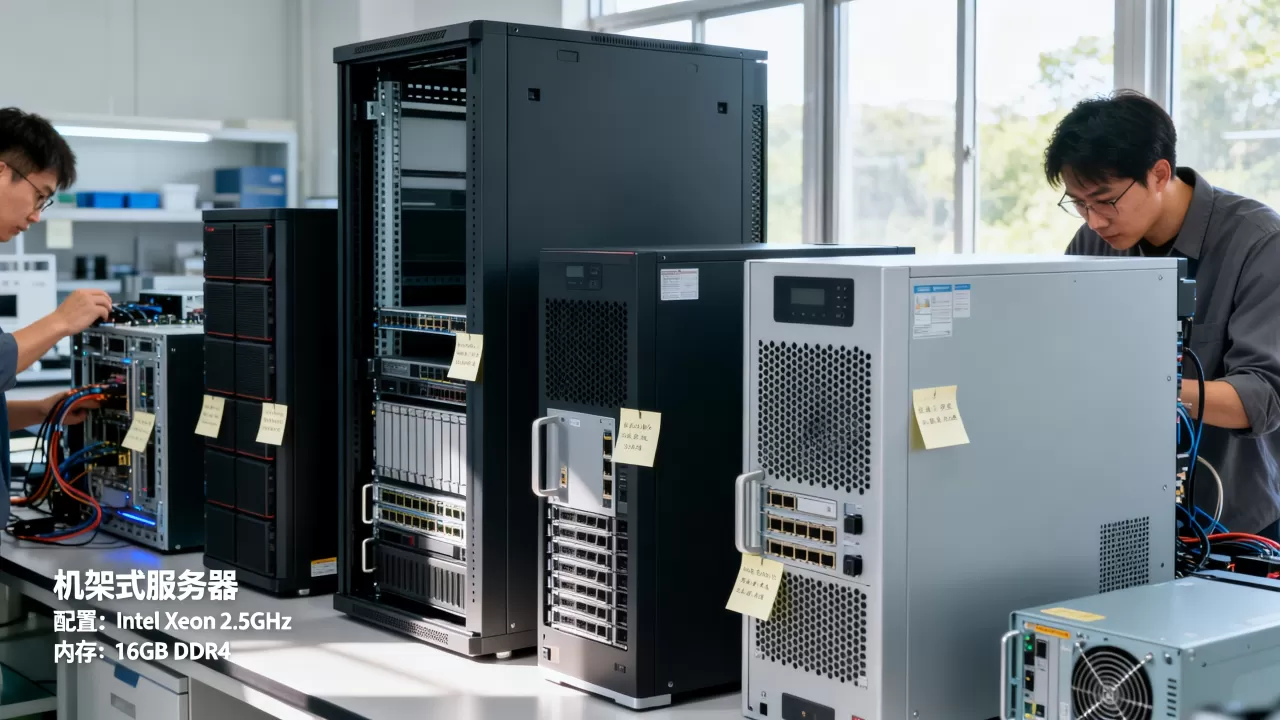
,比对(如BWA、STAR)和组装(如MEGAHIT)阶段对内存消耗极大,行业建议32线程起步,内存至少256GB,最好上1TB,存储建议全闪存NVMe阵列,机械硬盘跑SRA数据解压会让人等到怀疑人生。
深度学习算法组
偏重显存容量与卡间通信,模型参数量不会永远在单卡显存范围内,多卡数据并行时的P2P(GPU直连)带宽决定训练速度,购买时需查看主板拓扑结构,确保两张卡能跑满PCIe x16通道通信,避免走南桥死路。
材料模拟与量子化学
这类软件(VASP、Gaussian)对CPU主频极其敏感,因为计算过程包含大量串行迭代分支,核心数多了反而引发调度开销,选型时高频的AMD Threadripper或Intel Xeon W系列往往比双路服务器更实用,配大缓存的优势高于堆核心。
深度学习用服务器推荐
当前主流的中端实验室配置是双路EPYC 9654 + 4张RTX 6000 Ada(或2张A100),这能应对95%以上的科研场景,若是入门玩家,可以入手二手RTX 3090,性价比在显存价格暴涨的行情下尤其突出。
常见问题解疑
什么情况下必须采购实体服务器,而不是用云服务器?
当数据量级达到PB级(每秒上传带宽超过1Gbps)或涉及敏感数据不出域时,必须自建,根据相关研究机构测算,长时间运行(超过12个月)的周期性任务,实体机总拥有成本比按量付费云主机低40%左右,若实验周期跨度超过半年,租约总价已足够买一台高配机器。
深度学习用服务器推荐什么配置才能毕业设计够用?
对于学生端的毕业设计级需求,不必追求超大规模集群,一台配置为AMD Ryzen 9 7950X + RTX 4090 24GB + 64GB内存的工作站就能跑通绝大多数单机实验,若需要复现大型预训练模型,可以直接租用AutoDL或恒源云这类算力超市,按小时计费,登录实例后环境自带CUDA,比本地折腾驱动省时得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/706383.html