服务器常见故障主要分为硬件、网络、系统软件和安全四大类,其中硬件故障是导致服务器宕机的首要原因。无论是企业自建机房还是租用云服务器,故障都不可避免,区别只在于处理速度快慢,下面按发生概率和处理优先级,把最常见的故障类型一条条拆开讲。
服务器常见故障有哪些:先分清四个层面
服务器不是单一个体,它由物理设备、操作系统、网络环境、应用服务共同组成,任何一个环节出问题,都会表现成”服务器坏了”,行业共识认为,真正需要动手换零件的硬件故障只占一部分,更多时候是软件配置错误或资源耗尽导致的假死。
硬件故障:别让电源和硬盘拖垮整个业务
硬件故障最直观,也最容易引发业务中断。
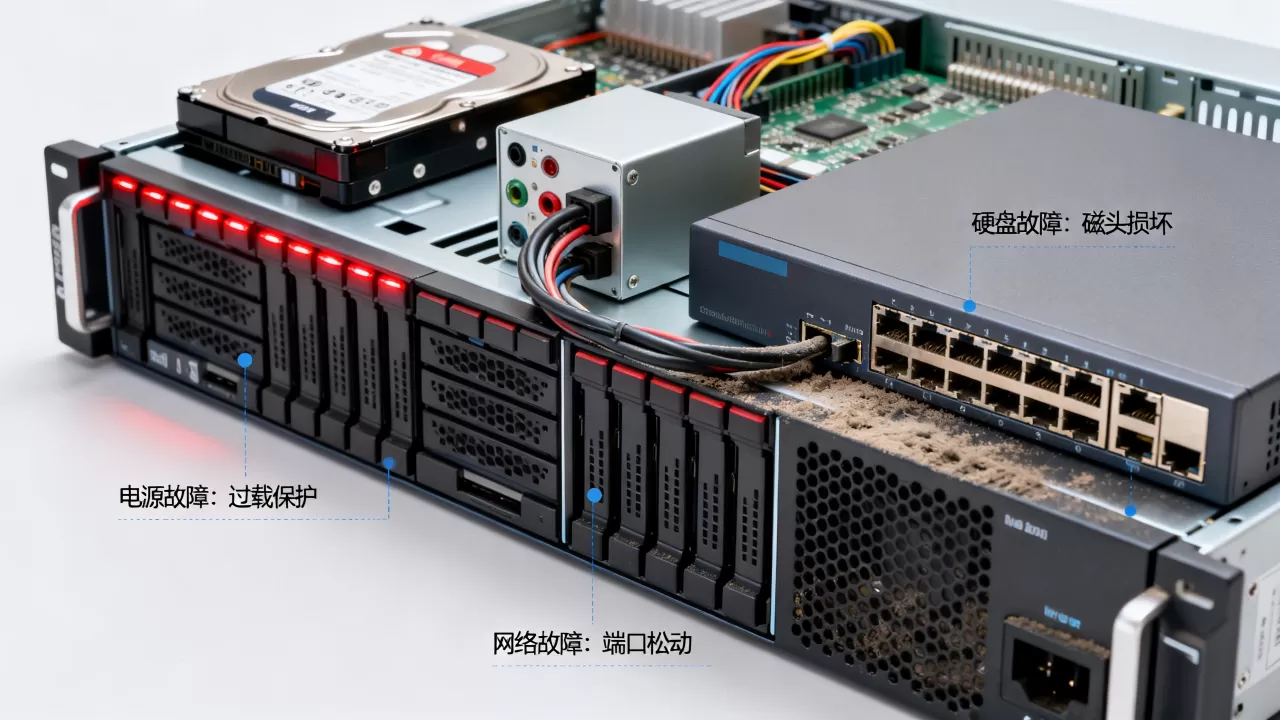
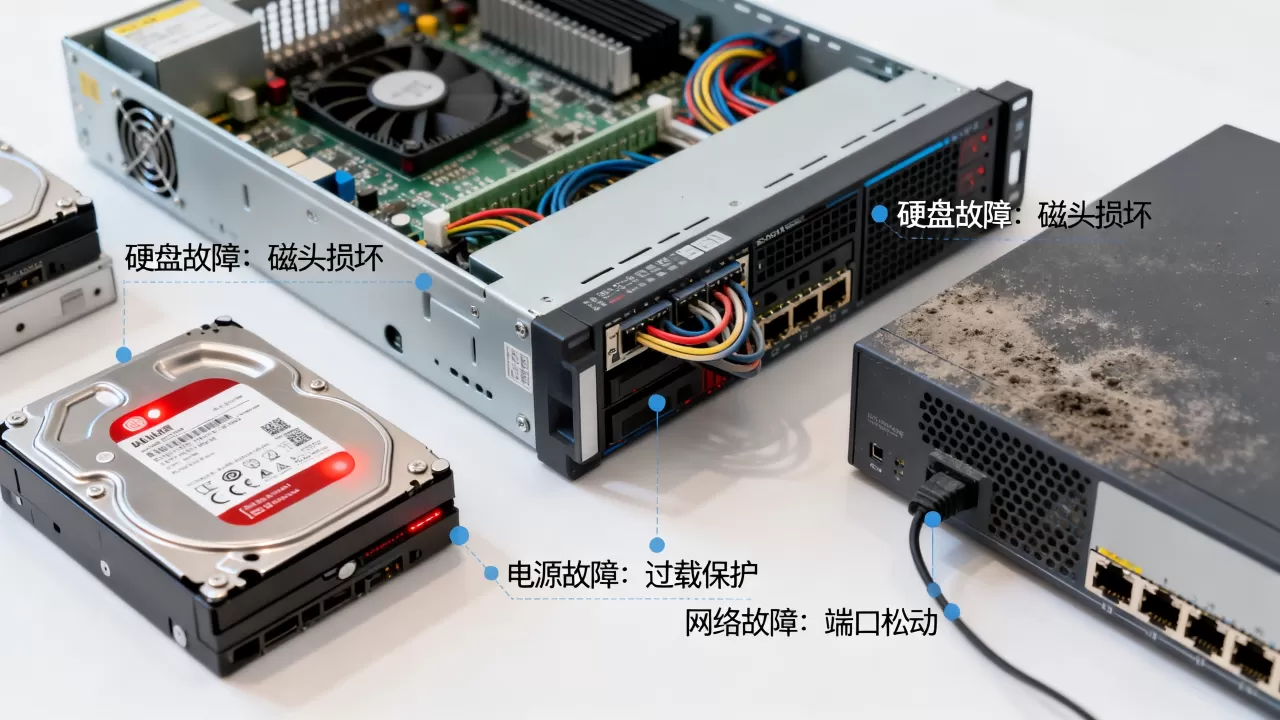
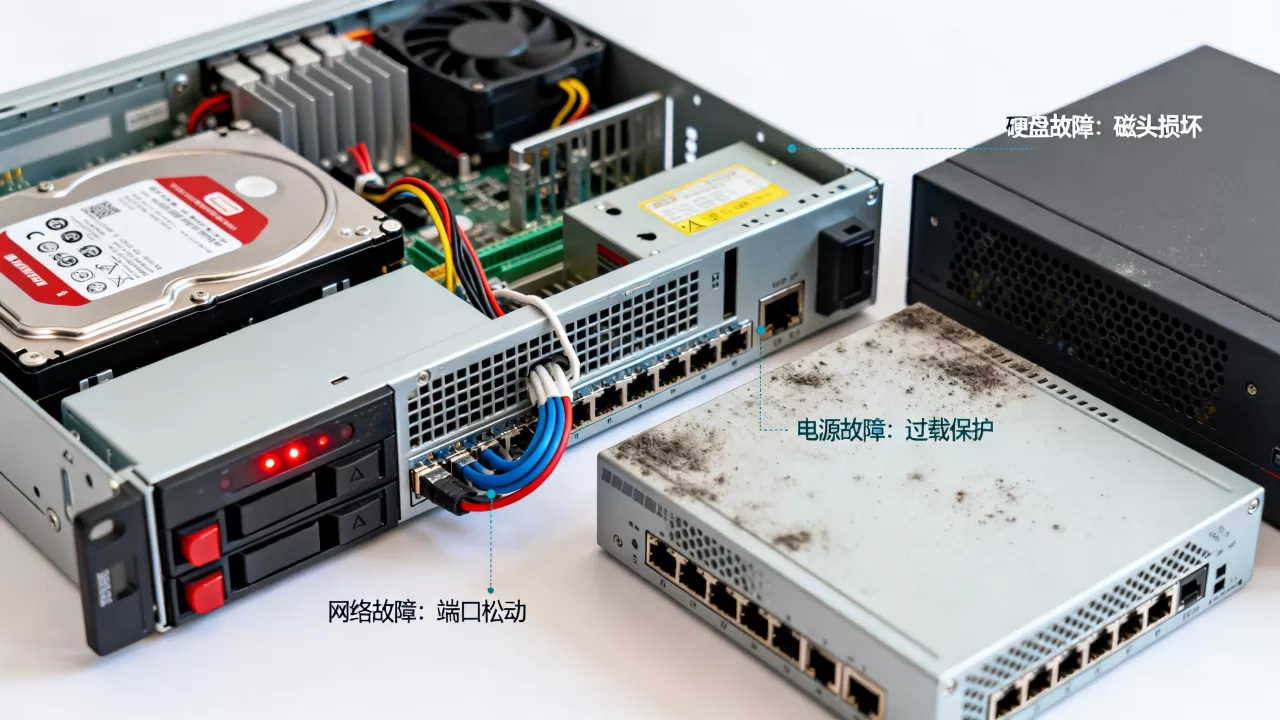
- 电源故障:电源模块老化、电容爆浆、机房电压波动,都会导致服务器瞬间断电,双电源冗余可以降低风险,但两路电源接在同一只UPS上,依然会同时断电。
- 硬盘故障:机械硬盘在读写时出现坏道,SSD出现磨损或主控异常,都会让数据读写变慢或直接掉盘,RAID阵列中的硬盘掉线,如果热备盘没有及时顶上,阵列就可能降级甚至崩溃。
- 内存故障:内存条金手指氧化、接触不良,或者单颗颗粒损坏,会表现为系统频繁重启、随机死机、跑出奇怪的校验错误,ECC内存在报错时会记录在BMC日志中,但很多人不查。
- CPU过热:散热风扇积灰、硅脂干裂、机房空调失效,CPU温度过高会触发降频保护,表现为处理能力暴跌,严重时直接关机。
网络故障:业务”假死”的常见元凶
网络故障的迷惑性很强,因为服务器本身还在运行,但用户已经访问不到了。
- 网卡或线缆松动:网卡指示灯亮但丢包严重,常见于劣质网线、水晶头接触不良。
- 交换机端口故障:某台服务器连接的交换机端口down掉,该节点就彻底失联,但其他节点正常。
- DNS解析失败:域名指向的IP发生了变化,或内部DNS服务器缓存脏数据,导致域名解析超时,业务表现为”打不开”。
- 带宽被占满:日志采集、备份任务或蠕虫病毒把出口带宽吃满,正常请求无法及时转发,网站响应极慢。
系统与软件故障:程序卡死比硬件更难缠
操作系统和应用软件的问题,在日志中往往只留下几行提示,排查时更费时间。
- 内存泄漏:一个进程长期运行后内存占用持续增长,最终触发Linux的OOM Killer,把关键进程杀掉。
- 死锁与等待:多线程程序抢占同一把锁不释放,表现为服务端口还在监听,但请求全部排队超时。
- 文件系统损坏:突然断电或强制重启,可能导致ext4/xfs文件系统出现脏数据,挂载变为只读,应用无法写入。
- 内核崩溃:硬件驱动bug、存储控制器异常,都可能触发Kernel Panic,服务器直接卡死,只能强制重启。
安全故障:不是所有故障都来自机房
攻击行为也能造成服务器”故障”。
- CC/DDOS攻击:大量无效请求耗尽连接数或带宽,让服务拒绝正常用户访问。
- 暴力破解入侵:SSH或远程桌面被猜出弱密码,攻击者植入挖矿程序,CPU和带宽被疯狂占用。
- 勒索病毒加密:数据被锁定,业务被迫中断,这种故障的恢复成本远高于更换一块硬盘。
服务器常见故障及解决方法:按症状快速定位
同一个现象,原因可能天差地别,服务器运行缓慢,既可能是CPU过热,也可能是数据库慢查询,还可能是被攻击,下面按最常见症状给出排查路径。
服务器宕机原因有哪些
宕机指系统完全失去响应或自动重启,排查顺序应按”硬件→系统→应用”逐层深入。
- 先看硬件:登录服务器BMC/IPMI管理界面,查看传感器是否有电源、风扇、温度告警,很多服务器支持远程管理,不用跑到机房就能看到硬件状态。
- 再看系统日志:执行
journalctl -f(CentOS用tail -f /var/log/messages),查找panic、oops、error等关键字,如果是OOM导致进程被杀,日志里会有明确提示。 - 最后看应用日志:比如Nginx的error.log、Tomcat的catalina.out,往往记录着业务崩溃前的最后动作。
服务器运行不稳定怎么办
不稳定表现为偶发抽风、间歇性重启或某个时间段必卡,这类问题最需要积累证据。
- 监控温度:用
lm-sensors查看CPU和主板温度,夏季机房散热不良是隐形杀手。 - 监控负载:
top命令观察load average数值与CPU核数的关系,load持续大于核数,说明有进程耗尽了CPU资源。 - 监控磁盘IO:
iostat -x 1查看%util,如果持续接近100%,可能是日志写入太频繁或慢盘拖累。 - 收集硬件错误:
dmesg中出现blocked for more than 120 seconds,基本可以判定存储控制器或磁盘有问题。
服务器硬件故障排查实操
硬件故障有自己的体检工具,不用拆机也能判断个大概。
- 硬盘健康检查:执行
smartctl -a /dev/sda,关注Reallocated_Sector_Ct和Pending_Sector计数,数值非零就应警惕。 - 内存检测:
memtest86+需要关机启动到引导环境,跑一圈能发现坏内存地址,日常可以用edac-utils查询ECC错误计数。 - RAID状态:
MegaCli -pdlist -aALL(LSI阵列卡)或ssacli ctrl slot=0 pd all show status(HPE阵列卡),确认是否有硬盘处于Failed或Rebuilding状态。 - 电源监控:检查BMC事件日志,查找Power Supply Failure记录,同时观察双电源的输入电流是否均衡。
企业服务器故障处理方案
单台服务器再稳定,也扛不住市政停电和硬盘物理损坏,企业级方案必须靠冗余和备份。
- 硬件冗余:至少两台服务器做集群,存储使用RAID6或RAID10,电源使用双路接入不同UPS。
- 监控告警:部署Zabbix或Prometheus,对CPU、内存、磁盘、带宽设置阈值,故障前提前通知。
- 自动化备份:核心数据库用mysqldump或Percona XtraBackup每日全备,文件服务器用rsync同步到异地对象存储。
- 故障预案:写好重启流程、切换到备机流程、联系机房托管的联系电话,服务器租用商如果提供24小时电话支持,优先选择。
服务器的故障不会彻底消失,但大多数问题都可以通过日志和状态检查提前发现,与其等业务卡顿后再纠结服务器常见故障有哪些,不如先用监控、冗余和备份把风险摊薄,记住一句话:硬件故障看BMC,系统故障看日志,应用故障看监控,网络故障看流量。
常见问题:服务器常见故障有哪些
服务器常见故障有哪些?哪些可以自己处理?
硬件故障中的硬盘报警、内存报错需要停机更换;网络故障中的DNS解析错误、防火墙规则冲突可以远程自行处理;系统软件故障中的内存溢出、磁盘写满也都能通过清理和调参解决。
服务器宕机原因有哪些?如何避免?
宕机原因集中在电源失效、硬盘掉线、内存错误、软件死锁和攻击流量,避免方式包括启用BMC告警、为关键服务配置双机热备、定期执行日志归档和防攻击清洗策略。
服务器运行不稳定怎么办?
先看硬件的传感器状态,再看系统日志中的错误关键字,最后检查应用负载和慢日志,大多数“不稳定”来自磁盘I/O瓶颈或内存耗尽,通过扩容和优化查询能明显改善。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/709703.html