服务器常见问题主要有硬件故障、系统配置错误、网络链路异常、安全攻击和性能瓶颈五类,其中大部分故障都能通过日志分析和标准化排查流程快速定位。
服务器常见问题有哪些:硬件、系统、网络逐一拆解
服务器不像家用电脑,它往往7×24小时不间断运行,任何部件的疲劳都可能引发连锁反应,实际运维中,硬件故障占的比例最高,但系统层面的问题更让新手头疼,下面按出现频率从高到低拆开说。

硬件类故障:硬盘、内存、电源是重灾区
- 硬盘坏道或SSD寿命耗尽:表现为读写速度骤降、文件系统只读、开机自检卡在RAID界面,行业共识认为,硬盘故障占服务器硬件故障的一半以上,日常用
smartctl -a /dev/sda查看健康状态,若Reallocated_Sector_Ct持续增长,就该准备热备盘。 - 内存接触不良或单条ECC报错:服务器频繁重启、随机死机、执行
dmesg看到大量EDAC报错,多半是内存条问题,先清理金手指并重新插拔,再通过BIOS内存测试工具跑一轮。 - CPU过热降频:机房空调故障或散热器积灰,导致CPU温度超过阈值,系统会强制降频,表现是负载不高但业务卡顿,留意
lm-sensors输出的温度值,超过85℃就要检查风扇转速。 - 电源模块冗余失效:双电源服务器坏了一个,系统会告警但不会宕机,很多运维忽略这一点,结果另一个电源随后也出问题,整机断电,每季度检查一次电源指示灯和日志中的
Power Supply事件。
处理思路:先看/var/log/messages或/var/log/syslog,定位硬件报错关键词,再用dmidecode确认部件型号,最后按厂商手册更换备件,如果是托管在IDC的服务器,直接联系机房远程重启或请工程师代操作。
系统与软件问题:为什么服务器频繁宕机
硬件没毛病,系统层面却经常崩溃,多数是软件配置打架。
- 内核与驱动不兼容:升级内核后网卡驱动没跟着更新,导致网络时断时续,或者装了新版显卡驱动(GPU服务器)后系统直接无法启动,解决办法是保留旧内核,
grub2-set-default选择上一版本启动,再卸载冲突驱动。 - 文件系统空间占满:日志分区写满后,服务写不了日志,进程直接崩溃,用
df -h看到或/var使用率100%,清掉
/var/log
/var分区,避免根分区被撑爆。 - 内存泄漏导致OOM Killer:Java或Node.js进程持续吃内存,系统触发OOM机制杀掉进程,服务就掉了,观察
dmesg中的Out of memory信息,检查代码或调整JVM堆参数,必要时加内存。 - 补丁修复引发的新故障:微软或Linux发行版推送安全补丁后,偶尔会出现依赖库版本不匹配,所以生产环境更新补丁前,先在测试机跑一遍,再批量部署。
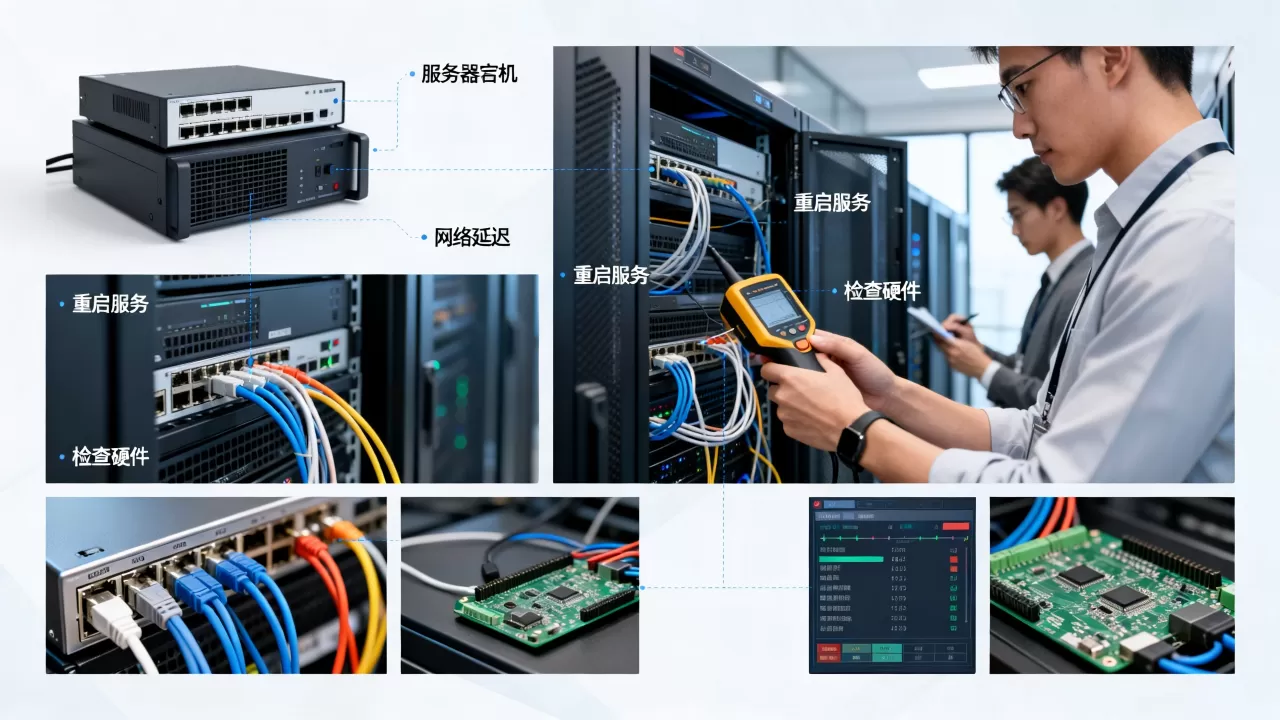
一套通用排查路径:先查systemctl status看服务状态,再翻journalctl -u 服务名 -n 100,然后看/var/log下的应用日志,找不到原因时用strace跟踪系统调用,往往能揪出隐藏依赖问题。
服务器响应慢怎么排查网络链路
服务器本身不卡,但远程连接时延迟高、下载速度慢,问题大概率在网络链路,这也是用户问得最多的场景之一。
从Ping到Traceroute的完整链路诊断
- Ping丢包和延迟:
ping -c 100目标IP,如果丢包率超过5%,说明链路有拥塞或光模块故障,先用mtr观察每一跳的丢包位置,判断是国内骨干网问题还是机房路由问题。 - 网卡流量跑满:用
iftop或nload查看实时流量,如果带宽占用长期接近上限,要么升级带宽,要么在防火墙做限流,注意区分入向和出向,出向跑满往往是被攻击或有人下载大文件。 - DNS解析慢:
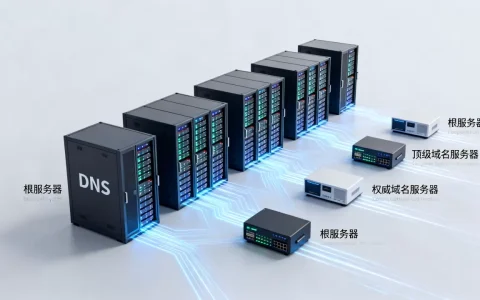
dig +trace域名,看解析耗时,如果某个NS响应超过500ms,换公共DNS或自建DNS缓存。 - 防火墙规则误拦截:
iptables -L -n -v查看规则计数,如果DROP包数量增长,可能误封了IP段,用tcpdump抓包确认TCP三次握手是否完成。
实际场景:用户投诉”服务器响应慢”时,先检查本地到机房的延迟,再上服务器看ss -tn连接数,如果TIME_WAIT过多,调整内核参数net.ipv4.tcp_tw_reuse和tw_recycle(注意tw_recycle在负载均衡场景下慎用)。
安全攻击:服务器被入侵的典型表现
很多管理员发现服务器变卡才想起查安全,但这时攻击者可能已经运行了挖矿程序或者留下了后门。
- CPU占用异常:执行
top按CPU排序,看到一个叫kworkerds
ls -l /proc/进程号/exe查看可执行文件路径,然后删除并检查定时任务。 - SSH暴力破解:
/var/log/secure里全是Failed password记录,防御措施:禁止root直接登录,修改SSH默认端口,开启密钥登录,如果一定要用密码,安装fail2ban自动封禁IP。 - Webshell后门:网站目录下出现
.php或.jsp的可疑文件,通过访问日志找到来源,删除后还要排查上传点是不是存在任意文件上传漏洞。 - DDoS流量攻击:流量图瞬间飙到几十G,服务器连接数爆满,机房会直接黑洞封IP,应对方式是接入高防IP或CDN,提前做好流量清洗。
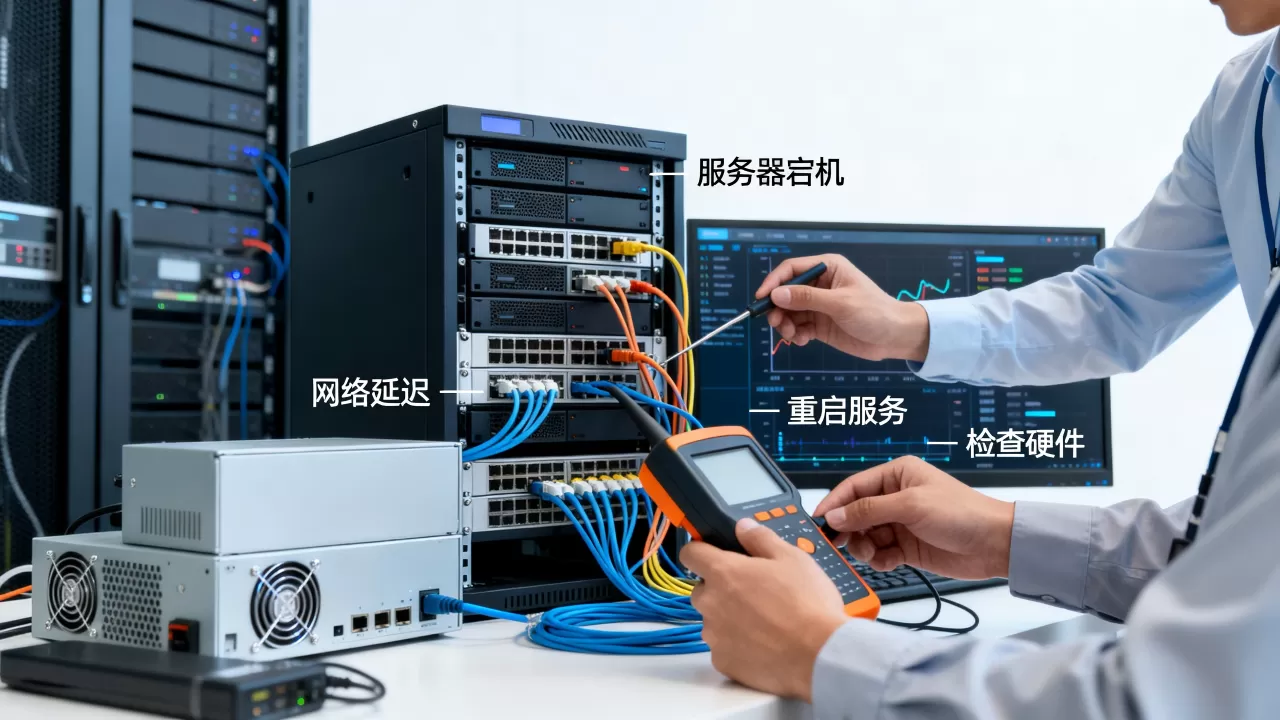
日常防护清单:定期yum update或apt update打补丁;关闭不用的端口;用云安全组或硬件防火墙限制仅开放80/443/22等必要端口,安全日志最好同步到远程日志服务器,防止被攻击者删掉痕迹。
云服务器和物理服务器哪个好:从性能瓶颈说起
业务性能不够用,不少团队纠结选云还是买物理机,其实这取决瓶颈类型。
- CPU密集型应用(如视频编码、科学计算):物理服务器的CPU裸性能更稳定,无虚拟化损耗,但云服务器的独享型实例也差不多,差别在5%以内。
- 磁盘I/O密集型(如高并发数据库):物理服务器用NVMe阵列延迟极低,云服务器要看云盘的IOPS指标,IOPS不够时,数据库查询慢,表现为锁等待和慢查询日志频繁。
- 成本对比:短期使用选云服务器按量付费,长期稳定跑业务买物理机更划算,但物理机还要算上机架费和电费,这时“服务器托管价格”就体现差异了托管机柜通常每月几千到上万不等,含带宽和IP费用。
架构选择技巧:峰值流量明显的业务用“云服务器+弹性伸缩”,高峰自动扩容,低谷缩容省成本,对数据一致性要求极高的金融系统,物理机+本地磁盘反而更可控,没有绝对好坏,只有适配场景。
性能调优的常见误区
- 只看CPU利用率:CPU 30%但业务卡,问题可能在磁盘等待或内存换页,用
iostat -x看await,用vmstat看si/so。 - 盲目优化数据库:先查
slow_query_log和EXPLAIN,再决定加索引还是改SQL,很多时候是应用层发请求太频繁,加Redis缓存更有效。 - 忽略内核参数:高并发连接报
Too many open files,需要调整ulimit -n和/etc/security/limits.conf,Nginx代理场景调大net.core.somaxconn。
运维与配置失误:服务器托管价格背后的隐性成本
很多故障不是技术问题,是人手误,尤其选择托管服务时,低价往往意味着低响应和少维护。
- 误删文件或目录:
rm -rf敲错路径,赶紧停止写入,用extundelete或xfs_undelete尝试恢复,更稳妥的办法是提前做快照或定期备份到异地。 - 配置文件语法错误:修改
nginx.conf后没执行nginx -t直接重启,导致服务挂掉,以后任何配置改动,先测试再重载。 - 备份策略缺失:数据被删才发现备份已过期一周,这比硬件故障更致命,建议全量备份每天一次,增量备份每小时一次,备份产物最好存到对象存储。
降低失误成本:用Ansible或SaltStack管理配置,避免手改生产环境,所有操作记录到堡垒机,出问题能追溯,线下机房巡检需重点关注服务器温度预警和风扇转速,线上云服务器则善用自动快照。
常见问题快问快答
Q:服务器常见问题有哪些最容易导致业务中断?
A:硬盘故障、电源故障和误操作排前三,硬盘故障可以靠RAID阵列解决,电源故障靠双电源冗余,误操作只能靠备份和完善变更流程来兜底。
Q:服务器响应慢但CPU和内存都很低,是什么原因?
A:优先查磁盘I/O和网络延迟,执行iostat -x 1看%util是否接近100%,再执行mtr看丢包点,数据库连接数打满也会拖慢整体响应,用show processlist验证。
Q:云服务器和物理服务器哪个更安全?
A:安全性和部署形态关系不大,主要看运维能力,云服务器自带安全组和DDoS防护,门槛低;物理服务器需要自己配硬件防火墙和入侵检测,但数据完全自主可控,多数中小公司更适合云服务器,物理机更考验团队经验。
服务器故障不可怕,可怕的是没有排查思路,真正专业的运维,从来不是知道所有答案,而是能用最快时间定位问题并恢复业务,把上面几条路径在测试环境多演练几遍,等你面对生产事故时,心里自然有底。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/710142.html