公司算力服务器有哪些?主流包括GPU训练服务器、GPU推理服务器、通用计算服务器、存储服务器、虚拟化/超融合服务器、边缘算力服务器和整机柜服务器,选型顺序是场景、模型、显存、互联、机房,最后才是品牌和价格。
先别急着列配置单,公司买算力服务器,最容易踩的坑是只看GPU型号,真到上线时,瓶颈可能在网络、存储、电力,甚至机房承重,下面按企业实际采购路径拆开讲。
公司算力服务器有哪些类型?先按用途拆开看
从用途分,企业常见算力服务器有这几类:
- GPU训练服务器:通常4卡或8卡,配NVLink/NVSwitch,适合大模型训练、微调、科学计算。
- GPU推理服务器:2卡、4卡或单卡,强调低精度推理和并发,适合搜索推荐、OCR、视频分析。
- 通用计算服务器:双路CPU、大内存,跑数据库、ERP、Web、虚拟化。
- 存储服务器:高盘位,NVMe和SATA混插,用于数据湖、备份、冷热分层。
- 超融合服务器:计算、存储、网络融合,适合私有云和桌面云。
- 边缘算力服务器:短机箱、低功耗、宽温,放在工厂、门店、路侧。
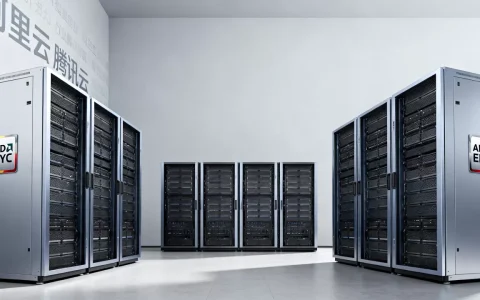
- 整机柜服务器:高密度部署,风冷或液冷,常见于智算中心。
| 类型 | 典型场景 | 关键部件 | 部署提醒 |
|---|---|---|---|
| GPU训练服务器 | 大模型训练、微调 | GPU、NVLink、IB网卡 | 电力、散热、机柜承重要提前算 |
| GPU推理服务器 | 在线推理、视频分析 | GPU、低延迟网卡 | 并发和显存容量优先 |
| 通用计算服务器 | 数据库、ERP、虚拟化 | 双路CPU、大内存 | 内存通道和盘位别缩水 |
| 存储服务器 | 数据湖、备份 | 大容量NVMe/HDD | 关注带宽和冗余 |
| 边缘算力服务器 | 工厂质检、门店AI | 短机箱、低功耗GPU | 宽温、防尘、远程运维 |
GPU训练服务器为什么贵
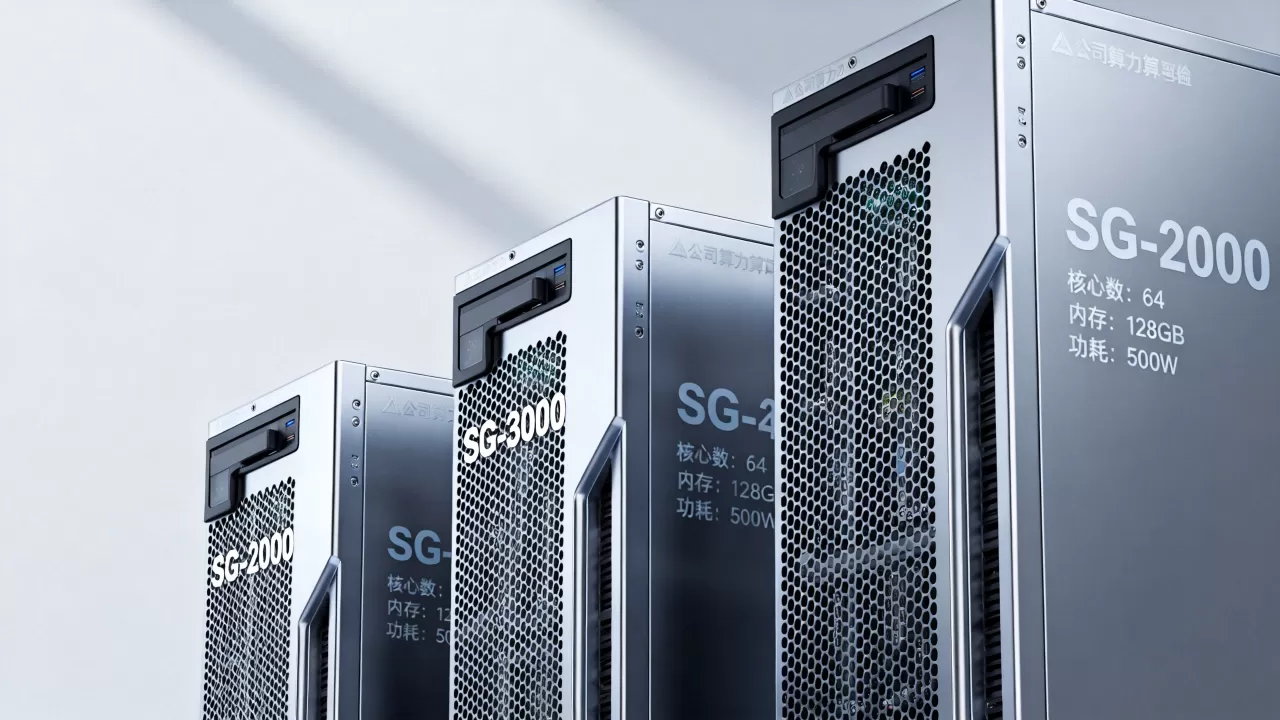
贵的不只是GPU,卡间互联、网卡、交换机、存储和电源都要跟上,业内专家指出,训练集群的瓶颈经常在通信和存储,不是单卡算力,8卡服务器整机功耗高,普通机柜可能带不动,需要确认配电和散热。
推理服务器与训练服务器有啥区别
训练服务器吃FP16/BF16算力,也吃卡间带宽,推理服务器更看重低精度吞吐、显存容量和批处理效率,行业共识认为,推理节点可以适当降低互联规格,但要把并发和延迟测清楚,买之前拿真实业务压测,比看跑分更有用。
公司算力服务器有哪些配置方案?从CPU到网络逐项核对
计算芯片怎么选
- NVIDIA GPU:CUDA生态成熟,训练和推理都常见。
- AMD GPU:ROCm生态在部分场景可用,性价比需要单独评估。
- 国产芯片:昇腾、海光、寒武纪等,适合信创和国产化要求。
- CPU:通用计算看核数、主频、内存通道;GPU服务器也要配够CPU,避免喂不饱数据。
内存、存储与网络
训练节点内存常见到1TB以上,推理节点256GB起步更稳妥,存储至少NVMe做缓存,数据量大就上分布式存储,网络方面,训练集群常用100G/200G/400G RoCE或InfiniBand,推理集群可适当降低。
上架前可以跑这些命令核对:
nvidia-smi:看GPU型号、驱动、显存占用。lspci | grep -i nvidia:确认GPU是否全部识别。nvme list:检查NVMe盘数量和容量。ibstat:检查InfiniBand链路状态。ipmitool sensor:看温度、风扇、电源。dmidecode -t memory:核对内存插法和频率。
电源、散热与机房
8卡GPU服务器常见功耗在数千瓦级,整机柜更高,机房要确认市电、UPS、PDU、承重和散热,液冷适合高密度,风冷适合中小规模,别等设备到货才发现机柜放不下。
AI训练公司算力服务器怎么选?先过四道门槛
模型规模与显存
7B、13B、70B、MoE模型对显存要求不同,先算模型权重、优化器状态、激活值和KV Cache,显存不够,要么加卡,要么做并行,要么上CPU Offload,别只看单卡显存,要看集群总显存和互联效率。
数据吞吐与存储
训练任务经常卡在数据加载,小文件多,先做打包;图片视频多,上对象存储加缓存;Checkpoint频繁,准备高速NVMe池,存储带宽不够,GPU会空转。
框架与国产化
确认PyTorch、TensorFlow、PaddlePaddle和DeepSpeed、Megatron兼容性,国产芯片要核对CANN、ROCm等软件栈版本,业务团队用什么框架,采购就跟着什么生态走。
运维与监控
- DCGM导出GPU温度、功耗、ECC错误。
- Prometheus加Grafana做看板。
- Slurm或K8s做任务调度。
- 日志集中收集,方便定位掉卡和网络抖动。
公司算力服务器租赁价格怎么看?北京上海与中西部对比
价格构成
租赁报价通常包含GPU型号、卡数、租期、带宽、电力、运维和SLA,高端GPU卡溢价明显,长租通常比短租便宜,按小时计费适合实验,按月或按年适合稳定业务。
北京上海与中西部差异
北京上海公司算力服务器租赁价格通常更高,一线城市机房电力、带宽和土地成本高,但延迟低、客户近、生态全,中西部节点电价和气候有优势,适合离线训练、渲染和冷数据备份,选地域时,先把数据合规、网络延迟和预算排个序。
中小企业自建还是租用算力服务器更划算?
短期项目、峰谷波动大、缺运维团队,租赁更省现金流,长期满负载、数据敏感、已有IDC资源,自建总拥有成本可能更低,按三年TCO算:硬件、机房、电力、带宽、运维、折旧、故障停机都算进去。
| 对比项 | 自建 | 租赁 |
|---|---|---|
| 前期投入 | 高 | 低 |
| 现金流 | 压力大 | 按月/按小时 |
| 运维 | 自己负责 | 平台负责 |
| 数据控制 | 强 | 看合同和隔离方式 |
| 适合场景 | 长期稳定、敏感数据 | 短期验证、弹性需求 |
中小企业采购公司算力服务器有哪些渠道?
品牌整机
戴尔、联想、浪潮、新华三、超微、宁畅、中科曙光等都有GPU服务器产品线,优点是售后和兼容性,缺点是同配置价格偏高,采购时让厂商提供上架验收清单和驱动固件矩阵。
云与算力租赁
简米云、华为云、酷番云、UCloud、青云以及各地智算中心都提供GPU云主机和裸金属,适合先验证模型,再决定是否自建,注意问清楚:是否独占GPU、是否有NVLink、存储带宽多少、公网带宽怎么计费。
白牌与二手
白牌性价比高,但要自己把控兼容性,二手GPU服务器便宜,风险在矿卡、维修史和保修,验机可以按这个路径:
- 检查GPU序列号:
nvidia-smi -q | grep -i serial - 跑30分钟压力测试:
gpu-burn或厂商工具。 - 看ECC错误:
nvidia-smi -q -d ECC - 查NVLink:
nvidia-smi nvlink -s - 查IB链路:
ibstat - 查硬盘健康:
smartctl -a /dev/nvme0
合同与验收
合同写清SLA、备件响应、功耗范围、上架服务和退换条款,验收时记录GPU型号、显存、序列号、固件版本和压测结果,别只看开机亮屏。
公司算力服务器部署与验收清单
上架前
确认机柜U数、承重、PDU接口、网络端口、IPMI带外管理,准备好系统镜像、驱动、CUDA或ROCm版本。
压测
GPU跑矩阵计算和通信测试,CPU跑稳定度,内存跑MemTest,硬盘跑fio,网络跑iperf3和NCCL,训练集群重点测AllReduce带宽。
监控与安全
部署DCGM、Node Exporter、Prometheus、Grafana,设置温度、功耗、ECC、掉卡告警,带外管理口不要暴露公网,固件和驱动统一版本,变更留记录。
Q&A:公司算力服务器有哪些常见问题?
公司算力服务器有哪些必须关注的参数?
GPU型号、显存、卡间互联、CPU核数、内存通道、NVMe数量、网卡带宽、电源冗余、机房承重与散热,训练场景还要看NVLink和IB/RoCE,推理场景重点看并发和延迟。
公司算力服务器租赁和自建哪个更划算?
短周期、弹性需求、缺运维团队,租赁更合适,长期满负载、数据合规要求高、已有IDC资源,自建更可控,用三年TCO对比,别只比单卡月租和整机报价。
公司算力服务器一般多少钱?
通用双路服务器多在数万元级,单卡推理服务器从数万元到十几万元,8卡训练服务器常见数十万元级,高端整机柜可达百万元级,租赁按小时或月计费,高端GPU卡溢价明显,最终以厂商报价和当期市场供需为准。
公司算力服务器不是一张配置单,而是一套从场景、算力、网络、存储到运维的匹配方案,先把训练还是推理、自建还是租用、部署地域这三个问题定下来,再谈品牌和价格,基本不会跑偏。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/710214.html