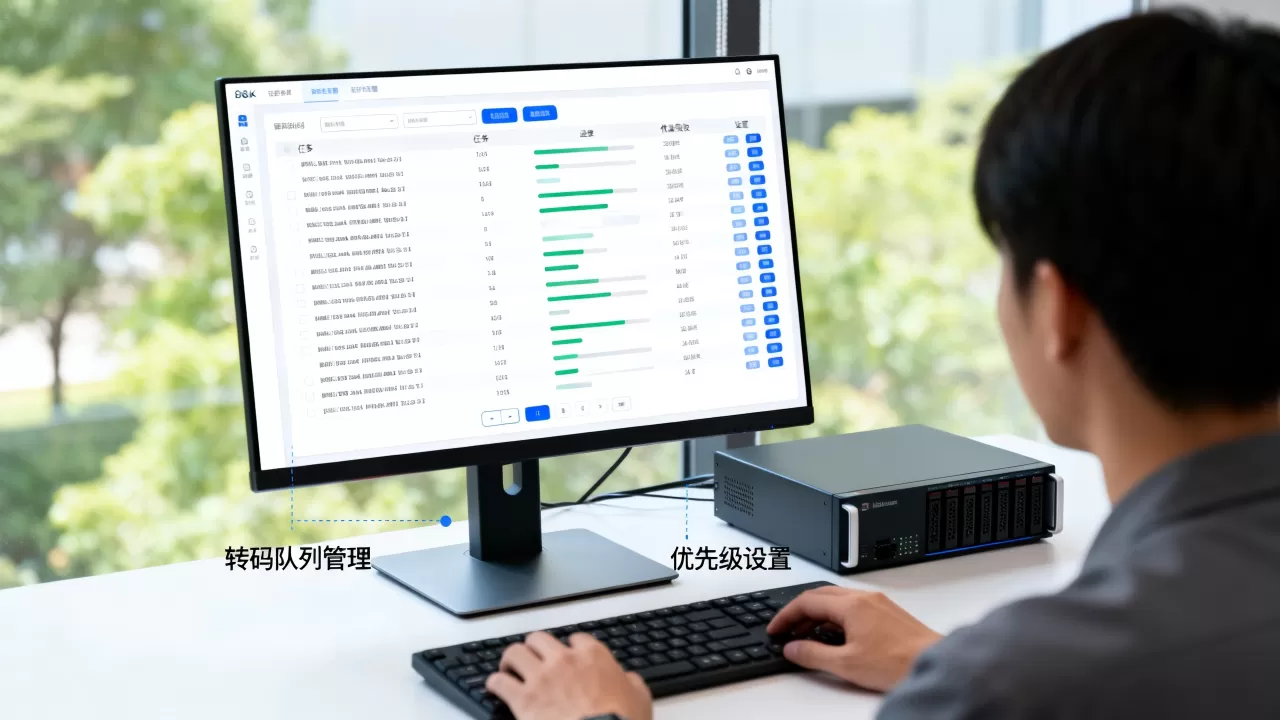
直播回放生成时的转码队列管理,核心结论是:把回放生成和转码执行解耦,按优先级分层入队,用资源池和并发控制隔离重任务,配合重试、死信和监控,才能让队列不堵、成本可控。
为什么直播回放生成时转码队列容易堵
回放生成与实时转码的资源冲突
直播结束那一刻,回放生成任务会集中出现,实时转码还在跑,CPU、GPU、带宽、存储IO都可能被抢占,业内专家指出,直播回放的转码任务往往有突发性,和实时流共享资源时,队列延迟会被放大。
具体场景很常见:一场3小时直播,要切出10个精彩片段,每个片段生成3种清晰度,那就是30个转码任务,如果100场直播同时结束,瞬间就是3000个任务,队列如果按FIFO排,热门回放会被长尾任务堵在后面。
- 回放文件大,转码耗时长。
- 多清晰度、多格式,任务数翻倍。
- 用户点播又要求快速出片。
- 失败重试会进一步放大队列压力。
电商直播回放生成时转码队列管理:如何应对大促洪峰
电商大促后,回放生成量会明显上涨,主播下播,运营要切片、生成HLS、做多码率,还要给商品卡关联视频,行业共识认为,队列管理要区分SLA,热门回放优先,长尾回放可延迟。
可以这样分:
- 热门回放:5分钟内出片,进P0队列。
- 普通回放:30分钟内出片,进P1队列。
- 归档回放:低峰期处理,进P2队列。
- 失败重试:单独队列,避免拖累正常任务。
据工信部公开信息,国内直播用户规模大,回放需求持续增长,队列管理不做分级,大促后很容易出现“热门回放转不出来,长尾任务占着机器”的情况。
直播回放转码队列管理怎么优化:从入队到出队的实操路径
任务分级:热门回放和长尾回放别挤一条队
用Redis或RabbitMQ做优先级队列,Redis可以用ZADD,score越小优先级越高:
ZADD transcode_queue 1 task_id_p0
ZADD transcode_queue 5 task_id_p1
ZADD transcode_queue 10 task_id_p2
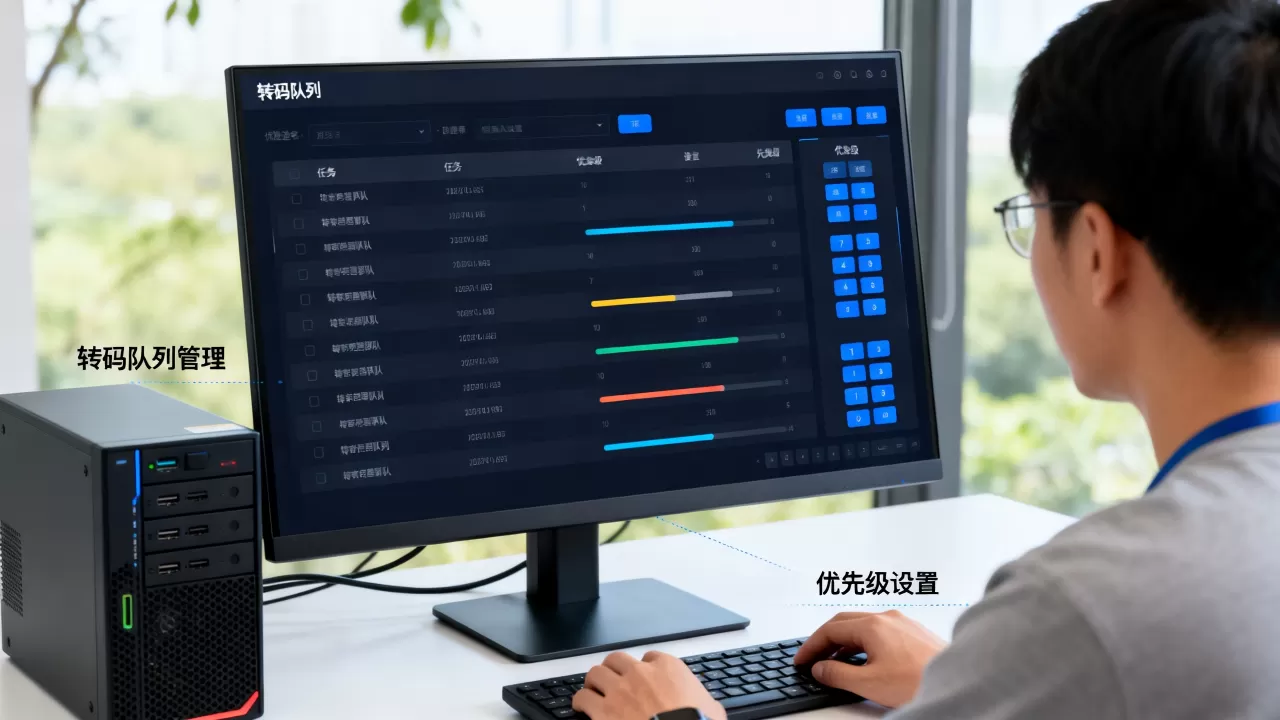
消费者用ZPOPMIN取任务,RabbitMQ则用x-max-priority,声明队列时设置最大优先级。
- 入队时打标:业务方传priority字段。
- 限制单用户并发:避免一个主播占满队列。
- 设置队列长度上限:超过阈值就降级或延迟。
- 保留审计字段:任务ID、回放ID、清晰度、重试次数。
并发控制与资源池:GPU、CPU、云端实例怎么分配
按转码类型分池,别让所有任务抢同一批机器。
- GPU池:H.264/HEVC硬件转码,适合高并发短任务。
- CPU池:AV1软编、复杂滤镜,适合长任务。
- 云端弹性池:突发流量,按需扩容。
- 实时转码池:独立资源,不参与回放队列。
K8s里可以这样扩缩容:
kubectl autoscale deployment transcoder-gpu
  --cpu-percent=70 --min=2 --max=20
但GPU利用率更准,可以用Prometheus Adapter按DCGM指标扩缩,每个池独立队列,设置max_concurrent,比如单GPU同时2到4路,预留资源给实时转码,别让回放把直播也拖垮。
重试、死信与幂等:避免失败任务拖垮队列
失败任务如果无限重试,队列会被拖死,要做幂等、退避和死信。
- 幂等:任务ID唯一,Redis SETNX加过期时间。
- 重试:指数退避,1秒、2秒、4秒、8秒,最多3到5次。
- 死信:RabbitMQ设置DLX,Kafka设置重试主题。
- 告警:死信队列有消息就通知。
- 失败分类:源文件损坏、转码器崩溃、存储超时。
FFmpeg命令示例:
ffmpeg -i input.flv
  -c:v libx264 -preset veryfast -crf 23
  -c:a aac -f hls -hls_time 6
  -hls_list_size 0 output.m3u8
加超时控制,限制线程数,输出临时目录再原子移动,别让半成品文件被播放器读到。
监控与告警:看哪些指标才算有效
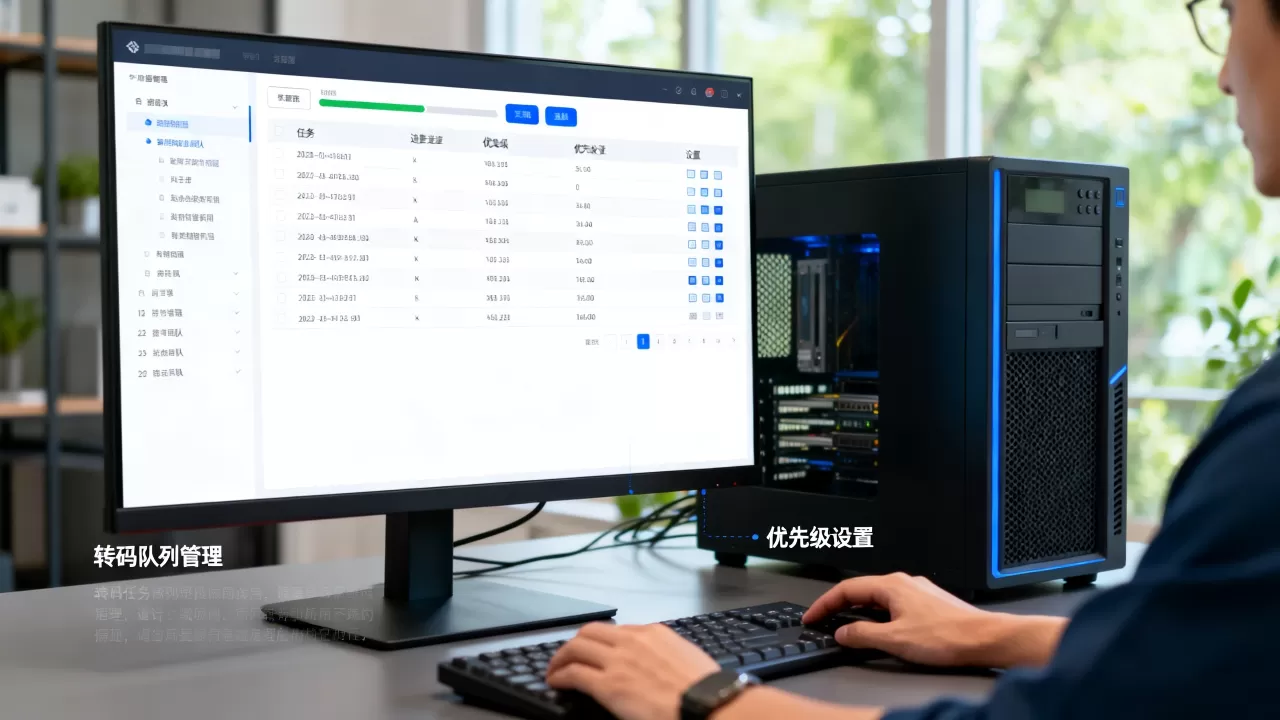
队列管理不能只看队列长度,要分层看指标。
| 指标 | 观察重点 | 异常动作 |
|---|---|---|
| 队列长度 | 分P0、P1、P2看 | P0积压立即扩容 |
| 等待时间 | P95、P99 | 超过SLA就降级 |
| 转码成功率 | 按清晰度分组 | 失败率高查源文件 |
| GPU利用率 | 显存和编码器 | 过低查调度,过高扩容 |
| 重试次数 | 单任务重试 | 超过上限进死信 |
| 端到端延迟 | 回放生成到可播放 | 延迟大查存储和CDN |
PromQL可以这样写:
histogram_quantile(0.95, rate(transcode_wait_seconds_bucket[5m]))
本地部署和云转转码队列管理区别:选型与成本对比
本地部署和云转转码队列管理区别
| 维度 | 本地部署 | 云转 |
|---|---|---|
| 资源弹性 | 差,需提前采购 | 好,按需扩容 |
| 成本 | 前期高,长期可能低 | 按量付费,突发贵 |
| 运维 | 自己维护 | 云厂商托管 |
| 数据合规 | 可控 | 依赖云厂商 |
| 延迟 | 内网低 | 受网络影响 |
| 适合场景 | 稳定量大 | 波动大、快速上线 |
本地部署适合长期稳定、数据敏感、有运维团队的业务,云转适合波动大、想快速上线、不想买硬件的团队,混合方案也常见:热门回放本地转,长尾回放云上跑。
直播回放转码队列管理多少钱:成本构成与节省思路
成本主要包括GPU实例、存储、流量、消息队列、运维人力,价格因地域和配置差异大,北京地域因机房和带宽成本,通常比中西部略高,云GPU实例每小时从几元到几十元不等,具体看卡型和地区。
节省思路:
- 低峰批量转码,避开高峰。
- 用竞价实例跑长尾任务。
- 热门回放预转码,长尾按需转。
- 冷回放只存源文件,不预转。
- 限制最高码率,减少不必要的4K。
- 设置队列TTL,过期任务直接丢弃。
北京直播回放转码队列管理方案的地域考量
北京用户多,带宽质量要求高,可以把转码集群放北京或环京机房,回源快,但成本高,混合方案更实际:热门回放北京转码,长尾放中西部低成本区。
- 使用对象存储跨区域复制。
- 队列跨地域同步用Kafka MirrorMaker。
- 调度器按地域标签选择资源池。
- 注意跨地域传输费用。
- CDN回源策略要和转码输出位置匹配。
直播回放生成时的转码队列管理,不是加机器就能解决,先分级、再隔离、后弹性,配合幂等和死信,队列才稳,把热门回放和长尾回放分开,把实时和离线资源分开,成本和质量才能平衡。
直播回放转码队列管理常见问题解答
直播回放转码队列积压怎么快速恢复?
先扩容消费者,再降级非核心任务,暂停归档队列,把资源让给P0热门回放,检查死信队列,修复失败任务,如果源文件有问题,直接标记失败,避免无限重试。
直播回放转码队列管理需要哪些中间件?
常用Redis、RabbitMQ、Kafka,Redis适合轻量优先级队列,RabbitMQ有优先级和死信,Kafka适合高吞吐、分区、重放,选型看团队熟悉度和规模,小规模用Redis,大规模用Kafka加独立调度器。
小团队如何低成本管理直播回放转码队列?
用云函数或容器跑FFmpeg,消息队列用云托管版,按优先级分两个队列,热门和普通,设置最大并发和重试上限,监控队列长度和失败率,冷回放不预转,用户点播时再触发。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/714337.html