监控服务器的内存和CPU使用率,核心方法分三类:登录服务器直接查看实时状态、部署监控工具采集历史趋势、利用云平台自带监控告警。 对绝大多数运维场景来说,先掌握Linux系统内置命令解决当下问题,再根据服务器规模选择合适的监控方案,是最务实的路径。
Linux服务器如何监控CPU和内存使用率
服务器操作系统以Linux居多,登录服务器执行命令是最直接、零成本的监控手段,也适合临时排查故障时快速定位问题。
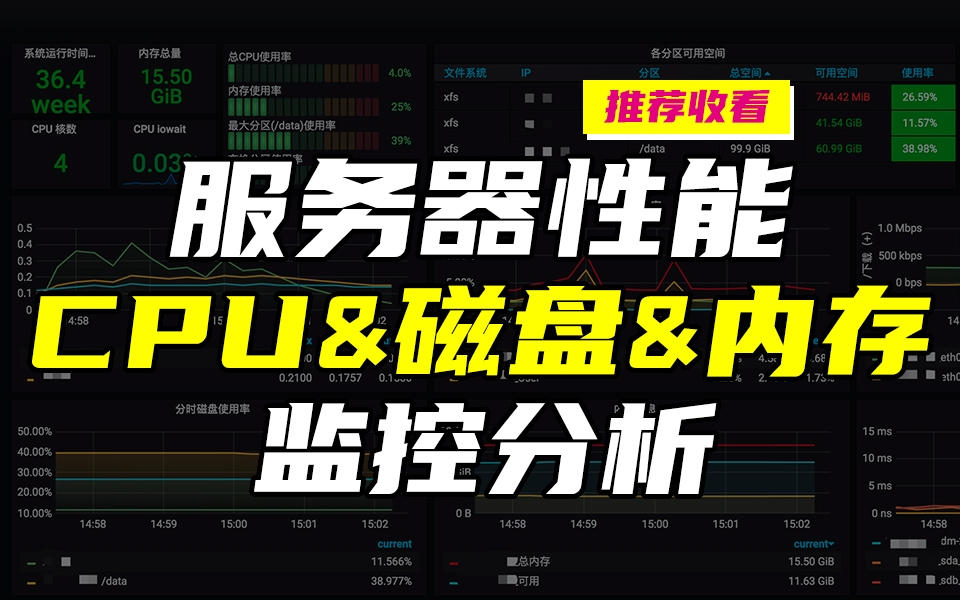
用top命令实时查看负载
在终端输入top回车,屏幕上半部分展示系统概况。CPU使用率看%Cpu(s)这一行,其中us表示用户进程占用,sy表示系统内核占用,wa代表I/O等待,id是空闲比例,内存看KiB Mem这一行,关注total总容量、free空闲值、used已用值以及buff/cache缓存占用。
需要留意的是,Linux系统会尽量把空闲内存用作文件缓存,所以free显示的数字很小不代表内存不足,判断内存是否紧张,更要关注available这个指标,它表示当前实际可分配给新程序的内存。
使用top命令时,按Shift + M可以让进程按内存占用排序,按Shift + P按CPU占用排序,进程列表中的%CPU列如果持续超过100%,说明该进程消耗了超过一个CPU核心的计算资源。
free和vmstat命令查看内存详情
输入free -h,系统会以人类易读的G为单位显示内存信息。重点关注available列,它比free值更真实地反映可用内存,当available持续低于总内存的10%时,服务器就可能面临内存不足风险。
vmstat 1 5命令适合连续观察系统状态,间隔1秒输出5次结果,重点关注r列(运行队列),如果长期大于CPU核心数,说明CPU资源严重过载;si和so列代表从磁盘交换内存页的数据量,数值持续非零说明物理内存告急,系统正在用磁盘充当内存,性能会大幅下降。
配合查看进程级资源占用
当服务器出现卡顿,执行ps aux --sort=-%cpu | head -20能直接列出CPU占用最高的前20个进程,同样可以用ps aux --sort=-%mem | head -20查看内存占用排行,这种按需精准定位的排查思路,效率远高于逐个观察进程列表。
怎么监控服务器cpu使用率和内存的中长期趋势
命令行适合查看当下瞬间,但业务流量有高峰期和低谷期,服务器是否存在规律的资源瓶颈,需要通过持续监控采集数据来分析,手动执行命令不具备持续性,部署专业的监控工具是主流方案。
Prometheus加Grafana组合监控方案
这套组合是目前行业内最流行的开源监控方案。Prometheus负责每隔15秒采集一次服务器的CPU和内存数据,Grafana负责把数据以图表形式可视化展示,第一次配置确实有一定难度,但配置完成后可以长期稳定运行,还能接入钉钉、企业微信等实现告警通知。
具体流程是:在服务器上安装node_exporter组件,它暴露/metrics接口供Prometheus抓取数据,然后在Prometheus配置文件中添加采集任务,最后在Grafana中添加Prometheus数据源并导入仪表盘模板,之后就能看到CPU使用率的折线图、内存使用量的趋势图,还能按时间范围回溯历史数据。
宝塔面板适合中小规模的轻量监控
如果服务器数量不多,又不想折腾配置文件,宝塔面板提供了开箱即用的监控功能,在软件商店安装宝塔后,后台首页会实时显示CPU和内存的当前数值,也可以在“监控”页面查看过去几天甚至一个月的历史趋势图表,还能手动设置告警阈值,当CPU使用率超过90%时自动发送通知。
这种方式上手成本很低,图形化界面直观,对单台或少数几台服务器的监控足够用,缺点是监控精度和可定制性不如开源方案,数据存储时间也有限制。
行业共识对于工具选型有明确倾向
监控工具的选择不必过分纠结,多数情况下,监控项丰富度、告警及时性和数据存储时长是三个核心衡量标准,中小团队优先考虑部署效率,大型业务则更关注监控体系的扩展性和统一管理能力。
云服务器CPU内存监控方案哪个好:自建与云平台对比
使用简米云、酷番云等云服务器时,用户会面临一个选择:直接用云平台监控,还是自建监控系统,两者各有优势,取决于业务实际需求。
云平台自带监控的优势与局限
简米云的云监控、酷番云的云监控都提供了免费的基础监控能力,控制台可以查看CPU使用率、内存使用率的图表,支持设置阈值告警,通过短信和邮件通知。这种方案的优势是零部署成本,开通云服务器就自带监控,且数据采集稳定性由平台保障。
局限性也比较明显:基础版的监控数据只保留1个月(具体以各家云厂商控制台说明为准),图表粒度偏粗,告警规则相对简单,对大多数中小网站站长来说,这个方案性价比最高,也完全够用。
自建监控系统解决多云统一管理问题
自建监控系统的价值主要体现在两个场景,一是服务器分散在不同云厂商甚至包含物理机,需要一套统一监控界面把所有服务器纳管起来;二是需要对告警规则做复杂定制,比如连续5分钟CPU高于85%才触发告警,并且自动执行重启应用等操作。
行业数据指出,有一定规模的企业用户更倾向于自建监控体系,以便数据自主可控,不受云厂商的存储限制。
服务器cpu内存监控脚本和告警配置实战
如果你不想安装整套监控软件,写一个简单的Shell脚本周期检查系统资源,是轻量又灵活的替代方案。
制作一个简单的监控告警脚本
#!/bin/bash
cpu_threshold=80
mem_threshold=90
cpu_usage=$(top -bn1 | grep "Cpu(s)" | awk '{print $2}' | cut -d'%' -f1)
mem_usage=$(free | awk '/Mem/{printf "%.0f", $3/$2100}')
if [ $(echo "$cpu_usage > $cpu_threshold" | bc) -eq 1 ]; then
    echo "CPU使用率过高: ${cpu_usage}%" >> /var/log/resource_monitor.log
fi
if [ $(echo "$mem_usage > $mem_threshold" | bc) -eq 1 ]; then
    echo "内存使用率过高: ${mem_usage}%" >> /var/log/resource_monitor.log
fi
这段脚本逻辑很简单:获取当前CPU和内存使用率,与阈值比较,超过阈值就记录到日志,配合crontab定时任务,添加
/5 /opt/monitor.sh,每5分钟自动执行一次。
配合企业微信机器人推送告警
光记日志还不够及时,可以结合企业微信的群机器人实现告警推送,把脚本中的日志记录替换成curl命令,向机器人Webhook地址发送JSON格式的消息,就能在手机上实时收到CPU或内存告警通知。
实际操作时,可以根据服务器具体配置调整阈值,内存充足的服务器可以把内存阈值适当调高。
监控部署后的验证动作不可省略
部署完成后,不要直接依赖脚本或监控平台显示的数据,主动做一次压测验证是行业内普遍认可的做法,用压力测试工具人为制造高负载,确认告警能正常触发,避免真正故障时监控静默失效,同时对比监控工具采集的数据与top命令实时数据,偏差较大时应检查采集间隔设置是否合理。
常见问题解答
怎么查看Linux服务器历史某时刻的CPU内存使用率?
如果没有提前部署监控工具,历史数据无法追溯,系统日志、进程日志都可能被轮转清理,只有部署了Prometheus、Zabbix或云监控等持续性采集工具,才能回溯查看历史时间点的资源使用情况,云平台监控通常提供30天内的数据回溯能力,开源监控方案的数据保留期限取决于存储配置。
CPU使用率不高但服务器响应很慢,如何排查?
资源瓶颈不只在CPU和内存,还需要关注磁盘I/O和网络带宽,执行iostat查看磁盘读写等待时间,dstat综合观察系统各项资源,负载高而CPU空闲的场景多半是磁盘I/O阻塞或程序锁等待导致,数据库服务经常出现这种现象,全表扫描或慢查询会拖垮磁盘I/O,CPU却在等待队列中闲置。
如何从多台服务器中快速找出CPU使用率最高的那台?
登录每台服务器执行命令逐一查看效率低下,可以在监控系统中添加按CPU使用率排序的主机视图,开源方案可用Grafana的主机列表模板直接排序展示,云平台控制台也有资源列表页显示每台实例的CPU监控曲线,设置分级告警策略,优先对CPU长期处于高位的服务器配置告警,就能在问题初期收到通知。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/714509.html